一张去年报销的发票存在 NAS 里。你记得抬头和金额,就是不记得文件名。搜索框只认文件名,翻了三层目录,最后靠按日期排序才把它翻出来。
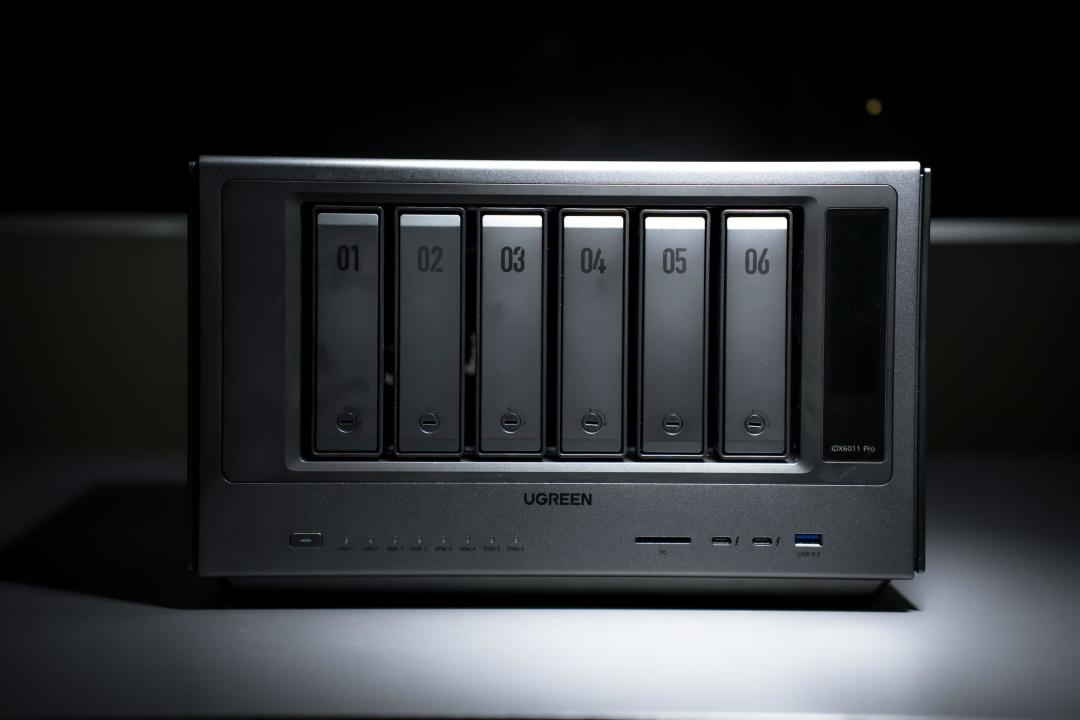
厂商对这类问题的答案,是往 NAS 里塞一台电脑。绿联 9 月发布的 iDX6011 Pro,Ultra 7 255H,96 TOPS 综合算力,64GB LPDDR5x 内存。存储吧快科技
机身给到双雷电 4 和双万兆。系统里直接内置本地大模型和 Uliya 助手。官方原价 19999 元,首发 15999 元。果仁儿科技快科技
极空间的 9 月更新更进一步:Skill 允许 AI 在授权范围内直接操作文件和系统功能,Z425、T6 上还有 Agent Zeno,把对话、模型调度、设备操作收进一个入口。万象商报
看上去,本地 AI 的门槛就是算力。另一台机器给了相反的答案。
一台总内存 3811MB 的老 NAS,日常已用掉 1987MB。
先试三亿参数的 embedding 模型:加载 9 秒,常驻 1GB 内存。索引时 CPU 打满,swap 开始抖,请求直接超时。哔哩哔哩
换成 bge-small 的 q8 量化版,512 维,文件 25.2MiB,15 个片段 41 秒建完索引,一次检索 1.9 秒,全程离线。B站
差别不在模型聪不聪明,在任务本身。语义搜索只做一件事:把文字变成向量,再算距离。它不生成回答,不需要几百亿参数。装得下,就能跑。
但 26MB 只是权重。输入一长,中间激活会继续吃内存;向量索引也占地方。权重小,不等于占用小。
这台机器能跑,是因为它一次只处理很短的片段。照片另算:图像要另一套 embedding,或者交给厂商的 AI 相册。
时间账也得算。41 秒建 15 个片段,平均一个 2.7 秒。一万个片段就是七个多小时。
查询 1.9 秒很轻,建库很重。老机器不是不能做,是要把索引放在夜里跑,之后只做增量。
另一台 N5105、8GB 内存的绿联 NAS,把这个问题暴露得更彻底。0.6B 的向量模型一上,进程直接被系统 kill。设计虱聊科技
换成更小的模型,OOM 消失,四个核还是跑满,响应拉到几十秒。把 Ollama 的线程从 4 降到 2,才稳住。
更值得抄的是它的策略。两千多条历史消息全量向量化,要跑好几天;先让模型生成摘要,再向量化摘要,只剩 150 条,几十分钟完成。知乎
花几天给图书馆编目,结果九成是空白笔记本,这种事在 NAS 上很常见。
那 64GB 和 96 TOPS 白卖了吗?也没有。只“查”,26MB 够;要“做”,差得远。
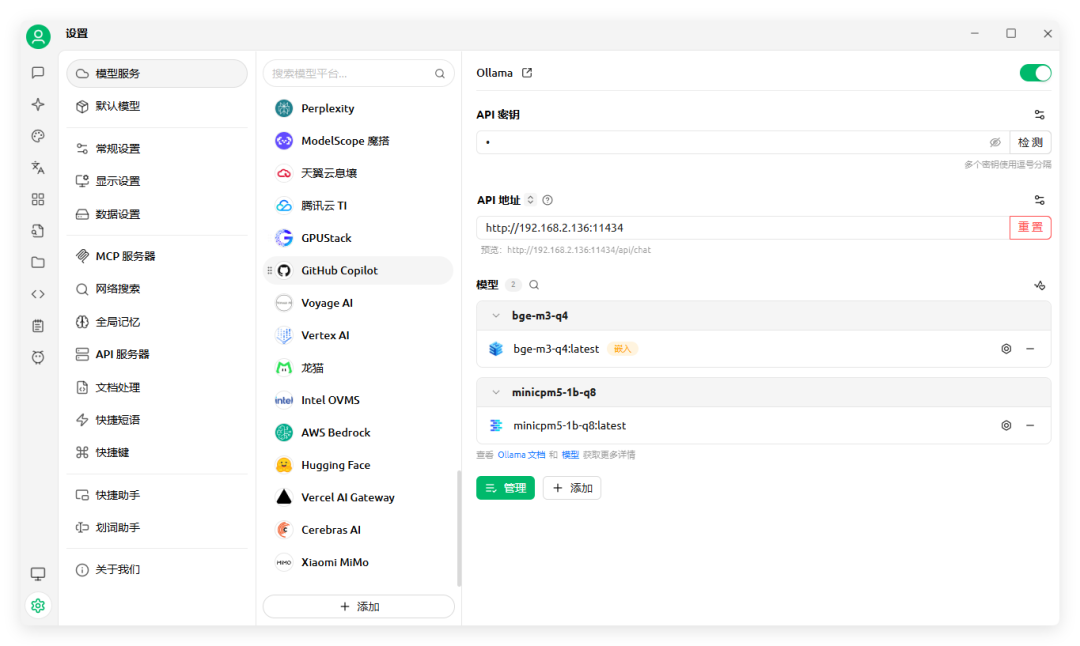
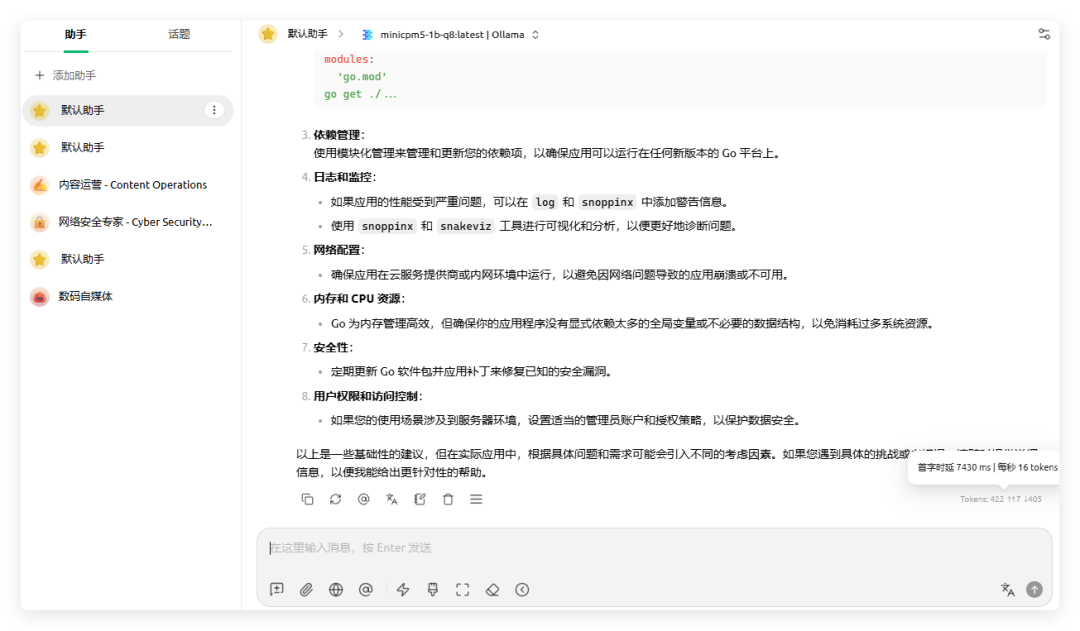
同一条 CPU 路线,N150 配 16GB 内存跑 1B 的小模型。首字延迟 7.4 秒,每秒 16 个 token。演示够用。可爱的小Cherry
让它连着查目录、读文件、整理归档,每一步都要等。
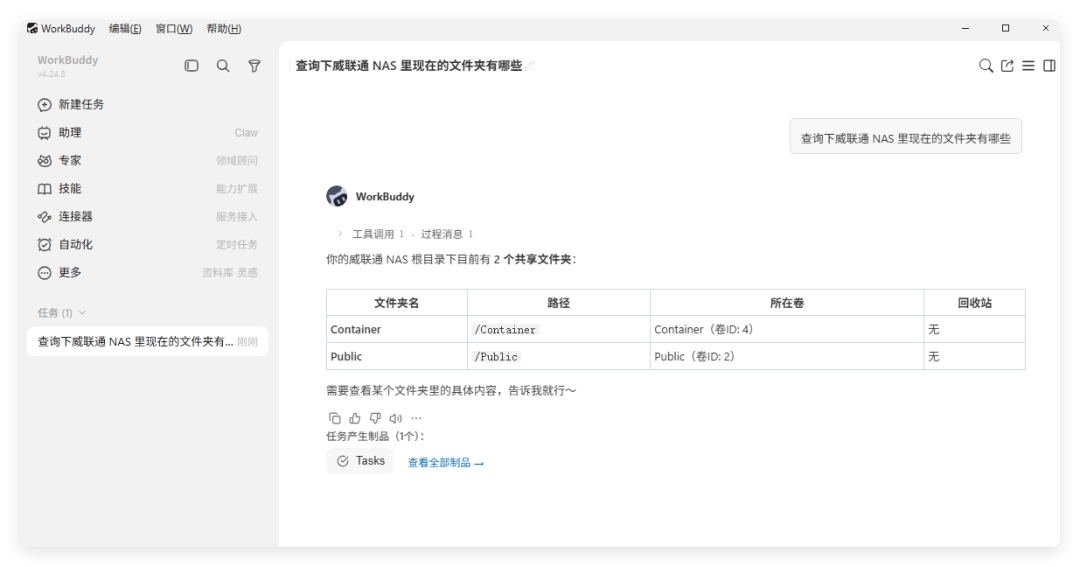
厂商堆大内存和大算力,买的是大模型装得下、多用户同时用、Agent 多步任务不排队。
所以先看内存,再谈需求。2GB 以下,别在本地跑模型,用云端接口;2 到 8GB,26MB 级别的检索模型,做“按意思找文件”够用。
8 到 16GB,1B 模型能跑,但按那台 N150 的速度,多步任务要等;16GB 以上,再考虑让 Agent 真正干活。
真正该问的不是 AI NAS 值不值,而是你要它查,还是要它做。这两笔硬件账,不在同一页上。