从10月5日到14日这十天,盯着A卡本地AI的人,大概刷到了不下七八波动静:AMD先为ROCm 10.1发了Windows专属计算驱动,只带RX9000/RX7000两个系列,官方话术干脆是"游戏玩家别更"。紧接着开源项目HelixSR让A卡跑起了DLSS同源的超分模型,MiniCPM新作AMD Day0适配,AMD的Token Factory每天刷新免费token额度,B站UP主又发出了ROCm 10.1升级实测,Qwen3.8-Flash-Next提速明显。华擎官号也把AMD推ROCm驱动的新闻第一时间转了一遍。网易哔哩哔哩微博
硬件侧呢,卡价依然让人想再等等。涨价的账大家已经算了无数遍,但软件侧在十月上旬这一周密集补进度,是这轮里真正新的东西。这篇替华擎9070XT、R9700这些卡的持有者和观望者把这十天盘点清楚:哪些是事实,哪些是个例,看完再回答那个老问题——“我的A卡到底能不能干AI”,以及该不该为它多花钱。
十天名单:先把时间线摆正
8月29日:ROCm 10发布,跳过8、9两个版本号从7.14直接升级到十代,官方给出推理性能最高3.3倍的数据(测试平台是8张MI355X),Windows侧退役独立HIP SDK、改与Linux一致的ROCm Core SDK——这是理解本月一切更新的底稿。快科技
10月5日:AMD发布适配ROCm 10.1的Windows专属显卡驱动(版本号26.10.41.05),仅支持RX9000/RX7000系;ROCm 10.1本体引入ROCm CLI、支持LLVM 24、hipThreads加速,并把WSL2支持推进到技术预览阶段。
10月8日:新版Adrenalin驱动向RX9000系列、RX7900/7800/7700/7600系列和Radeon AI PRO R9700推送,不包含任何游戏改进,仅补齐ROCm 10.1支持;华擎等板卡厂对应的RX7000老卡用户第一次被明确写进官方ROCm叙事。IT之家
10月9日:Phoronix用Lemonade在两台设备上对比:System76工作站(Radeon AI PRO R9700)和Framework Desktop(Ryzen AI Max+ 395)。同一设备、同一模型只换后端——Qwen3-14B编码场景,ROCm首包更快,Vulkan吞吐接近1.5倍;Qwen3.5-14B上,Vulkan吞吐是ROCm的3倍。知乎
10月9日:海外博主"MI50白菜价上车AI、千元跑235B大模型"的实测中字流出。哔哩哔哩
10月11日:HelixSR——不装N卡驱动、不需要CUDA和ROCm、也不依赖卡上AI单元,DLSS的CNN超分模型在A卡上跑通,《无限暖暖》PC端已有成功案例。
10月12日:中字视频:老外拿AMD核显硬跑70B大模型,输出全是乱码。
10月13日:MiniCPM-V-4.7宣布AMD Day0适配,B站同期演示AMD开发者计划的Token Factory——开发者计划注册即有每天刷新的免费token额度。哔哩哔哩
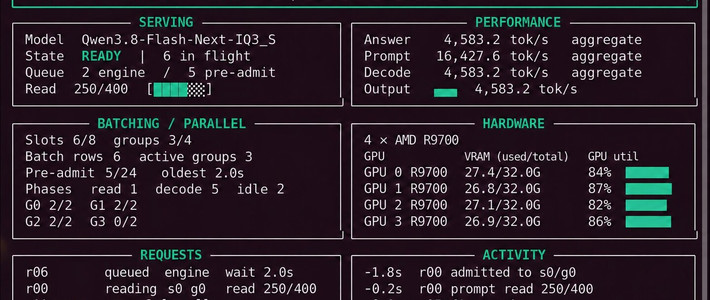
10月14日:ROCm 10.1升级实测:Qwen3.8-Flash-Next本地吞吐明显提速。
A卡游戏内容端的火也没停:9月24日那条"自己生成自己,A卡本地模型跑AI大电影"的B站视频已经10万+播放、2000多赞;9月初,"9070XT上哪个量化27B真正能实用"的五连测和"两天评测全记录"生产级配置贴,已经把16G显存跑27B的可行性反复验证过。
去噪:三件别先上头的事
第一,ROCm 10.1进名单是好事,但它补的是"官方支持",不是"体验追平N卡"。RX9000/RX7000/AI PRO都齐了,Windows也有专属驱动,WSL2也推进到了技术预览阶段。但同周的Phoronix数据反而提醒我们:在Llama.cpp、Lemonade这类社区引擎里,Vulkan后端的吞吐量经常比ROCm更快,ROCm只赢了首包响应。换句话说,这个月真正影响你出词速度的,先是"选哪个后端",其次才是"驱动升没升"。另外注意驱动分线:Windows那枚计算驱动官方明说"游戏玩家别更",它是给算力和AI负载准备的,不面向游戏优化,装之前想清楚这台机器的用途。IT之家知乎
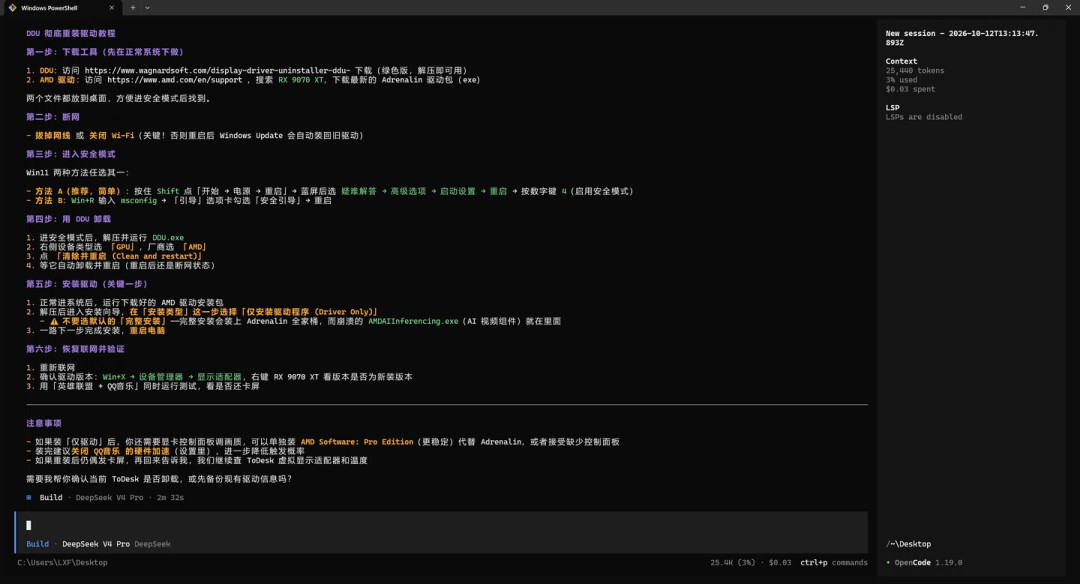
第二,HelixSR是社区项目。它的卖点是"通用"——不碰CUDA、不碰ROCm、不靠AI单元,换来的代价是没有官方兼容性名单。单机游戏值得试,别拿它去对网游和带反作弊的大作,也别指望新游戏发售第一天就能开。哔哩哔哩
第三,“千元235B”(MI50)和"70B乱码"(核显)是两个极端,都不能拿来代表你的卡。MI50是数据中心老架构、没有显示输出,整机折腾成本早就不是"白菜价"三个字能概括;乱码事故发生在核显端。中间的真实位置是:9070XT 16G、RDNA4、有官方驱动入口,27B量化可用有B站连续多期实测背书——不神话,也不冤枉。顺带一提,小红书上这两天也有"9070XT到货当天掉驱动"的原声吐槽和修复作业帖。掉驱动属于Adrenalin游戏驱动线的稳定性话题,别和ROCm计算驱动混为一谈,更别拿它当"A卡不能AI"的证词。小红书
看懂风向:华擎官号自己都开始算账了
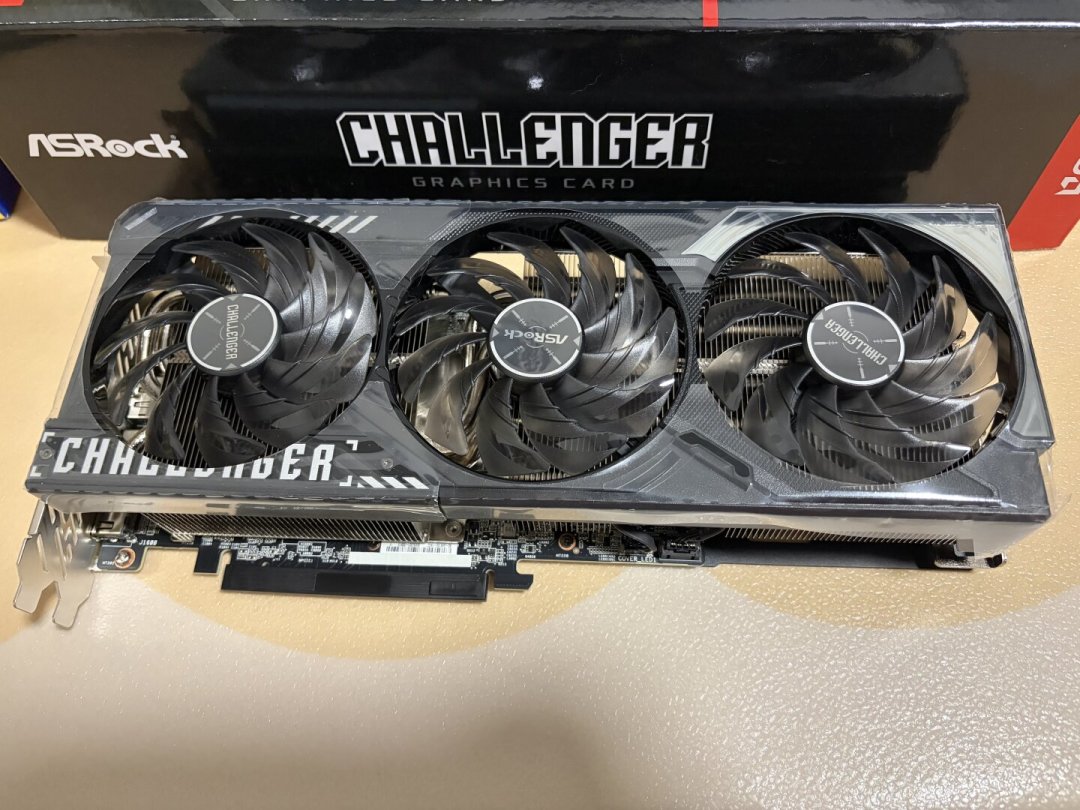
更有意思的信号来自品牌自己。华擎官号最近两篇头条,一篇是《本地模型部署实测从19到185tok/s,AMD R9700 32GB单双卡排坑指南》,一篇是《同样的卡,两倍的产能:在部署上调优花的每一个小时,比一张新卡划算》。过去这个号的内容是装机秀、抽奖和周二特惠,现在改讲tok/s曲线和部署调优,连AMD推ROCm驱动的新闻也第一时间转载。官号的内容结构,就是品牌对自家用户盘子的判断:它显然认为,买这条线显卡的人里,跑本地模型的占比在上升,纠结点已经从"能不能跑起来"挪到"怎么跑得快"。这跟AMD软件栈这十天的动作(消费端双驱动线、开发者端免费算力、企业端直通存储和跨代版本号)拼起来读,就是一句话:软件侧开始把A卡AI当主流场景来伺候,不再只当极客试验田。微博
四类人,四个答案
已经手持华擎9070XT的:别为AI换卡。游戏归Adrenalin,想跑本地模型再单独装那枚计算驱动,别混着更;照B站公开作业验证27B量化档即可。游戏侧想尝DLSS类超分,只在单机开,网游先别碰。
手里是RX7000老卡的:这轮名单里最被照顾的反而是你们——7900/7800/7700/7600全进了ROCm 10.1支持列表。24G的7900XTXE本身就是丐帮跑大模型的老牌方案,先装计算驱动、用Llama.cpp Vulkan后端跑一遍,再决定要不要为"更大显存"追加预算。
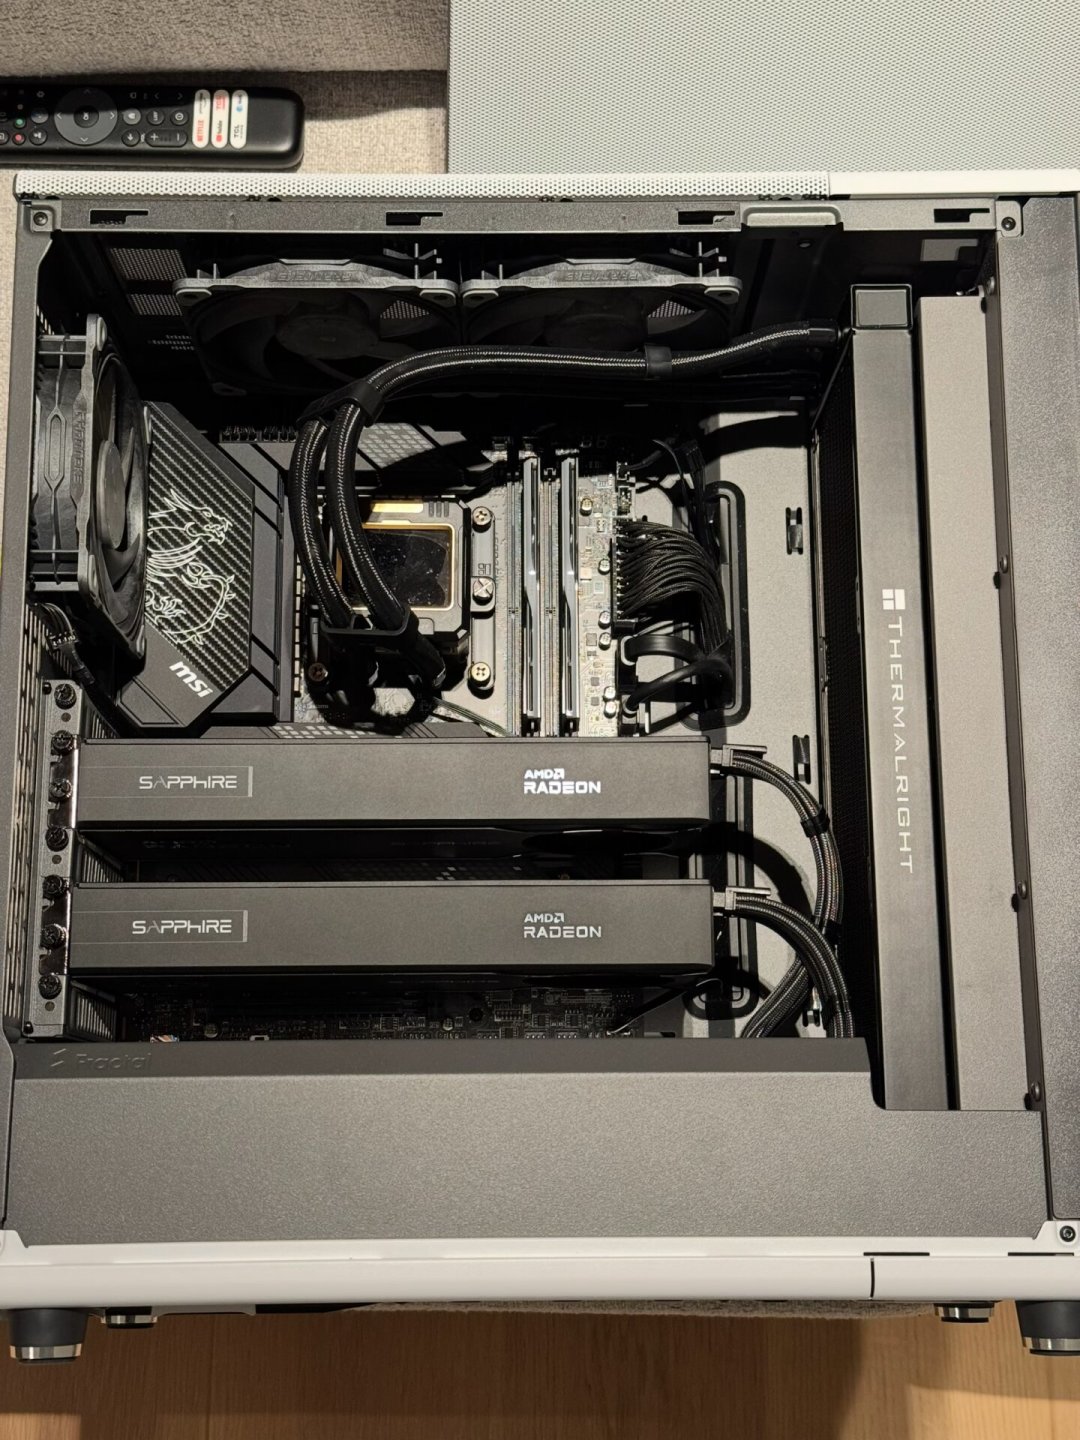
在犹豫要不要上R9700 32G门票的:先用现卡在同一模型、同一量化下把ROCm和Vulkan两个后端各跑一遍曲线,再决定加不加第二张卡。官号那句话在这个场景成立:同样的卡,调优的收益常常大于加钱。微博
想低成本入门、手里还没卡的:先别接MI50和矿渣。AMD的Token Factory免费额度够你把目标模型走通一遍;真要在卡上跑,Datawhale实测过教程的坑——云实例出口代理会拒绝部分官方源的wheel包,照抄第三步必失败。流程跑通,再谈硬件投入。知乎
动作和继续观察的信号
本周该做的:想跑AI就装计算驱动、游戏机就守Adrenalin,同一模型同一量化把ROCm和Vulkan各跑一遍,记下自己的数字,再谈买不买。继续盯三个信号:WSL2技术预览会不会转正——那是"Windows跑ROCm"最后一公里;像MiniCPM-V-4.7这样的Day0适配会不会变成新模型常态——Day0是生态速度最诚实的指标;以及涨价潮会不会把卡价抬过软件红利——如果软件一直在补、价格一直在涨,“为AI买卡"就得改口成"用手里的卡先回本”。
最后给丐帮一句:A卡的短板从来不在硅片,在软件。这个十月,软件侧的坑正一周一周被填。要不要上车,已经不是"A卡能不能AI"的问题,而是你愿不愿意花一个周末,把驱动装对、教程踩完、把自己的吞吐账算清楚的问题。