














15
14
Gemini 4 Argon跑分登顶,为什么实际交付还会翻车?
2026-10-17 23:32:45
0点赞
0收藏
0评论
Gemini 4 Argon跑分登顶,为什么实际交付还会翻车?
“北美大豆包”这句吐槽,放在 Gemini 身上,最扎心的地方就是:回答写得头头是道,真把活交过去,却还得自己收尾。代码能不能跑、文案有没有乱加承诺、报告结论靠不靠谱,用过之后才知道。如今 Gemini 4 Argon 登上榜首,它能不能让人少返工,比排名更值得看。
谷歌的 Gemini 4 Argon 在 10 月 13 日扩大开放。发布后的英文测评给出了一个值得注意的反差:综合榜单成绩很强,具体任务的成品却未必能直接交付。
这篇把榜单、做对的案例、同题生成结果和使用者反馈放在一起看。下文实测均由对应测评者完成,不是卡洛研究所自行复测;资料更新至 2026 年 10 月 15 日。
目录
01|榜单第一,具体意味着什么
02|从分析到成品,哪些地方拉开了差距
03|跑分与体验为什么会错位
04|要不要换模型,先验收自己的任务
01|榜单第一,具体意味着什么
先承认它的成绩。Vals AI 在 2026 年 10 月 13 日更新的 Vals Index 中,将 Argon 排在第一,得分 68.90%;随后是 Claude Sonnet 5.5 的 67.04% 和 Claude Opus 5.5 的 66.97%。
这个指数覆盖金融、编程、法律和税务任务,并按各行业在美国 GDP 中的占比加权。它提供的是一组专业任务的综合表现,不是“任意工作都能做对”的承诺。
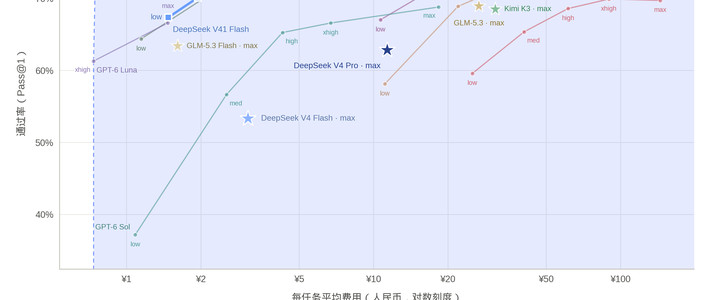
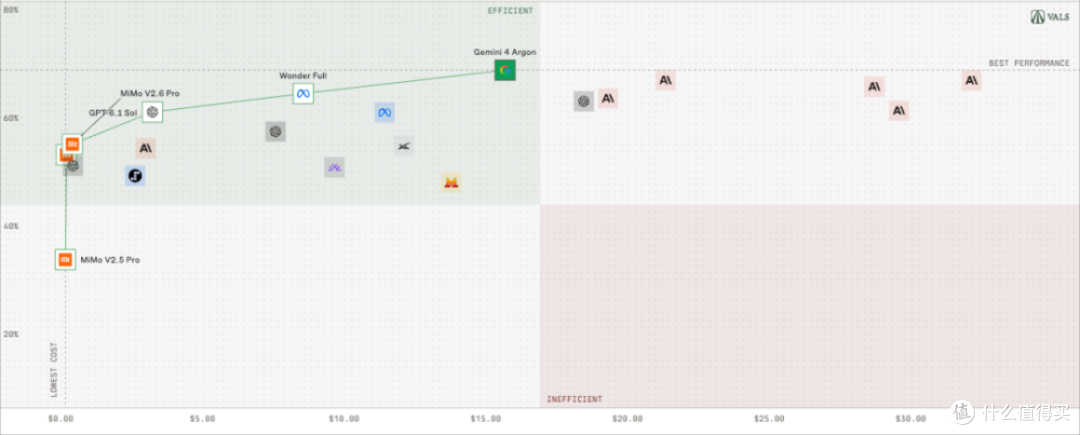 任务成本与综合表现
图 1|对照模型的任务成本与综合表现
图中纵轴看表现,横轴看成本:越靠上得分越高,同等表现下越靠左越省。Argon 位于绿色效率边界的上端,这是它值得被关注的理由。图为 10 月发布期的榜单快照,不能当作固定不变的排名。
做数据分析,它确实有拿得出手的结果
Analytics Vidhya 给出了一份改版前后的注册数据。总转化率从 29% 降到 26%,看板据此建议回滚。Argon 用 High 设置分析,发现新访客和老访客的转化率分别都提高了 5 个百分点;总数下降,来自访客构成变化。
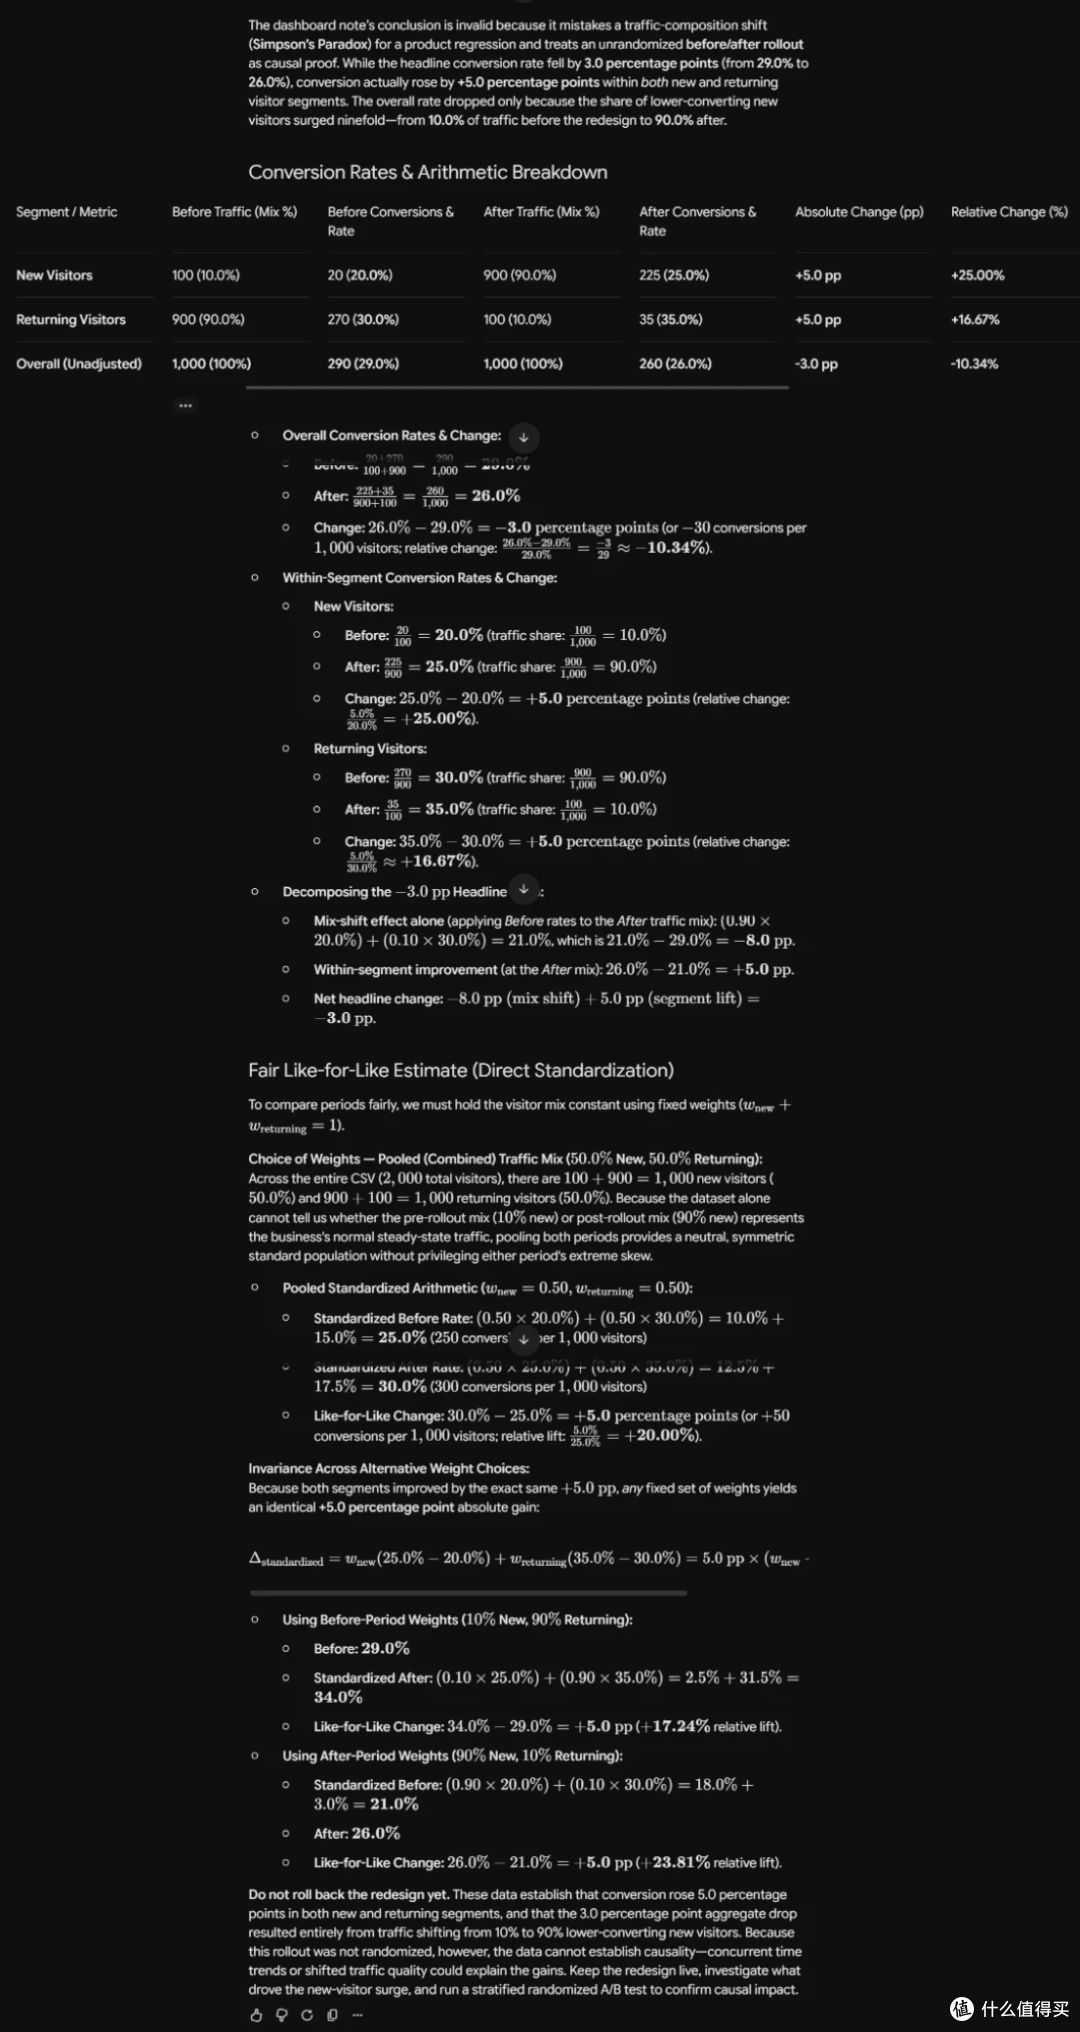 分组转化率计算
图 2|拆分新老访客,核对总体与分组转化率
看表格的三个变化:新访客 20%→25%,老访客 30%→35%,总体却是 29%→26%。它没有照着看板的结论走,还指出非随机的前后对比不能证明因果。这类可复核的分析,能直接帮助人少做一次错误判断。
对用户来说,任务权重往往完全不同。你可能只需要写商品文案,或者维护一个后端服务。在其他领域多拿几分,无法抵消眼前这份交付物里的错误。
所以,接下来要看的,是模型从给出答案走到完成任务,中间还剩多少人工检查。
02|从分析到成品,哪些地方拉开了差距
同样做一个 3D 产品,成品差别在哪里
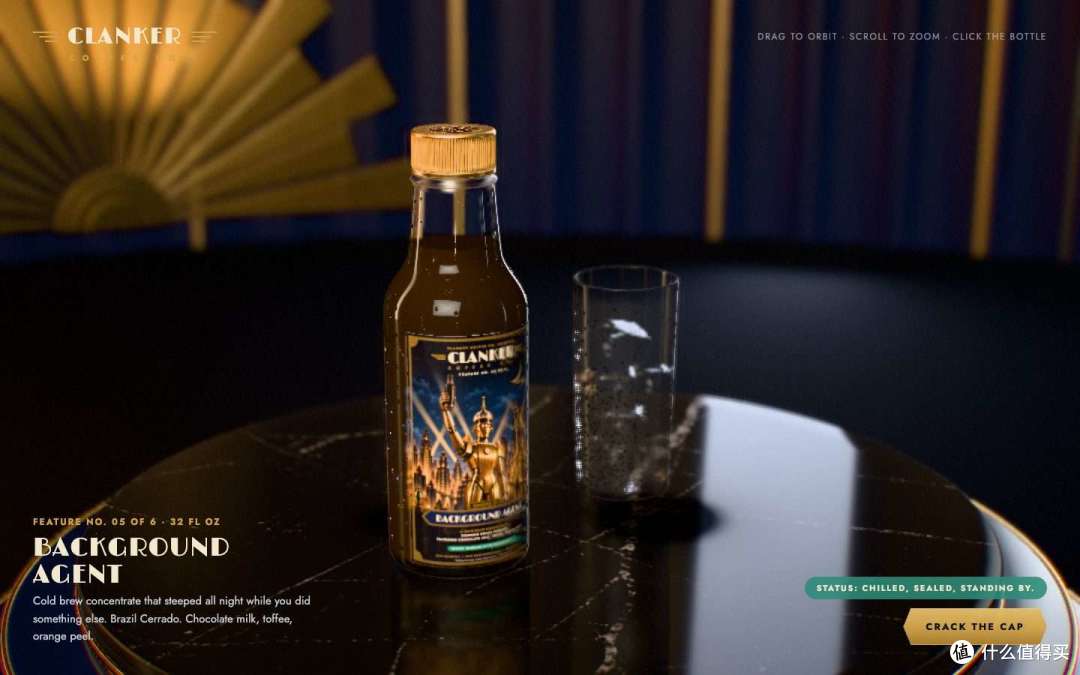
AI for Mortals 的 Pat Simmons 给四个模型相同要求:用同一套品牌材料制作可交互的冷萃咖啡瓶,并要求接近真实产品摄影。他先按匿名列评判,再揭晓模型。下面两张分别是 Argon 和 Opus 5.5 的结果。
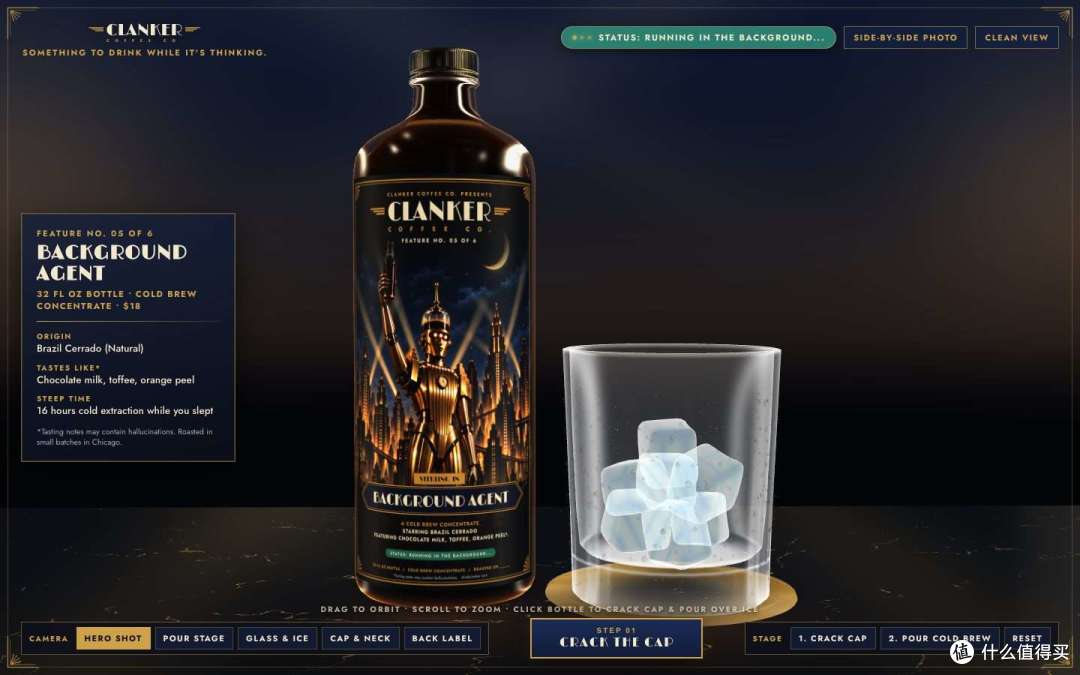 Argon咖啡瓶页面
图 3|查看 Argon 生成的咖啡瓶、冰杯和交互控制区
 Opus咖啡瓶页面
图 4|对照同题产品场景的材质、光照与页面布局
Argon 的品牌标签、瓶体和控制按钮都很完整,不能说它没有完成页面。对照看,第一张更像带操作面板的 3D 演示;第二张把产品放在灯光和景深更明显的桌面场景中。对于“接近产品摄影”的要求,这种差异比单看有没有生成瓶子更重要。
作者在四项构建的主观盲评中均把 Argon 排在末位、Opus 排在首位;Argon 的调用费用则每项最低。这里展示的是成品画面,不凭静态图判断开瓶、倒液体等交互是否合格。
代码检查通过,服务却起不来
ComputingForGeeks 在 10 月 13 日测试了非 root 运行的 nginx 部署。Argon 经 OpenRouter、固定 Google AI Studio 路由,在默认及低、中、高设置下各生成三次。
12 份配置都通过静态检查,却全部启动失败。 作者在 k3s 集群中实际部署,发现缓存目录写权限没有处理好。同题对照中,Opus 5.5 和 GPT-6.1 Sol 各三次均启动成功。
给 Argon 补上错误日志后,三次修复都能运行,但其中两次改变了要求的镜像和端口;它的备份脚本测试则通过了。这个小样本说明:能根据报错修复,与首轮就满足原约束,仍有距离。
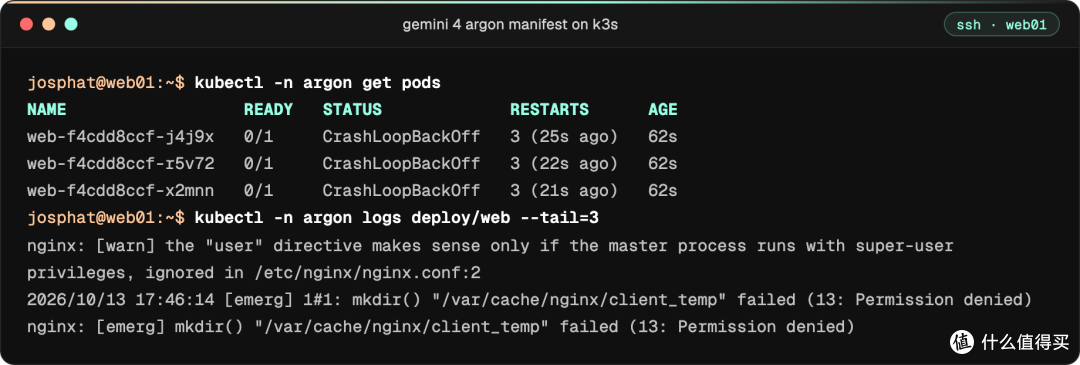 部署状态和目录权限报错
图 5|查看容器反复启动失败的状态及目录权限错误
图中三个实例的 READY 都是 0/1,STATUS 为 CrashLoopBackOff。下方日志的 Permission denied 指向缓存目录权限问题,这比“配置写完了”更接近实际运行结果。
商品资料能整理,换成促销文案就容易添油加醋
Spring Prompt 在 10 月 13 至 14 日用中等推理设置测试 Argon。其商品测试包含 56 个虚构产品,每个重复三次。
普通商品描述中,三次都达到可发布标准的产品占 60.7%;换成促销写法后,降至 17.9%。每轮无依据的描述也从约 23 条增至 111 条。
不过,它在普通商品描述上的整体通过比例与 Opus 5.5 持平,且该测试成本更低;促销任务的退步也并非它独有。问题集中在任务变化后,事实约束能否守住。
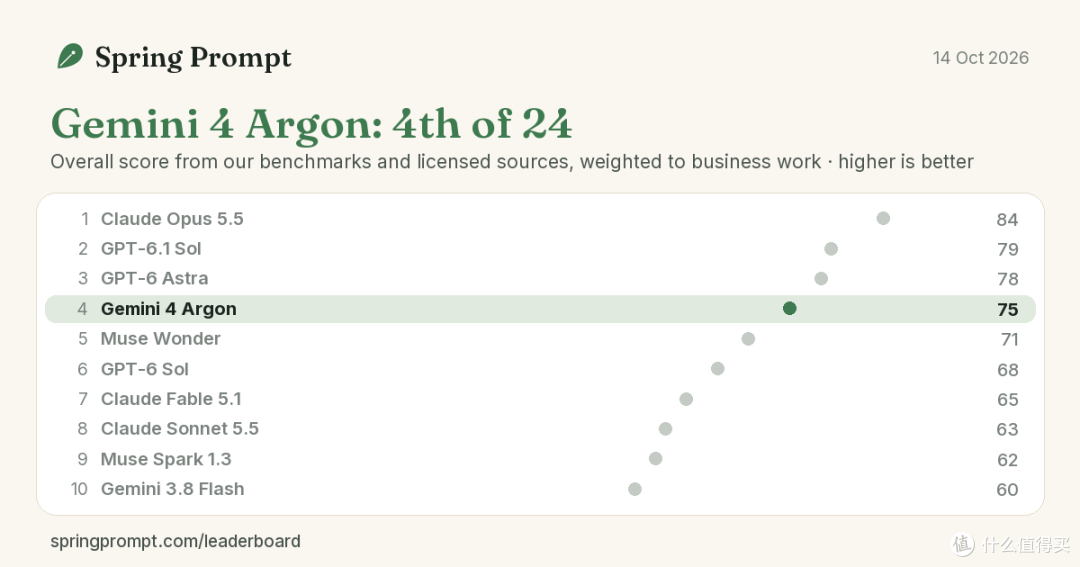 面向业务工作的模型综合排名
图 6|对比面向业务工作的模型综合得分与排名
这张图是 Spring Prompt 的业务综合榜,Argon 为 75 分,位列 24 个模型中的第四。它既不是前面的 Vals Index,也不是商品文案测试的通过率;两种综合排名使用不同任务与权重,不能直接拿名次变化证明模型能力下降。
判断全对,最后的摘要仍多写了一句
Analytics Vidhya 用相互冲突的发布文件测试 Argon,要求区分已批准计划、实际状态与未决事项,使用的是 High 推理设置。
八条判断全部正确。但在最终摘要里,模型把“170 个工作区接受了邀请”写成这些工作区“尚未上线”。材料并没有证明这一点。
这个案例的落差很细:前面的逐项核对做对了,最后整合成文时却增加了一条无依据的结论。
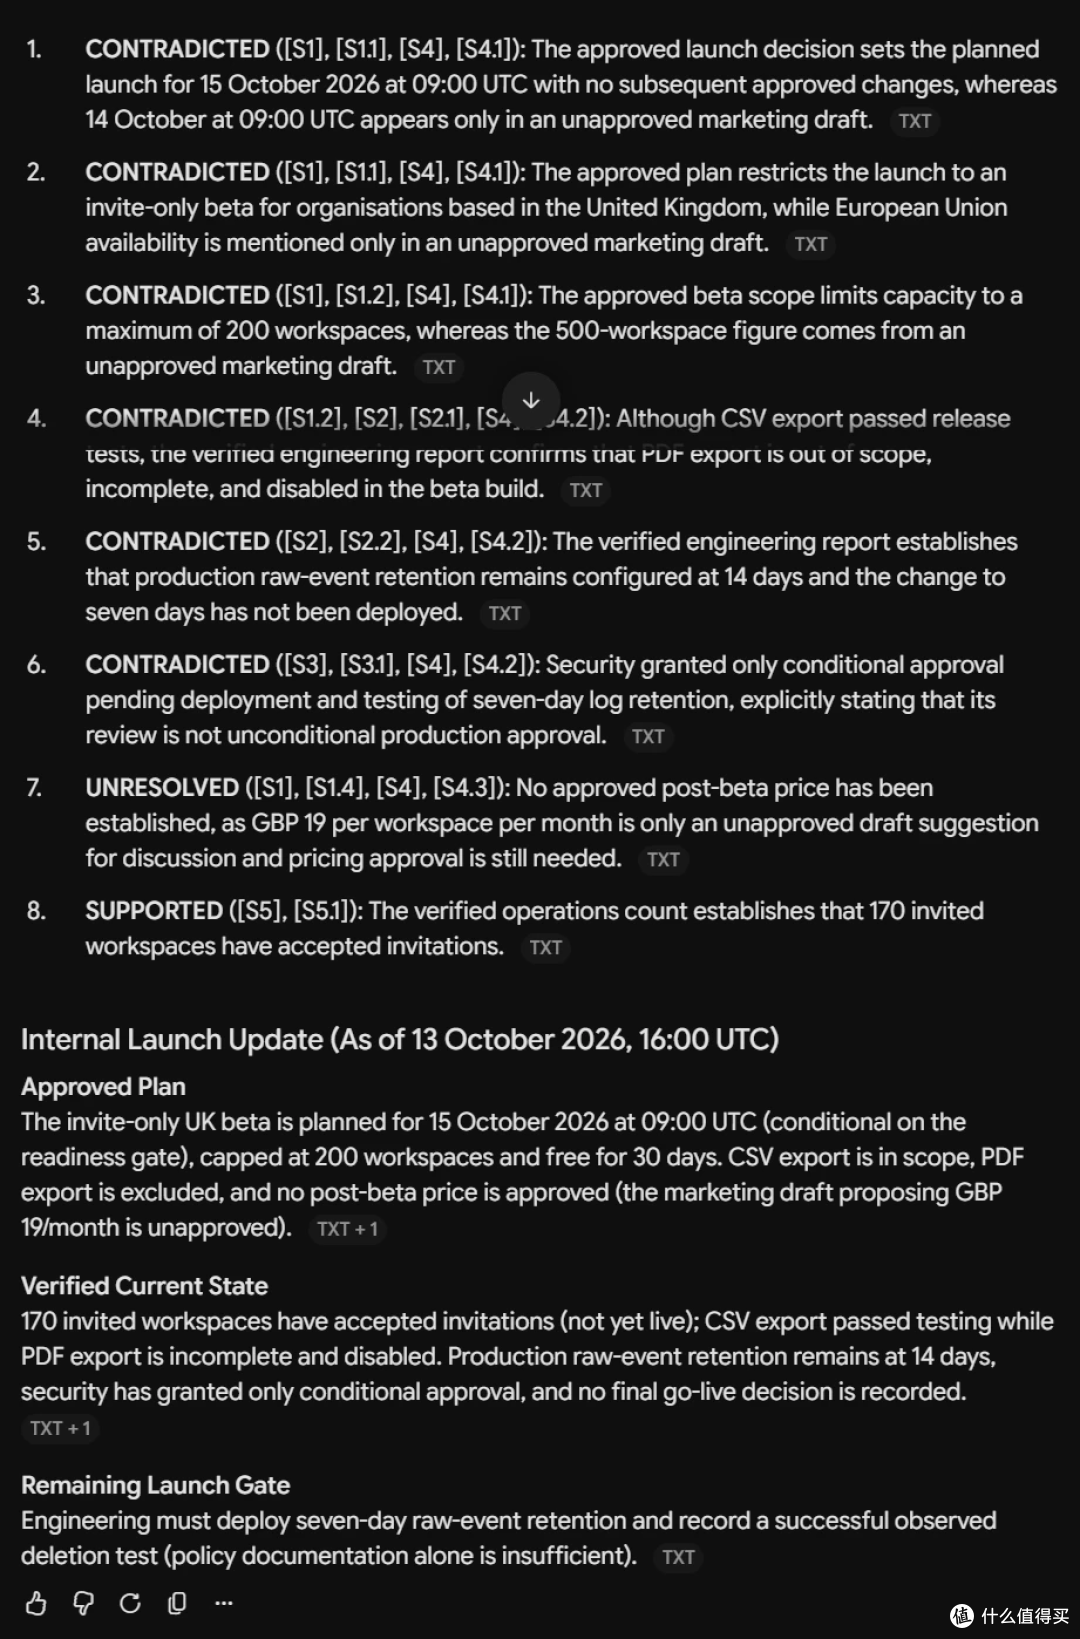 逐项事实判断与最终发布摘要
图 7|对照逐项事实判断与最终摘要中的状态描述
对照图中第 8 条和下方 Verified Current State:前者只确认接受邀请,后者却增加了括号里的 not yet live。复核长文时,这类被顺手补上的状态尤其值得检查。
03|跑分与体验为什么会错位
使用者的评价,分歧也很具体
正面评价同样存在。Promptslove 的 Ramanpal Singh 给 Argon 制作的赛车游戏、黑洞模拟器各打了 5/5;但香水网站和城镇游戏只有 2/5,批评集中在排版、控件和适配。它们是各做一次后的个人评分,没有重复构建,不是稳定成功率。
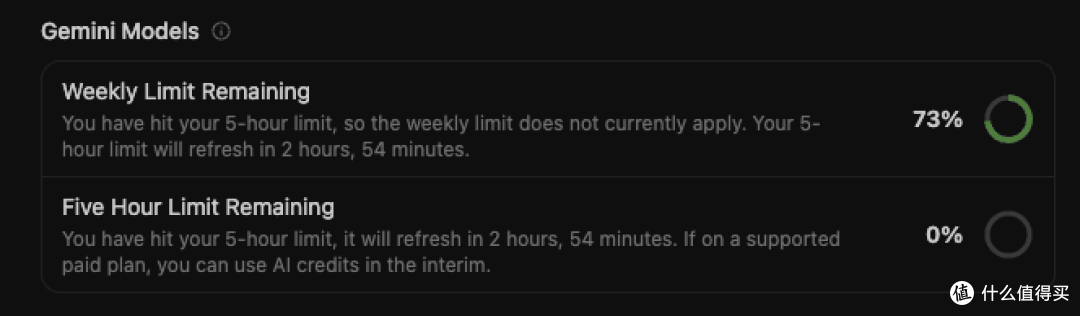
中文测评者数字生命卡兹克更在意持续工作的体验。他在 10 月 14 日的文章中称,完成不到十个任务,五小时额度就耗尽,周额度消耗 27%。截图显示周额度剩余 73%,五小时额度剩余 0%。
 模型额度剩余状态
图 8|查看五小时额度耗尽及周额度剩余状态
这是一个账户在特定任务下的经历,不能换算成所有人固定能做多少任务。但它解释了为什么有人认可模型答案,仍不愿把它当主力:做到一半被额度打断,也会增加交付时间。
这些评价并不矛盾。做一个游戏原型、对照产品摄影标准、连续处理工作,各自检查的是不同结果。
这几项测试不足以推翻综合榜单,也不能据此认定 Argon 在所有场景都差。它们揭示的是不同的验收口径:
工作 容易停下来的检查 真正交付前还要检查 软件部署 文件格式和静态规则 服务是否启动、原约束是否保留 商品文案 语言是否顺畅、有吸引力 每一项产品承诺是否有依据 文档汇总 单条判断是否正确 最终摘要是否增加了新事实
在我看来,这也是“跑分强、用起来却没那么省心”的主要原因:用户承担的是整份结果的返工成本。 哪怕大部分内容正确,一个影响上线或发布的错误,也可能让整个任务重新检查。
还要区分一次回答和带反馈的工作流程。把日志交回去继续修,已经是新的一轮任务。如果用“最终修好了”评价模型,就应把追加提示、重试和人工核对一起算进去。
这些测评也不是同一套实验:调用入口、推理设置、题目和评分方法各不相同。不能把商品文案的百分比和 Vals 的分数直接相减,算出所谓的“缩水幅度”。有证据支持的说法是:综合优势没有稳定转化为所有具体任务的一次交付成功。
04|要不要换模型,先验收自己的任务
如果你正在考虑把常用模型换成 Argon,我建议先拿一份已经知道合格答案的工作测试,不要只让它自由发挥。
做开发,就给它一个带明确运行约束的小任务,真的启动服务、跑测试,再看它有没有为了通过而改掉需求。
写文案,就给它一份固定的商品资料,把功能、价格和限制逐一列清楚。成稿后,检查每句具体承诺能否回到资料中找到依据。
整理报告,则把“事实核对”和“最终成稿”分别验收。不要因为前面的分析看起来严谨,就默认最后一段也没有新增推断。
可以记录四项结果:首次完成是否合格、补充了几轮提示、人工检查用了多久、总调用成本是多少。它们比一张通用排名更接近你的日常账单。
目前这些早期测评给我的判断是:Argon 值得进入候选名单,但不适合仅凭榜首位置就跳过验收。先看它能否把你手头的工作交对,再决定是否把更多任务交给它。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~