46999元买192G:这轮"AI饭盒"狂欢,你买到的是容量,不是速度
十月最后一周,“AI饭盒"市场热闹得像双11预热的另一个分会场:10月9日,极摩客拉着AMD和京东在深圳南山给EVO-X5 Pro开发布会,46999元起当晚在京东开启预约。10月12日,AMD官宣新一代锐龙AI Halo开发者平台:至高192GB统一内存、支持3000亿参数级模型。而原本3万6入手的DGX Spark,到10月24日自费评测博主司波图给出实测结论时,市场价已接近5万,被弹幕戏称"赛博金条”。微博知乎哔哩哔哩
A饭、折腾本地大模型的、被内存涨价背刺过的,这三拨人最近大概率都在同一个问题上纠结过:花四五万买台192GB的饭盒,到底值不值?
先说结论:这一代"饭盒"涨价买的东西只有一个——容量。速度没怎么涨,有些账销售页不会替你算。下面三本账,对完再掏钱。
第一本账:容量账,128→192是真门槛
这不是伪升级,但也别误会成性能升级。
上一代锐龙AI Max+ 395的128GB统一内存,装不下DeepSeek V4-Flash-0731的Q4权重——不是慢,是根本启动不了。至顶AI实验室拿到495机器实测:V4-Flash启动后GPU侧占用约130GB,192GB池子里刚好塞下还留了余量。极摩客发布会的口径也一样:4-bit量化下192GB能完全离线跑320B级模型,差的就是那64GB这一口气。哔哩哔哩知乎
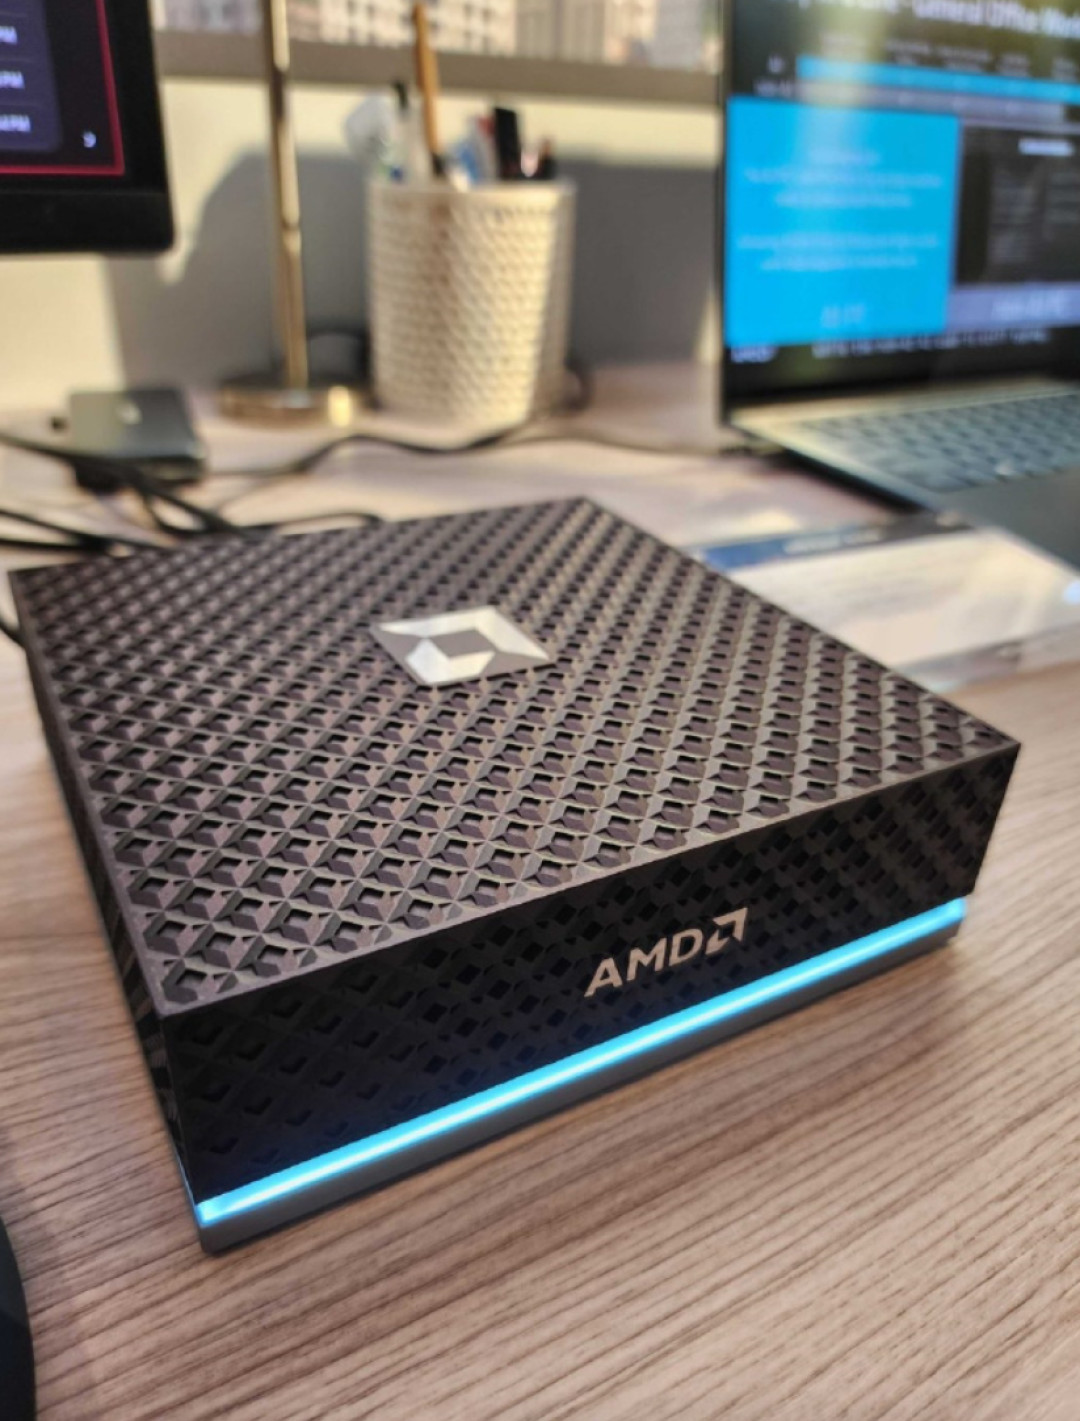
AMD官方给新Halo的定义同样是容量优先:最高160GB可分配给GPU当显存,让模型、应用和工作数据同时驻留。CPU拉到16个Zen 5核,40CU RDNA 3.5 GPU、NPU至高55 TOPS,这些都是配角。
但"装得下"和"用得舒服"之间还有一道坎:192GB里,300B级模型的权重、KV缓存、你的上下文和工作数据要分同一个池子。真拿旗舰模型干长上下文的活,先掂量权重之外还剩多少。DGX Spark评测视频里有条评论说得很实在:一个真正能帮你完成日常任务的模型至少要有200k的上下文,小显存硬伤太大。装得下模型,装不下上下文,等于白装。哔哩哔哩
第二本账:带宽账,+6.6%才是这代的真面目
395是256-bit LPDDR5X、带宽约256GB/s;495只是把频率拉到8533MT/s,带宽约273GB/s。容量+50%,带宽+6.6%,GPU还是那颗40CU的RDNA 3.5,8065S对8060S基本没动。知乎
这决定了"3000亿参数"这句slogan的真实形态。llama.cpp实测:V4-Flash生成约17 tokens/s、首token延迟2.1秒,开DSpark投机解码能到27 tokens/s;轻一档的Qwen3.8 Flash Next配草稿模型约34 tokens/s、首token延迟1.4秒。换句话说:大模型在饭盒里是"能用的慢",小中型MoE才是"舒服"。哔哩哔哩
反证也摆在那里。有博主拿Qwen 3.8 27B这种稠密模型横评了RTX 5090、Mac Studio M4 Max、DGX Spark和Halo,结论是初代Halo"没有一项优势",TTFT随上下文变长比Spark差好几倍,生成速度则和Spark半斤八两——因为两台机器带宽同样难看。DGX Spark评测视频里67赞的高赞评论说得更直白:“跑稠密模型慢到无法想象”。至于带宽这堵墙,调优救不了。知乎哔哩哔哩
有意思的是AMD自己也换了话术。9月30日的媒体沟通会上,495被归进了"智能体PC"这个新品类。新Halo的官方文章几乎不聊tokens/s,聊的是任务编排、内存和端到端完成任务与模型推理本身同样重要。翻译成人话:AMD知道跟NVIDIA拼稠密推理拼不动,赌的是智能体时代"模型常驻+多任务并发"的负载结构。这个赌注成立不成立另说,但它至少说明:拿495跟云端API比单轮生成速度,从一开始就是拿错了对手。知乎知乎
第三本账:生态与替代方案账,CUDA到底值多少溢价
软件面确实是NVIDIA占优,这一点连给出"没有一项优势"那篇横评的人都写得直白:"现在很多代码都基于 CUDA 生态,ROCm 还很不成熟。"Spark用户甚至玩出了双机跑DeepSeek V4.1 Flash、4台组集群跑完整版的路线——带宽不够,数量来凑,代价是12-15万的集群预算。
但AMD这一侧的追赶也在发生,而且是可查的:vLLM仓库里针对Strix Halo的FP8 W8A8专用Kernel(PR #63199)实测部分GEMM算子提速最高到2.54倍,不过截至10月26日还是Draft状态、没合进主线。ROCm的Windows驱动则在10月中旬正式落地。同一条模型换一套推理引擎,两台机器的成绩和结论能接连反转——这是司波图自费实测的原话。引擎选型对A饭是收益,对N饭是习惯,对正在选机器的人则是变量:现在的跑分贴,一个月后可能全部重排。知乎哔哩哔哩哔哩哔哩
价格面,同样"128GB级"的三条路在十月是三种脾气:
DGX Spark:128GB版市价从3万6爬到近5万,反而"卖爆",评论区那句冷笑话值得留着——“你不卖、不抵押,涨多少跟你半毛钱关系都没有”。10月2日之后,英伟达又官宣了64GB版DGX Spark,4999美元、10月23日开售——容量更小、价格更高。微博
AMD新Halo:495版官方国内价还没公布,别拿初代395版直接套——那台的官方售价是3999美元,国行渠道参考价约2.7万元。知乎
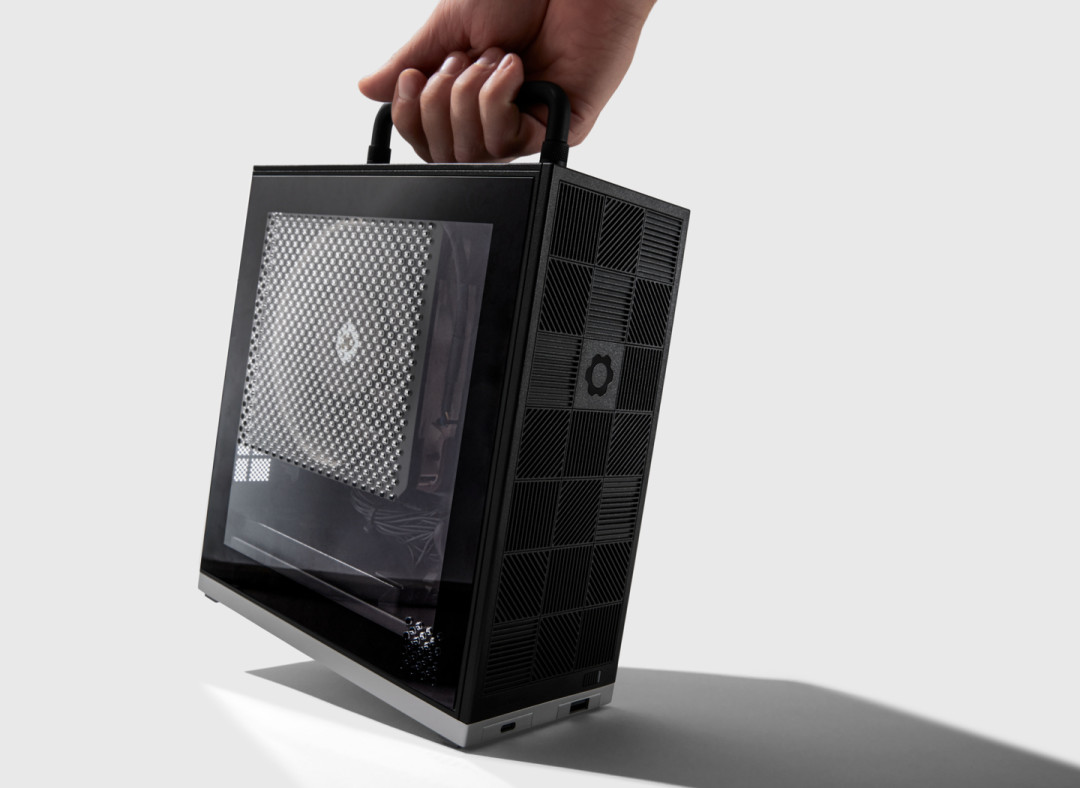
495的OEM现货:EVO-X5 Pro 46999元(192GB+2TB)/49999元(4TB),铭凡MS-S1 Max-P495报到51999元,壹号本干脆把495+192GB塞进了SuperX Pro平板;Framework Desktop 192GB版预售6469美元起,首批很快售罄。微博
要不要自组192GB塔?算完内存价再决定:去年初440元一条的DDR5 32G,现在行情3000元;六条拼出192GB,光内存就要一万八往上,还没算CPU和那块你真正需要的独显显存。统一内存平台的"溢价",在这个内存涨价周期里被削掉了一大截。
到底谁该买,谁再等等
结合四类实测数据和评论区真实反馈,给三档判断:
该动手的:数据不能出域的企业/政企/医疗金融场景——PRO商用认证、独立dTPM 2.0加密芯片、DASH带外管理是实打实的采购理由,IT拿到机器开机就能用,数据全程本地闭环。本地负载本来就以大参数MoE、多智能体常驻为主的团队也在此列。这类人买的不是玩具,是"开机即用+合规免审"。知乎
再等等的:个人玩家。盯三件事——AMD新Halo国行定价(首代395版与OEM同容量差价摆在那,官方机定价策略会直接决定OEM会不会降价);vLLM那个FP8 Kernel合并后的真实提速;内存价格走势。等一个月,账本数字可能完全不一样。
别碰的:主用稠密30B模型的、想顺手打游戏的、手里已有395机想升级的(+6.6%带宽不是换机理由)。还有一条看得最透的用户留言:"个人用户如果不是必须要求数据隐私,没必要去投入这么多钱去搭建。"一个真正能替你干活的200K上下文需求,云端订阅月费摊下来远低于四五万的折旧,"还是买token plan吧,几万块应该够我用到去世了"那句评论不是玩笑。哔哩哔哩
最后补一句A饭式的总结:这代饭盒把"能不能装下"的问题解决了,"跑得快不快"的问题AMD答不了、NVIDIA其实也答不了(Spark同样困在273GB/s里)。你花的46999里,192GB那部分买的是门票,273GB/s那部分才是所有人共同的天花板。 门票谁都需要,天花板谁都逃不掉——想清楚自己缺哪个,再决定掏不掏这笔钱。