先别急着开12小时档:OpenAI 缓存"永久保留"落地,Codex 用户这笔账要这么算
用 Codex 跑过大项目的人都熟悉这套动作:中途吃个饭回来、或者隔天点开旧对话,发出第一句话,转圈半天,额度肉眼可见地往下掉。不是模型突然变笨了,是服务端的提示缓存过期了——那几万字的项目说明、工具定义和上下文,被重新原样算了一遍。社区把这叫"冷启动惩罚",过去两个月小红书、知乎上关于"Codex 额度为什么掉这么快""缓存命中率为什么这么低"的吐槽一直没断过。小红书
48 小时之内,OpenAI 把这事连续回应了两次,而且一次比一次狠。
一、这两天到底改了什么
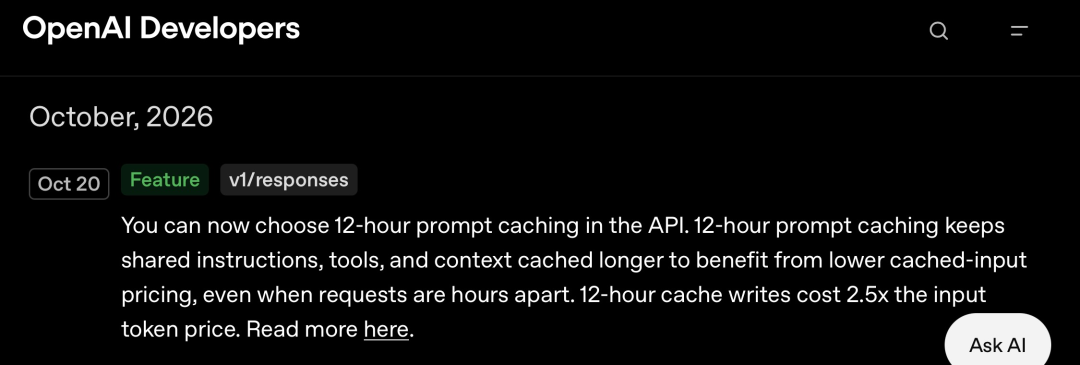
10 月 20 日,Responses API 更新:提示缓存新增可选的 12 小时档,默认仍是 30 分钟;Prompt Caching 文档同步改版,模型价格表里新出现了一列 `cache_write_tokens`。知乎微博
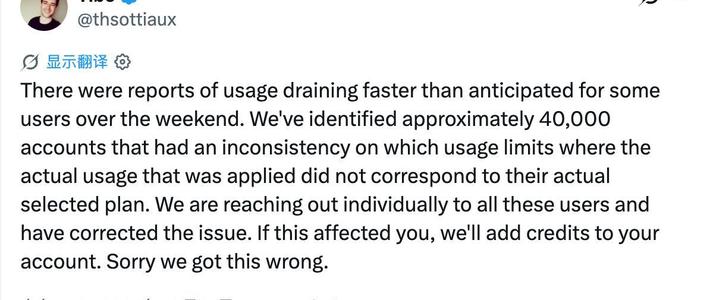
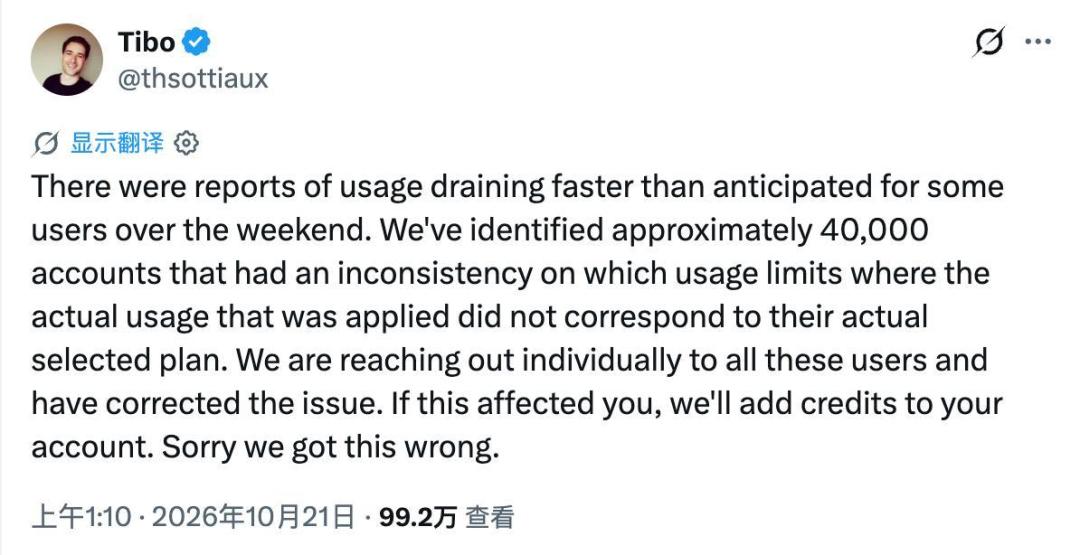
10 月 21 日(Codex 负责人 Tibo 那个"28 天改进计划"的第 16 天),Tibo 官宣:对登录用户,Codex 和 ChatGPT Work 的缓存永久保留,回到几小时甚至几天前的旧对话保证命中、不吃惩罚。同时给约 4 万个额度消耗异常的账户返还了信用点。智东西B站
一个有意思的时间线:10 月 20 日恰好是 DeepSeek 开源生产级推理框架 DeepInfer 的日子,社区调侃"DeepSeek 一开源,OpenAI 的缓存时间就上来了"。不管是不是巧合,缓存从一个没人关心的技术细节,变成了这两家正面交锋的战场。微博
二、先搞懂它在省什么:一句话版
模型处理你的输入分两步:先把整段文字"读"进去算成中间结果(这步最贵),再逐字往外生成。多轮对话每一轮都要把前面的内容重发一遍,Agent 更是几万 token 的系统提示每走一步重来一次。缓存做的事,就是把"开头这段"的中间结果存下来,下次开头一样就直接取用、跳过计算。
注意关键词是开头一样:前缀里改一个字,后面全部作废。所以圈内写提示有条铁律——稳定的放前面,易变的放后面。顺序反了,缓存白开。知乎
三、核心这笔账:12 小时档到底省不省
按官方费率算一笔账:以文档举例的 gpt-6.1-sol 为例,30 分钟档写入是普通输入的 1.25 倍,12 小时档升到 2.5 倍,而两档缓存读取都只要 0.05 倍。知乎
项目 | 相对普通输入的价格 |
|---|---|
30 分钟缓存写入 | 1.25 倍 |
12 小时缓存写入 | 2.5 倍 |
缓存读取(两档相同) | 0.05 倍 |
12 小时档的写入成本是 30 分钟档的两倍,能不能回本,全看后续复用次数。设一段固定前缀按普通输入计费为 1 个单位,请求发生在第 0、2、4、6、8 小时(30 分钟缓存每次都已失效、只能重算):
同一前缀使用次数 | 30 分钟档成本 | 12 小时档成本 | 结果 |
|---|---|---|---|
1 次 | 1.25 | 2.50 | 12h 多花一倍 |
2 次 | 2.50 | 2.55 | 基本打平,仍亏 |
3 次 | 3.75 | 2.60 | 12h 开始划算,省约 31% |
6 次 | 7.50 | 2.75 | 差距越拉越大 |
盈亏线大致在复用 3 次:三次使用时 12 小时方案 2.60 个单位,已经低于 30 分钟档反复重写的 3.75,差约三成。但有三个容易踩的细节:知乎
如果你的请求本来就密集(30 分钟缓存持续命中,成本 1.25 + 0.05×(n−1)),再开 12 小时档纯属多花 1.25 个单位的写入费。
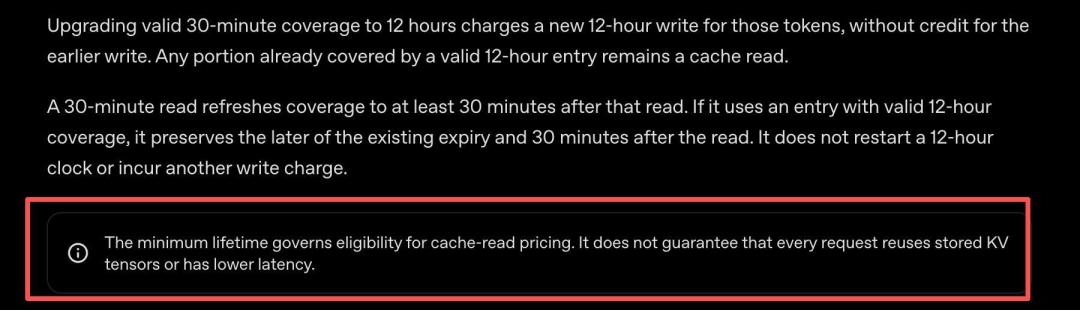
升级要整段重写:已有的 30 分钟缓存延长到 12 小时,按 12 小时费率重新写入,之前付过的不抵扣;可缓存前缀还得满足最少 1,024 个可见输入 token。知乎
命中不是玄学,是日志:请求级设 `prompt_cache_options.ttl: “12h”`,多段前缀可在断点级用 `prompt_cache_breakpoint.ttl` 分别控制;开了之后盯 usage 里的 `cached_tokens`、`ttl_30m_tokens`、`ttl_12h_tokens`,用自己的账单数据判断值不值。
四、三类人,三种动作
Codex / Work 登录用户(重度 AI 编程、长任务党):这次更新零门槛,不用改任何配置,后台自动生效。隔夜回到老对话不再"补交一遍重算费",对多项目并行、日夜切换的人等于变相涨了额度——Codex 不按字数收钱、按额度限流,额度掉得快慢直接取决于缓存命中率,Tibo 此前就承认过命中率下滑导致部分用户额度异常消耗。知乎
API / 自建 Agent 的开发者:先数清楚你的复用节奏。同一工作日内反复使用的稳定材料(开发规范、工具定义、项目参考资料)才值得上 12 小时档;单次调用、前缀常变的,维持默认 30 分钟更省。动态内容一律放断点之后。
低频用户:什么都不用做,也别为"永久保留"这个字眼冲动升级套餐。
五、四个必须先知道的坑
“永久保留”≠模型记住你了。缓存存的是计算状态,不是答案,也不等于上下文记忆。智东西等媒体同时指出:Codex/Work 的永久缓存尚未发正式公告,具体是保留策略、计费安排还是权益补贴,细节有待官方确认。把它当"计费补贴"理解最稳妥,别当"无限上下文"用。智东西
"12 小时"是计费的最低覆盖寿命,官方文档明确:不保证每次请求都能复用已存缓存,也不保证延迟更低。缓存有效期、实际命中率、请求延迟是三个概念。知乎
开了缓存不等于自动省钱。有 B 站博主拿 Claude Code 连续 6 轮实测计费"少花 55%"。前提是前缀稳定、顺序排对;顺序反了,写入费照付、读取命中为零。B站
服务端的缓存永久了,你 C 盘的缓存还在吃硬盘。社区实测过 `~/.codex` 目录积出 100GB+ 本地缓存的案例。定期清理脚本该跑还得跑,这是另一码事。小红书
六、顺手看一眼三家的答卷
同一道题,三家公司给了三种解法:
厂商 | 缓存时长 | 写入价格 | 读价 | 备注 |
|---|---|---|---|---|
OpenAI | 默认 30 分钟 / 可选 12h / 订阅端"永久"(待细化) | 1.25 倍 / 2.5 倍 | 0.05 倍 | 时长做成收费档位 |
Anthropic | 默认 5 分钟 / 可选 1 小时 | 1h 档 2 倍 | 约 0.1 倍 | 同样按档位加价 |
DeepSeek | 工程文档披露:Agent 流量 3 天、聊天流量 7 天(非 API 承诺) | — | — | 靠架构把缓存压进硬盘,实测平均输入命中率 96%,每卡吞吐从 6 万涨到 150 万 |
美国公司把缓存时长做成 SKU,想要更久就加钱;DeepSeek 直接把它做进了推理架构。这次 OpenAI 把档位拉到 12 小时、又给订阅端开"永久",下一步值得盯两件事:官方文档什么时候补上永久缓存的实现细节,以及 Anthropic 会不会跟进。在这之前,先用你自己的 `cached_tokens` 说话——账算得过来再开档,算不过来,默认 30 分钟就是最优解。知乎