这周的硬件行情,魔幻到连捡漏党都开始互相提醒"抓紧"。
一边是新卡:RTX 5090市价被炒到原价的3.5倍,澳门海关一周截获12起走私案,有人把内存条粘在腿上闯关。2026年三季度全球PC出货量同比跌了21%,内存在整机成本里的占比冲到40%,涨了四倍以上,业内预判这波涨价还要持续3到4年。快科技微博
另一边是二手市场,本来该是"电子垃圾"的老算力卡,也跟着被重新定价。一位小红书博主10月5日发帖说V100二手卡大概3000一张,结果发帖当天评论区就又冒出两个价:3800和4500——“3000不是起点”。B站一条双V100实测视频的评论区里,有人感叹32G版已经涨到4000,“这价钱都能买4张16G的了”。服务器内存更夸张,三年前120块能买4条16G,上周同样的条子120块只能买1条;连AMD的mi50、DDR4老主板都在涨。还有人晒出自己4199买的全新RX 7900XT,现在二手价比全新还高。小红书哔哩哔哩哔哩哔哩

新卡买不起、老卡也在被抬走,“捡漏二手算力"这条路正在从段子变成正经选项。但它到底值不值、坑在哪?这周恰好有一份质量很高的实测样本可以拆:B站UP主"AI练习生x顺子"用两张二手Tesla V100-32G跑176B开源MoE模型,喊出"同场景追平四万多的RTX 5090”,视频两天冲到74赞、142收藏、100多条评论——评论区有质疑、有对线、也有补充实测,信息密度比视频本身还高。我们把它和知乎、小红书上的多份独立记录拼在一起,给你算三笔账。
第一笔账:六千块到底买到了什么
先看配置和成绩。UP主的机器是双Tesla V100-32G(无NVLink桥接)+X99双路主板+62G内存,整机成本六千出头;对比对象RTX 5090单卡整机四万多。跑的模型是176B参数的开源MoE,IQ3_S量化后82.8GB,256K上下文,引擎用Strata。哔哩哔哩
成绩:解码中位172 tok/s,峰值190.3;而同模型、同量化、同引擎家族的社区公开基准里,RTX 4090单卡是97.2,RTX 5090单卡是170.5。也就是说,两张2017年的老卡,解码速度确实摸到了当代卡皇的水平。哔哩哔哩
为什么老卡能追平?这里有个反直觉的知识点:MoE模型拼的不是峰值算力,而是专家权重能不能全部驻留显存。4090/5090单卡24~32G显存只能装下一半左右的专家(约12000个槽位,命中率92~97%),剩下的要走系统内存;而双V100共64G显存,24576个专家槽100%驻留,推理全程不用去内存里捞数据。V100的HBM2显存带宽900GB/s,到今天依然不输新卡——RTX 4080也才736GB/s。老卡老的是计算核心,不是喂数据的嘴。哔哩哔哩知乎
但口径必须掰开看,这也是这条视频比多数"吊打体"诚实的地方:190.3是峰值,172是6轮中位,而日常知识问答开着思考模式,实际体感是78~93 tok/s。评论区有人质疑"V100(SM70架构)在新内核里基本是被放弃的那批,长上下文还能剩多少速度",UP主贴出了逐档实测:1K上下文106 tok/s,128K还有92.5,256K顶格87.4——全程只掉18%,且温度压在72°C没降频(社区单卡同型测试是掉29%还热降频到84°C)。真正的瓶颈在首字延迟:256K档位TTFT(首token时间)要等148.6秒,长文档场景你得先忍两分半的沉默,之后才是流畅吐字。哔哩哔哩
一句话总结这笔账:买的是"大显存池+高带宽",适合跑MoE大模型和长上下文;不是买"新卡级体验",单卡原生基线只有33.5 tok/s,172是深度调优后的结果。哔哩哔哩
第二笔账:卡价之外,你还得花多少
V100不是插上就能用的游戏卡,它是数据中心计算卡,围绕它有一整圈"隐性成本",知乎和小红书上的折腾实录基本都栽在这几项:
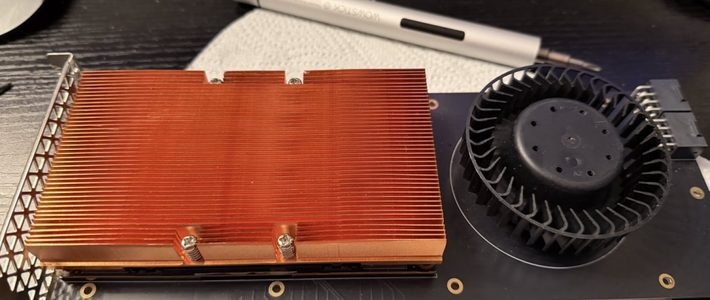
转接与散热:便宜的SXM2版本(海外eBay约170欧元)没有PCIe接口,需要非官方转接板(约50英镑);卡是被动散热,得自己加80mm风扇配3D打印风罩。闲鱼上一款V100转4090转接板方案被5万人次围观、近2千人想要——需求真实存在,但也说明这是条"折腾佬"路线。知乎
噪音:原装涡轮风扇满载82dB,什么概念?堪比割草机,放卧室免谈。知乎
电源:有知乎用户实测显卡满载时12V直接跌到11V,被迫换了一台高品质850W电源。V100 PCIe版TDP 250W,双卡整机满载按0.6kW估,7×24跑一个月就是400多度电,电费两百多块——买卡前先把这笔月度开销想清楚。知乎
稳定性:热重启后偶发不认卡,必须完全冷启动才恢复;非官方转接板的供电和稳定性没有任何保障,卡本身也早过了保修期。

知乎7月那篇《1800元穷玩LLM》给了个低成本样板:V100 SXM2 16G+转接板+风扇总共约1800元,配上原有RTX 4080用llama.cpp拆层跑Qwen3.6-27B的Q5量化,生成32 tok/s、提示词处理133~160 tok/s,接进OpenCode当本地代码助手完全够用。但注意,那是7月的价格——如今32G版已经喊到4000+,这条路线的"穷玩"成色正在褪色。知乎
第三笔账:软件层的五个坑,一个都躲不掉
硬件只是入场券,V100是Volta架构(算力等级sm_70),软件生态正在把它边缘化,社区踩坑记录高度一致:
新内核默认不带它玩。现在绝大多数模型算子默认按sm_80+编译,直接跑就报错。llama.cpp等新版本的内核也在放弃Volta,那条172 tok/s的实测,前提是用社区维护的V100专用分支内核,而不是官方原版——买卡前先去对应引擎的仓库确认"Volta还活着"。知乎
量化档位必须和显存严格对齐。双V100 64G:IQ3量化约52GB刚好全塞下;换IQ4约67GB就溢出到内存,速度断崖下跌。不是量化档越高越好,塞不下等于白搭。
ECC默认开着吃显存。关掉ECC速度不降还省显存,这是数据中心卡和游戏卡的习惯差异。
锁频和驻留模式要手动开。锁频1380MHz+persistence on,配合调优才能压住温度和降频;另外系统里残留的僵尸进程会让速度暴跌,跑分前记得清干净。
调优空间巨大,但别指望开箱即用。同一张V100跑27B模型,有人开箱只有4 tok/s,调优后能到64 tok/s——16倍差距全在参数里。反过来,也有场景老卡无解:知乎一篇《40张V100跑不过16张A100》记录了Qwen3-Omni多模态部署,卡在多模态算子对sm_70的支持上,堆卡也没用。知乎知乎

谁该去捡,谁别碰
把三笔账合起来,这条路适合谁、不适合谁,其实很清楚:
千元级预算、动手能力强:V100 16G一两张,跑27B级量化模型当代码助手/知识库,1800元样板可抄,但要有折腾散热、电源、内核的心理准备。
四到六千预算、想认真跑100B+大模型:双V100 32G是目前性价比最高的"大显存池"方案,前提是接受256K首字两分半、82dB噪音和持续电费。
五万级重氪:8张二手3080 20G魔改卡+双路服务器的整机方案已经有人跑通748B模型(13.8 tok/s),那是另一个量级的游戏。哔哩哔哩
这些人别碰:只想省心开箱即用的(直接买新卡或整机迷你主机);只跑7B/8B小模型的(中端新卡甚至核显都够);低频使用的——评论区就有云厂商现身说法,4090按小时租一块多钱,用完释放。本地部署的真正价值是隐私、7×24常驻和不限量token,从来不是"省钱",用量小的话云端反而更便宜。哔哩哔哩

最后说窗口期。业内预判存储涨价还要持续3~4年,意味着"再等等就降价"这个策略对新卡旧卡大概率都失效;但也不用被"4500"的喊价吓到FOMO——那是挂牌价不是成交价,评论区实际口径还在4000上下。真决定入场,盯三个信号:V100 32G成交价是否站稳4000以上(站稳说明重估完成,性价比逻辑生变)、你要用的推理引擎社区分支对Volta的支持是否还在更新、以及双十一新卡放量后二手价差的收敛情况。二手算力的黄金捡漏期,可能就在这个冬天前后。












