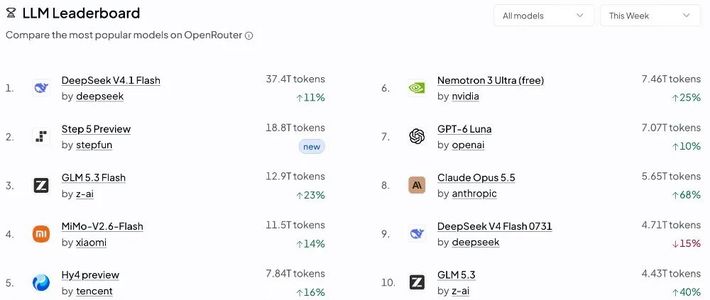
今天中午开始,两条消息在开源玩家的群里接力传:一条是"商务部拟把AI大模型、智能体纳入出口管制目录",另一条是某博主的快评,说"开源"今后将限于国内。 后者被转了一轮又一轮,不少人已经在讨论要不要把自托管的国产模型权重从GitHub下架、海外的朋友还敢不敢接中国项目的PR。微博
把公告原文和附件逐条读完,结论恰好是这个流传解读的反面:这份目录要管的是"没公开的配方",而"已经公开的"和"准备公开的"开源,是40项技术里唯一被官方开了快车道的那一类。 下面是AI玩家此刻真正需要核对的6条边界线。
30秒看懂这份公告本身
10月16日下午,商务部、科技部发布2026年第48号公告,就修订《中国禁止出口限制出口技术目录》公开征求意见,依据是《对外贸易法》和《技术进出口管理条例》。 拟新增40项技术:人工智能23项、生物医药5项、光伏12项;禁止出口14项、限制出口26项。知乎知乎
公众意见征集截止到11月15日。 更值得注意的是执行节奏:临时登记从公告发布当天就开始,连已经开始但尚未完成的出口也要登记——这是征求意见稿,但从今天起就已经有牙齿了。 这23项AI技术覆盖大模型、智能体、算力集群、信息处理四个方向。知乎知乎知乎
六条边界线,每条都跟开源玩家有关
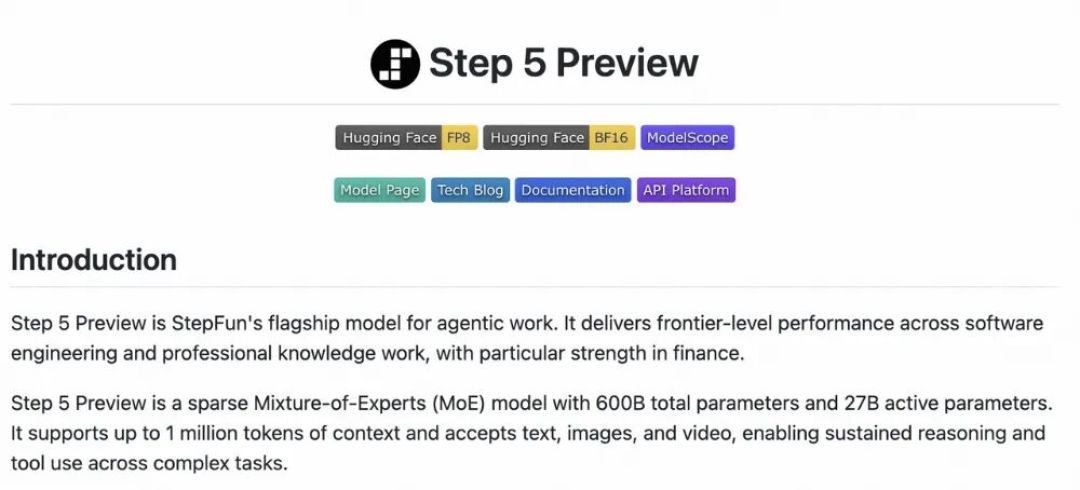
第1条:已经公开的,不在管理范围。 附件里有一条比正文还关键的注释:已通过开源、发表学术论文等方式进入公共领域的技术,不纳入管理范围。 Qwen放出的权重、DeepSeek公开的论文、Kimi开源的模型,不会因为这份目录被追溯。开源发布页长这样——权重、下载入口、许可证信息全部公开可见,这正是"公共领域"四个字的样子。知乎
第2条:往后新开源,算出口,但走"自动许可"。 商务部答记者问的口径是:对AI类技术的开源也按出口行为来管,只是走自动许可,基本即报即出。 翻译成人话:开源第一次在法规意义上被认定为一种出口形式,但官方给它留了一条报备即走的高速通道,而不是签证排队。知乎
第3条:限制类管的是"顶配闭源能力"。 拟列入限制出口的大模型核心技术,画了三条线:训练计算量超过10^26、或参数超过2万亿、或在公开评测中排进全球前10,占一条就进管理范围,管的是权重、检查点、底层源代码和训练推理方法。 被线拴住的是"没公开的顶配";已经放出来的不在管理范围,正在放的也按豁免一侧走。哔哩哔哩
对照这个口径看今天的开源供给:月之暗面7月27日把K3全量开源,2.8万亿参数照样开;昨天蚂蚁把560B大模型放了权重,MXFP4量化把显存砍掉将近一半,4张卡就能跑;今天腾讯混元又开源了面向Agent的长期记忆系统Hy-Memory。 政策噪音里,开源的供给节奏一点没慢下来。36氪微博

第4条:管技术,不管产品。 大模型API调用、SaaS应用等应用层出海模式不在出口技术管理范畴;把模型做成App或网页、让用户在手机和Mac Studio上本地跑,都不算技术出口。 商务部答记者问说得很直白:有关措施正式实施后,绝大部分人工智能技术仍可以自由出口。 对玩家意味着:下载公开权重自己跑、给海外朋友推荐模型链接,不触发任何登记义务。真正踩线的是限制类技术本体从境内往境外转移——典型场景是带着未开源权重去海外做本地化部署。知乎界面新闻
第5条:这份目录是有前科的。 2020年8月目录调整,把"基于数据分析的个性化信息推送服务技术"划进了管制,正卡在美方强推TikTok出售交易的时间点上,那笔买卖最后没做成。 所以这次40项不是纸面文章;但也正因为如此,把"已开源豁免+开源自动许可"写成附件注释而不是含糊其辞,才更值得读——这是明牌。知乎
第6条:征求意见期就是你的提问窗口。 11月15日前,条文可能增删:比如"用限制类模型微调出来的衍生模型算不算已公开技术",附件没有写死;比如自动许可的登记细则还没发布。对开源社区来说,这两个问题的模糊度,比"要不要管制开源"本身大得多。
为什么这个时机值得看懂:中美在同一个问题上对着喊
把时间轴并排放在一起,会看到一个很少被完整讲出来的事实:开源模型已经是两国政策圈的共同议题,只是方向相反。 今年7月24日,Kimi K3开源震撼硅谷的当天,黄仁勋注册X账号发的第一条推文就是力挺开源模型的公开信;安全从业者tombkeeper当时把英伟达反对禁用的逻辑讲得很白:真禁用开源,英伟达GPU的客户就只剩那几家闭源模型厂商。微博
开源已经不是边缘路线:9月黄仁勋给出的口径是,开源模型生成的Token占比已从30%涨到接近70%,对全球开源模型贡献最大的国家是中国;HuggingFace平台上中国自研开源模型的下载占比今年首次超过美国,累计下载突破100亿次。 能力端这几个月也一直是中国开源模型和硅谷闭源旗舰逐榜对打,K3对行业路线的冲击被普遍认为超过了当年的R1。知乎

而今天的48号公告,用的是同一套工具、相反的方向:不是限制别人用中国开源,而是把"没开源的"锁进许可证,给"开源的"发自动许可。对一线AI玩家,这传递的信号其实很实际——继续开源,在合规上第一次变成了比闭源出海更顺的路。
三类人,接下来一个月各看各的
日常下权重、自托管、白嫖HF的个人玩家:什么都不用改。 已公开权重不追溯,本地跑不算出口。唯一要做的是别再往群里转"开源限国内"的误读。
有海外部署、要给境外客户做私有化交付的团队:先自查再登记。 手上若有限制类技术本体(超线参数模型、未公开的训练方法、算力集群调度技术),临时登记从今天起就适用,别等正式版;API和SaaS出海不受影响,但"帮客户在海外本地部署未开源权重"是最典型的踩线动作。知乎
犹豫要不要把自己模型或工具开源的团队:这是利好大于限制。 开源被正式认定为出口形式,但给了自动许可这条快车道;真正锁死的是没公开的配方。 但注意顺序很重要:先公开,才豁免;开源之前就已外泄或未公开的衍生技术,不在豁免范围内。知乎
继续观察什么
11月15日前:意见征集结束,看40项里哪几项被留下、开源注释措辞有没有动;
自动许可实施细则:备案流程和口径什么时候发,决定"即报即出"是不是纸面速度;
权重算技术还是算数据:模型权重出境在数据出境规则里怎么归类,两套规则在AI上交汇,这是下一轮争论的焦点;
美方动作:封禁中国开源模型的讨论有没有从国会落到行政令——那边每动一次,这边的开源豁免就更像一种主动的路线表态。
目录修订从来是一国技术家底的倒影:写进清单,等于官方盖章这项技术在全球的位置;而把开源留在闸门之外,等于盖章承认——中国AI最硬的竞争力,恰恰是那部分公开的东西。对玩家来说,这轮不需要恐慌性下架权重,需要的是把"已公开豁免、开源即报即出、API不算出口、超线闭源才许可"这四句话记住,11月15日之前,把意见提给该提的地方。














