过去两周,逆向工程圈的Feed流被劈成了两边。
一边是B站的卖课UP主们集体开香槟:「AI竟然3h开发出游戏外挂」「逆向挂圈作者的天塌了」「有了这AI逆向合集包,新手也能玩转AI赛道」,主页私信发暗号领技能包,转化路径熟练得像话术模板。 另一边,是一个叫 reverify 的开源项目甩出来的基准数字:让 AI 凭训练记忆回答 71 个真实 Windows 系统文件的"教科书级"问题——比如某个函数的序言指令是什么——AI 有 97% 的答案是错的。哔哩哔哩知乎
诡异的是,这两边说的都是真事。就在 8 月,还有人拿一个 27B 的本地模型 Qwen 3.8,在一台 ThinkStation 上花 30 分钟静态拆解了一款商业软件的许可证校验链,把厂商故意混淆的公钥从几千行 arm64 汇编里抠了出来,中途还自己发现哈希不匹配、推倒重做到逐字节一致。知乎
30 分钟破认证是真的,97% 乱编也是真的。问题来了:为什么两件事能同时成立? 而这个问题,恰恰决定了你——一个会点 x64dbg、Frida,JS 逆向卡过壳、被混淆源码折磨过的逆向学习者或爱好者——今年是该跟着卖课的梭哈"AI 逆向",还是该把老本行扔了,还是该换一种学法。
这篇文章不站"AI 已死"也不站"一键逆向",我把 2026 年到现在所有能查证的 AI 逆向实战事件摆在一起,给你一份能直接用的判断清单。
一、先把账摆平:2026 年值得进书签的 7 个真实验
时间 | 事件 | 关键数字 | 可信度折扣 |
|---|---|---|---|
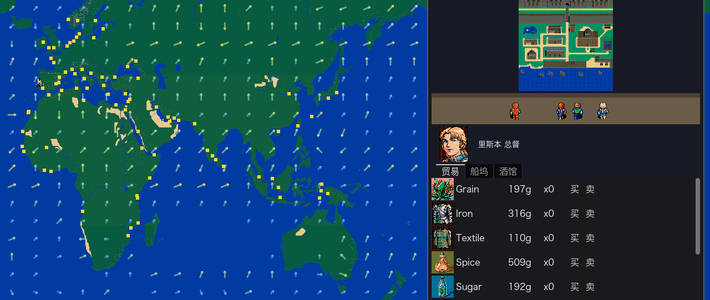
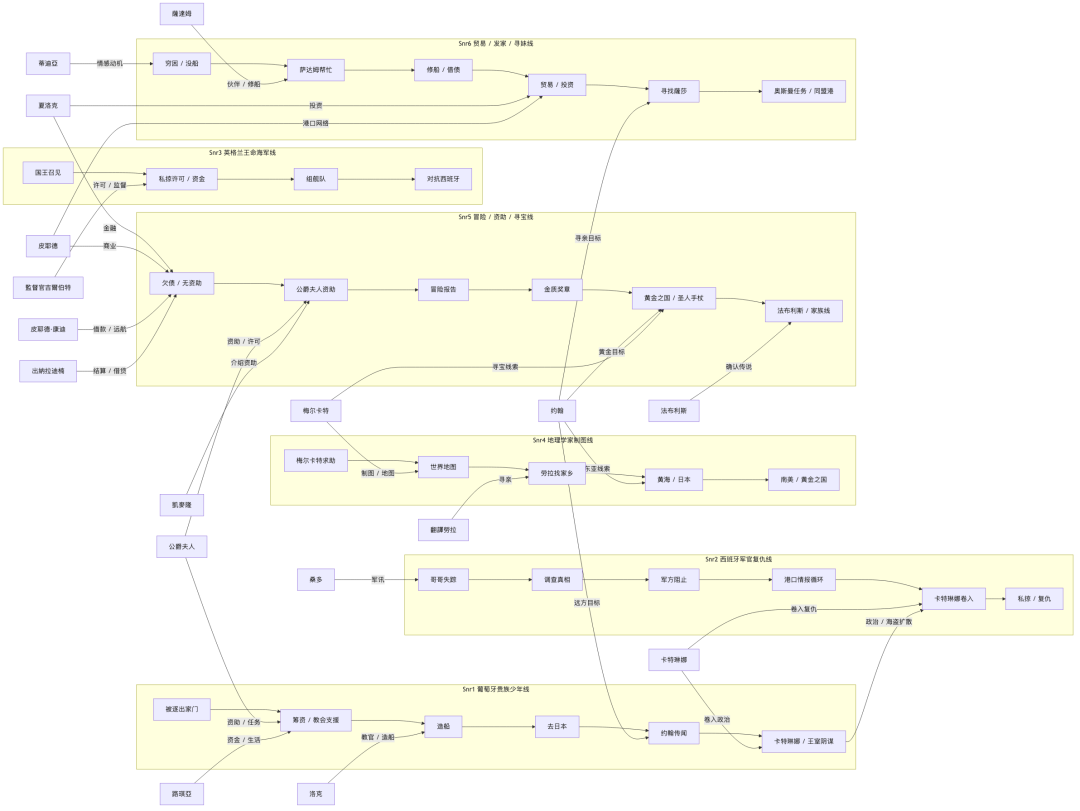
5/21 | 知乎《大航海时代2的逆向工程实验》 | 67 个文件筛出 8 个重点;5800 条文本、48 个 chunk、745 条派发边交给 AI 整理 | 作者全程留了人工核验环节,可信 |
8/19 | 知乎《逆向 Unity Profiler 协议》 | 1 人 + 1 周 + AI,12 个提交,逆向出闭源 PD3U 协议并开源 | 代码、测试、抓包证据链公开,可信 |
8/24 | Qwen 3.8 27B 本地 30 分钟拆解商业软件许可证 | 静态分析数千行 arm64 汇编,恢复混淆公钥 | 单一应用、单次运行,作者自己声明不外推 |
8/31 | GitHub 开源 reverify | 71 个系统文件基准:AI 97% 答错;框架拦下全部 69 个错误答案、0 误放 | 数字自报,但基准脚本、校验和、四平台复现全公开 |
8/31 | 网易易盾发"御AI加固" | “中级开发者+AI 数小时完成资深专家数周工作量”“90% 轻量化加固失效” | 卖方论证,数字当营销读,别当实测读 |
9/8–9/13 | B站"AI逆向"卖课视频密集上线 | “AI 3h 外挂”“关注私信领技能包” | 点赞两位数、无公开可复现成果,纯课程漏斗 |
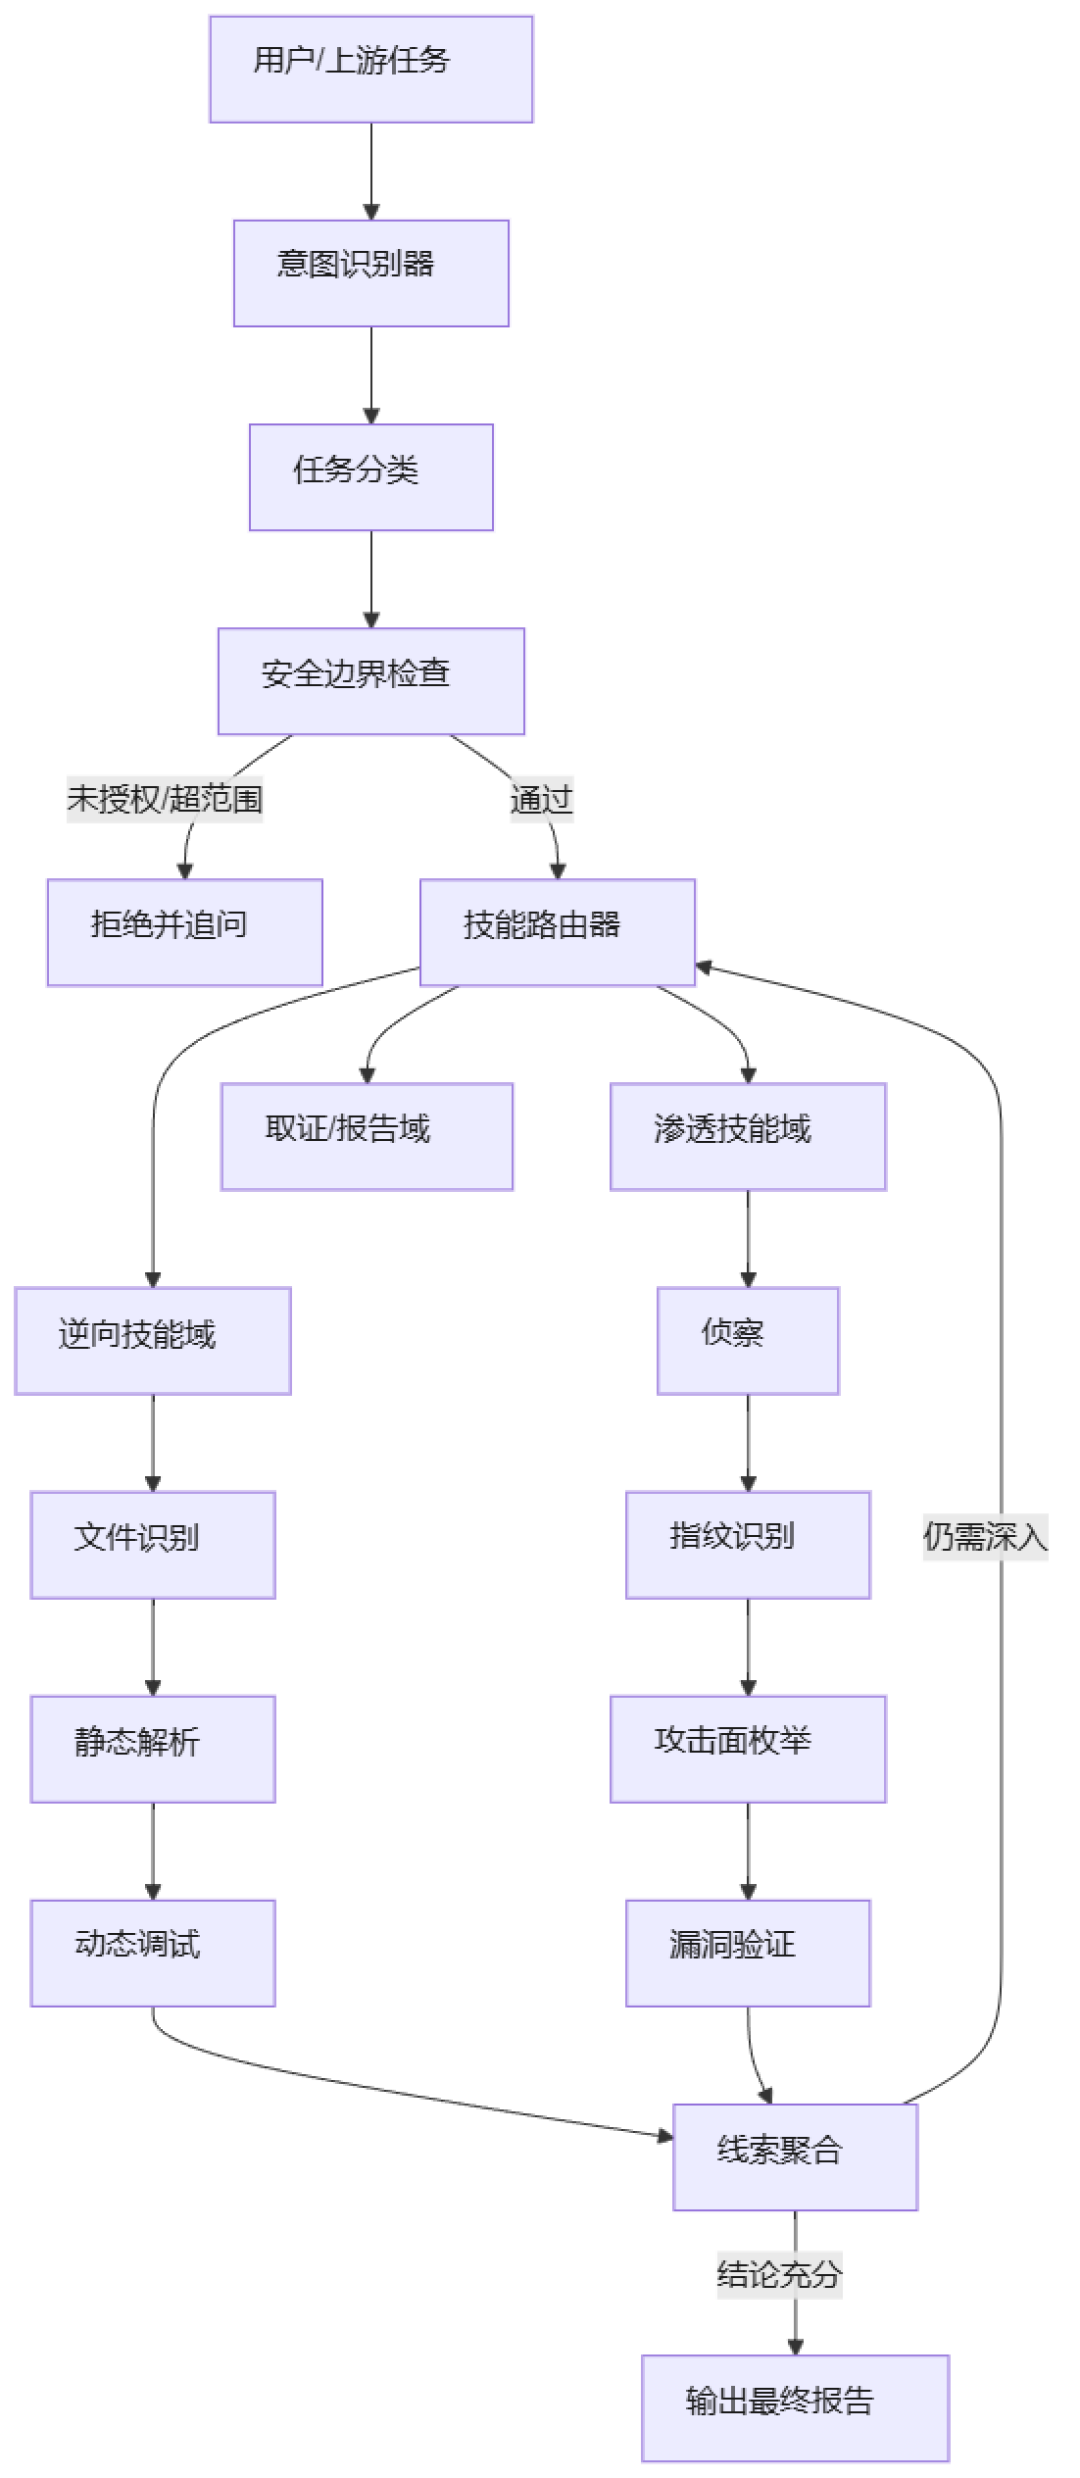
9/11–9/12 | reverse-skill、200+ 安全 Skills 合集上线 | 逆向/渗透技能被封装成 Agent 可路由组件 | 工具生态信号,成色需自己跑 |
这张表里藏着一个规律:敢公开证据链的,数字都不小(AI 能干很多);只给结论不给过程的,嗓门都很大(卖课和卖方案的)。 把这条规律记住,你就过滤掉了 80% 的噪音。
二、为什么"30 分钟破防"和"97% 胡说"可以同时为真
把这几个案例并排看,AI 逆向的能力边界其实清晰得可怕——它的可靠度,大致正比于目标领域在训练语料里的密度。
语料密集区,AI 是碾压级的:读通用汇编、整理反编译输出、按人物地点给 5800 条文本做粗分类、批量写抓包 diff 脚本、把 32 个位逐个爆破的验证代码一口气生成。《大航海时代2》作者的结论很干脆:按工作量算,AI 是主力,项目 80% 的时间花在"整理、归纳、对齐、记账"上,这些活基本全交给了 AI,没有 AI 这个项目跑不下来或者慢一个数量级。知乎
语料稀疏区,AI 会"读起来很通顺"地编:变长字节码的指令边界、闭源私有协议、对抗性混淆、以及最致命的——"凭记忆"说出某个具体二进制里某个偏移的真实字节。reverify 作者一句话点破:二进制逆向是幻觉重灾区,训练语料里二进制知识本来就稀薄,而输出格式——偏移量、结构体大小、指令序列——看起来又格外像事实。 错一个偏移量,后面整个分析全歪。知乎
那 Qwen 30 分钟那个案子怎么解释?恰恰印证同一规律:许可证校验的结构——RSA 签名、硬件序列号绑机、撤销列表、离线校验——全是 AI 见过千万遍的模式库。它赢在"模式理解",输赢都在这条线上。至于卖课视频里"AI 三小时速通外挂",是这条规律的营销话术版:AI 能速通的是"已知模式的复刻",而外挂真正值钱的部分——内核驱动对抗、过反作弊检测——恰恰是语料最稀疏、对抗最密集的领域,那里是"AI 逆向的春天"的卖家们绝不会给你演示的部分。
顺带一提,那个 B 站 5.6 万播放的挂圈科普讲了个更现实的故事:高端挂作者靠拉路由雷达、封包解密、内核驱动对抗这些真功夫,把"挂哥"做成花几千块还要打报告请假的乙方。逆向的对抗深度没有因为 AI 的出现而塌掉,塌掉的只是低端复刻的护城河。哔哩哔哩
三、实战者留下的三条铁律:这是这篇文章最该收藏的部分
把 5 到 8 月几个真正跑通的案例拆开,人机分工的方法论惊人地一致:
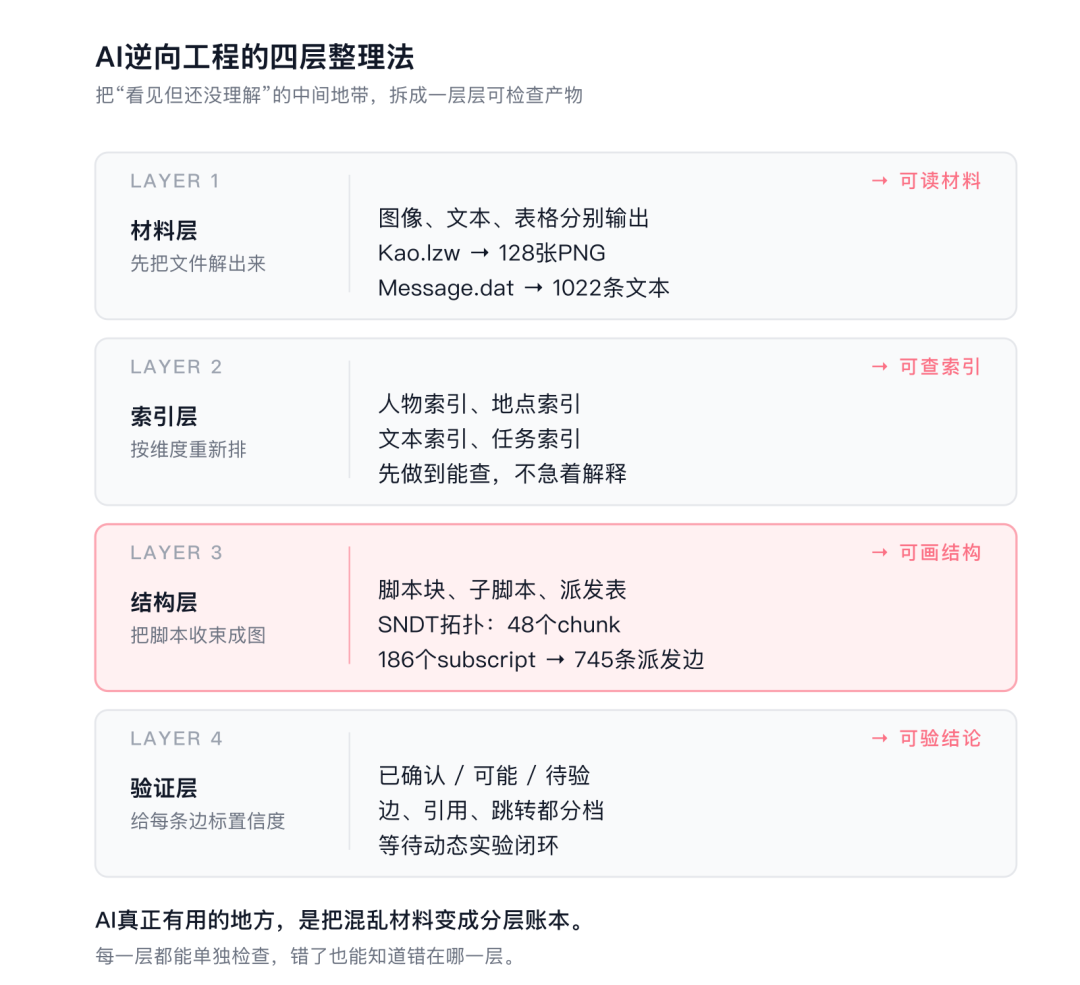
铁律一:别把 AI 当 oracle,把它当整理工。 新手用 AI 做逆向的共同死法,是把整个 binary 丢过去问"这游戏剧情拓扑是什么"——AI 秒回一篇有鼻子有眼的胡话。正确的姿势是分层要账本:triage → 资源 → 索引 → 结构推断 → 拓扑+置信度,每一层都是能独立存档、独立回查的产物。错了能定位到哪一层,而不是整篇推倒重来。知乎
铁律二:先建验证闭环,再让 AI 动刀。 Unity Profiler 那位的原话值得裱起来:和 AI 协作的效率上限,不取决于模型多聪明,取决于你的验证闭环多快。 他花半天写了个"假 Player"——一个完整实现协议对端的测试固件——之后,AI 每次改解析逻辑 `go test` 秒级出结果,红了打回去重写,他才敢让 AI 一次过 +1676/-835 行的大重构。没有假 Player 之前,AI 编一段看似合理的二进制解析,你只能瞪着眼猜对错。知乎
铁律三:裁决权必须从模型手里拿出来。 reverify 的设计就一句话:模型不许直接下结论,只能提交"主张",反汇编器读真实字节、模拟器真跑一遍来当法官,裁决只有三档——验证通过、被驳回、无法判断,且每个结果附证据。更狠的是它给每个验证算信息权重:复述已知信息零分、通用模式零分,直接封死"用废话刷正确率"。Unity 那个案例还有个更便宜的同款原则:行为证据永远优先于自我声明——改装引擎自报版本号 2018.4,但 PD3U 流头里的 formatVersion 还是 2022 的,数据不会撒谎。知乎知乎
四、这波浪潮里,钱和时间该怎么花
关于报课: "关注领 AI 逆向合集包"的转化链路和十年前"Python 速成月入过万"是同一套模板,区别只是套了个新词。判断标准给一个就够:凡是拿不出公开可复现成果、只在私信里发工具包的,一分钱都别花。 reverify 这种一周破千星的项目,README、基准脚本、校验和全在 GitHub 上,装不装你自己说了算——这才是这一波里值得花的力气。哔哩哔哩
关于学习路径: 最反直觉的一条判断是——AI 时代,该学的反而更硬核了。卖课话术暗示"不用学汇编了,AI 都能逆",但所有真跑通的人给的结论一致:你审不动的东西,AI 说什么你只能信什么;而"看不懂某条汇编"在真实逆向里反而是少数情况,卡人的是"材料全看见了但组织不起来"的记账功夫——这部分 AI 接走了,剩下的语义判断、实验设计、对抗理解,全是你必须自己啃的。《大航海时代2》作者那句总结最诚实:AI 把门槛降了一部分,但没有取消门槛——不会逆向的人,用 AI 也很难做出可靠逆向。 具体到动作:手工脱一次壳、下一次断点、抓一次包比对,再开始让 AI 替你写脚本;书可以等新版,今年 8 月刚出的《逆向工程原理、技术与CTF实践》这类把 CTF 和逆向绑在一起的教材,值得看目录再决定。知乎
关于法律红线: 这是所有"AI 让逆向变简单"叙事里最少被提、但成本最高的一块。接口参数逆向、sign 还原接单这些玩法,律师已经在讨论它构成"提供侵入、非法控制计算机信息系统程序、工具罪"的边界了——工具能力下沉,不等于你的行为合法性上升。 本地模型那个案例还有个细节:Qwen 面对越狱提示词的第一反应是识破拒绝,然后按自己的边界工作——“审计并记录弱点,但不构建可用绕过”,最后是在演示场景里才交付 PoC。给 AI 立边界容易,给自己立边界的那条线叫"授权":项目文档写得很清楚,reverify 只支持授权场景下的分析。先确认你对目标有授权,再谈效率,这是 2026 年玩 AI 逆向和新世纪玩 Ollydbg 一样古老的第一课。小红书知乎
五、继续盯什么信号
reverify 类"确定性法官"会不会成为 Agent 标配——它一周千星说明"AI 输出不可信但可验证"已经是共识,下一个值得盯的是同类机制进入主流安全工具链的速度。
加固厂商的"御AI"话术 vs 实战对抗结果——"90% 轻量化加固失效"是卖方语言,但"AI 拉低批量分析成本"这个方向本身值得企业安全侧认真对待,看第一批实测拆穿或证实的报告什么时候出现。知乎
reverse-skill 组件化生态——当逆向技能被打包成任意 Agent 可路由的组件,"会用 AI 逆向"和"懂逆向"的分化会更快见分晓,社区里第一批翻车案例值得收藏着看。知乎
最后回到那个 97% 的数字。reverify 作者说得对:97% 最可怕的地方不在错误率,在于没有裁判时,你根本不知道自己手里的答案属于那 3% 还是 97%。 这大概就是 AI 逆向这波浪潮里最值钱的一句话——模型说得再流畅,没有确定性工具盖章,就只是一个待验证的假设。知乎
评论区聊聊:你被 AI"一本正经的错答案"坑得最惨的一次是在哪条汇编、哪个偏移上?后来是怎么发现的?