
9月21日傍晚六点,NVIDIA官方公众号发出一条云栖大会"展商剧透":9月22日到24日杭州国际博览中心,NVIDIA展区2号馆算力馆2-C02,"DGX Spark片区"里除了魔搭社区选手作品和超聚变FusionXpark,白纸黑字写着——新华三LinSeer MegaCube桌面级AI工作站。微信
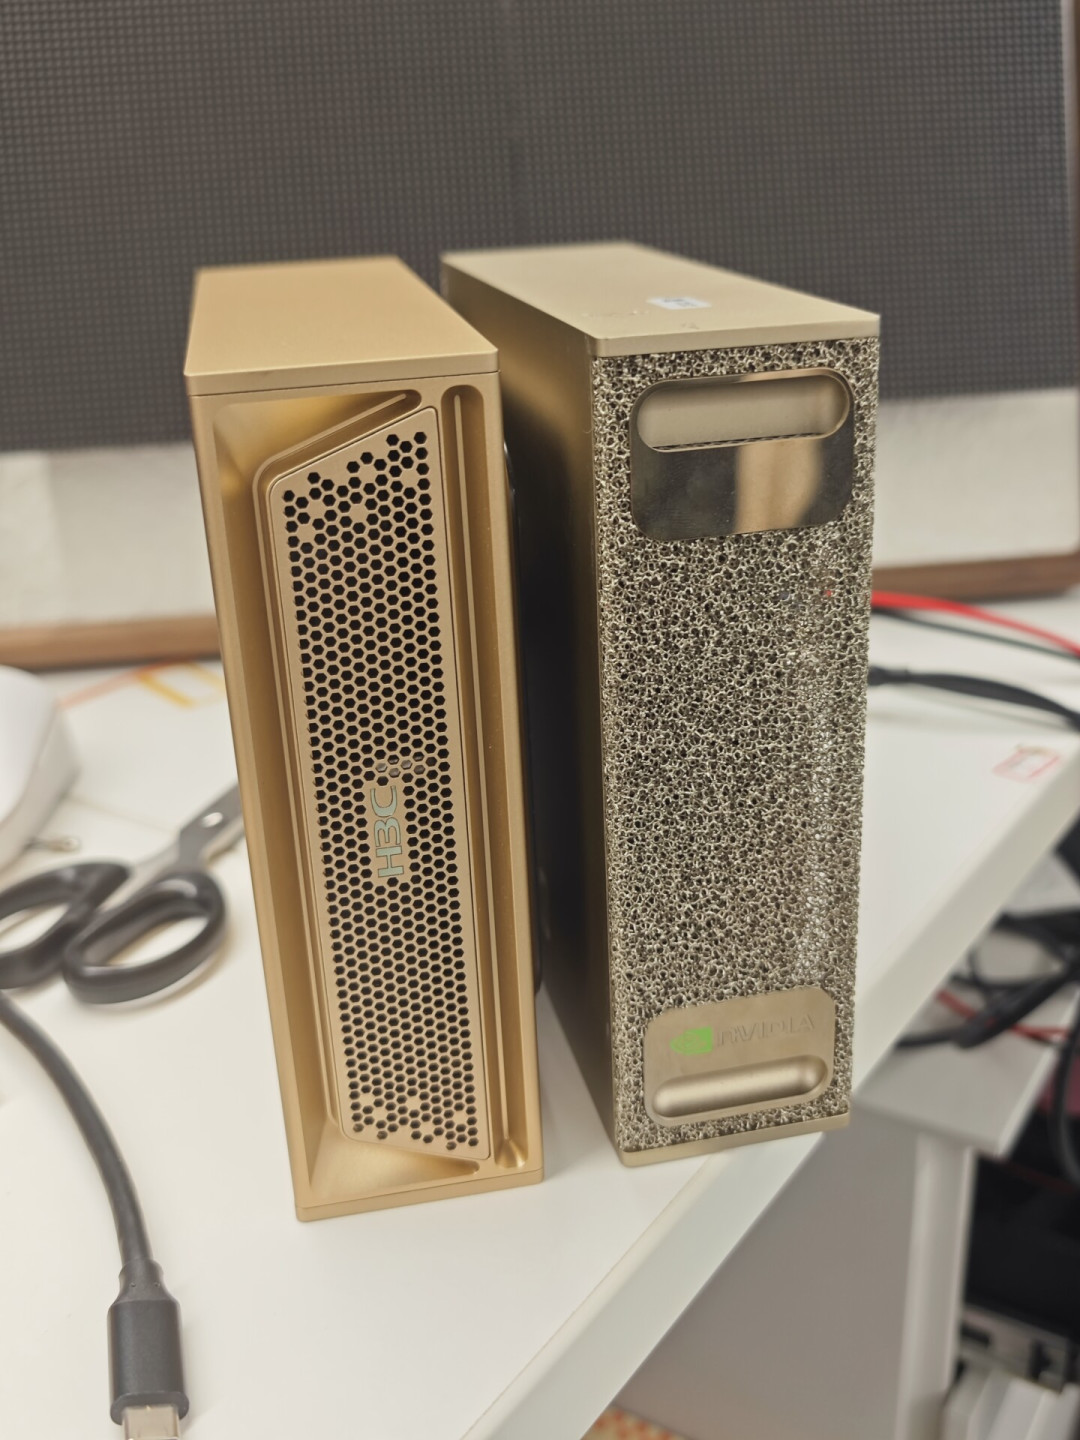
这台机器2025年12月9日发布,官方指导价36999元,金色的,150×150×51mm,明天起要和一块"小金砖"DGX Spark挤进同一个片区展出。
如果你这半年刷过DGX Spark的开箱帖、在"3万多的盒子到底能不能回本"这个问题上犹豫过,这篇不是让你看热闹的。云栖把它顶到台前,恰好是一个把账摊开算的时点。这篇只服务一类人:懂GB10是什么、知道Spark行情、正在"直接买盒"还是"自己攒双机/四机"之间摇摆的本地大模型玩家。GB10是啥、MoE是啥,不再从头讲。
第一本账:36999买的是什么,和"三万多"的公版差在哪
先把发布时的账面规格摆齐:GB10 Grace Blackwell超级芯片、1 PFLOP FP4算力、128GB LPDDR5x统一内存(系统可见约121.7 GiB、20核CPU)、预装英伟达DGX OS和CUDA工具链,单台标称支持200B参数模型推理、70B模型微调;内置英伟达Connect-X网络,两台串联可跑405B(官方举例Llama 3.1 405B双机)。微信
再看社区行情:截至9月初,知乎Spark玩家的普遍口径是"国行3W+、涨是涨了点,但是按比例很低","理财产品"都成了这台机器的社区外号。 同期讨论里,双机200G QSFP直连跑DeepSeek-V4-Flash 284B已经是成熟玩法,公版一台的行情价就已经贴着36999走了。知乎
差别不在芯片——GB10都一样——在三个词:预装、售后、集群参考设计。MegaCube近期版本预装了OpenClaw,走的还是华三ToB那套商用风格;更关键的是它不是"卖完就不管",新华三从9月开始按"场景实测"的方式持续放数据。这就是后面几本账的由来。
第二本账:9月放出的两组实测数字,哪些能进你的决策,哪些要打引号
单机账(9月9日实测,Qwen3.8-Flash-Next-NVFP4):一个约133GB(123.57 GiB)权重、系统可见内存只有121 GiB的账,跑起来了。 别急着喊"内存倒挂"——拆开看是五个动作拼出来的:NVFP4主干权重常驻、约50GB的PLE表走staged模式按token需求从NVMe分批搬运、MTP草稿层常驻、KV Cache切FP8、再用max-num-seqs=6、批上限4096、显存水位0.80三个参数留余量,服务运行峰值约108 GiB。换句话说,"128GB装下133GB"说的是完整检查点在本地NVMe、只有一部分常驻内存,不等于133GB全驻留——这是看所有"XX GB跑XX B模型"标题时的通用防忽悠条款。微信
性能端:关掉MTP单流生成中位数17.8 token/s,打开MTP=3跑到42.8 token/s、TTFT 0.28秒,约2.4倍提速只换0.04秒首token等待。 但任务类型差异巨大——Coding/JSON/HTML在44-46 token/s,Prose/Narrative掉到28上下;6并发聚合66.6 token/s、单请求降到21.1。微信
四机账(9月14日实测,4台MegaCube经H3C S9855交换机组200G RoCE,TP4跑DeepSeek-V4.1-Flash):单并发八类任务平均单流44.22 token/s,并发拉满C6时平均聚合吞吐140.22 token/s——约为单请求的3.6倍,单流同时降到27.34;视觉与工具调用7项用例全过。 约13万、26万token输入的固定口令检索都返回正确——但两次请求的首token延迟分别是226.1秒和584.0秒,接近"提交任务、泡杯茶、回来看答案"。测试方自己也把话说得很克制:服务上下文配置300k,不等于验证了模型声明的1M;只测了固定口令检索,不代表任意长文推理正确率;代码用例没有执行单元测试。微信

要打的引号也在这里:这两组是新华三侧放的实测,不是第三方盲测。对玩家来说,可信的用法是把它当"这套组合的部署基线",而不是"我买回去的第一晚体验"——尤其那台S9855,是账里的隐形成本(见下一本)。
第三本账:集群到底是买盒子,还是买"免踩坑服务"
把知乎上半年的踩坑时间轴拉出来,就知道"官方集群方案"卖的是什么:5月26日,两台GB10跑DeepSeek-V4-Flash的完整调试记录里,12个尝试全部失败,根因是flash_mla不支持SM120。 到9月10日,"500GB的DeepSeek-V4.1-Flash、四台DGX Spark真的没法跑吗"还在吵——社区对"512GB内存装510GB权重"这道算术题的焦虑一点没散。 中间虽然陆续有人晒出双机TP2一天搞定、双机74 token/s的复盘,那是拿周末换来的。知乎知乎
社区玩家的解法是:翻开发者论坛分支、打补丁、换推理引擎、用llama.cpp回退vLLM。新华三给的解法是出厂就按参考设计组网:节点经QSFP接入H3C S9855交换机,使用200G RoCE互联,模型以TP4方式协同推理,基线数据直接公布,两台串联405B写进产品定义。微信

这笔账没有标准答案,只有适配:折腾能力=时间且享受过程的,公版+社区方案更便宜也更自由;把周末当稀缺资源、要的是"开机有OpenAI兼容API"的,36999的溢价买的就是这段踩坑路。注意四机方案还要加上S9855这类200G交换机的采购位——单机堆料之外,组网是另一笔钱,这恰恰是华三的老本行,也是它和纯盒子厂商拉开差异的地方。
第四本账:时间点——为什么"现在"两头不是人
往前看:知乎已经在传"英伟达正式宣布各大OEM厂商将在十月份全面售卖RTX Spark系列电脑",笔记本形态、32GB起步的配置上限还有争议,价格仍是未知数。 加上超聚变FusionXpark这类GB10 OEM机已经在云栖Spark片区和华三同台,"小金砖"从独苗变成一排,"上市不降价反涨价"的窗口很难一直维持。往后看:GB10这一代桌面盒子的性能天花板就摆在那(单流40+ token/s、双机405B、四机跑V4.1-Flash基线),10月大概率不会让这三条线发生质变。知乎
所以当下三条判断,按人群拆开:
急用双机405B/多机集群、又不想折腾驱动和分片的——云栖现场看实物、问清S9855组网包报价后下手,MegaCube是当前最接近"交钥匙"的GB10选择;
单人尝鲜、时间富余的——公版Spark+社区方案总价可能更低,且OEM涌入后行情有松动可能,等10月RTX Spark开售价签;
手里已有Spark、纠结要不要凑双机/四机的——先把9/14那份基线当容量规划表用:你等的到底是token/s,还是那584秒的TTFT。
明天去云栖现场,值得盯的三个可验证信号
新华三自己的展位在算力馆2-E01(9月22-24日),将携下一代超节点及最新发布的网络、计算、存储等多款产品实物亮相展区。 9月23日上午它还有一场"打造Token极致性价比——下一代智算关键技术创新论坛",下午要上UALink联盟的超节点Scale-Up互连分论坛——对桌面盒子玩家来说,这些都比不上现场三件事有用:微信
MegaCube实物旁有没有公开价签和"双机/四机整套落地价"——串联是产品定义里写的,交换机算不算在方案包里,现场问一句比猜一周准;
预装OpenClaw/DGX OS的版本能不能当场跑一个你常用的模型——"支持200B"是参数话术,现场让演示跑你自己的提示词才是证据;
超聚变FusionXpark的展牌价——同一片区、同一颗GB10,两台机器摆一起,差价就是你为"华三式售后+组网"支付的报价。
对不上号的人也别硬上:这台机器服务的是"把本地大模型当生产力、又不想当运维"的那一小撮。剩下的玩家,等10月的价签、等云栖现场流出的实拍和二次实测,都不会亏——GB10不会跑,你的prompt也不会变质。













