9月20日晚阿里开源Qwen-Image-2.1,9月23日Unsloth的GGUF量化版落地,入场券直接压到6GB显存和16GB内存的Mac。三天里社区口碑走完一个"封神→骂惨→再翻案"的循环。如果你的笔记本是6-8G显存,以前在ComfyUI整合包里跑过SD、被Flux的速度劝退过、平时用云端生图还担心素材上传,这两天大概率在纠结同一件事:这卡到底能不能跑、工作流值不值得换。
把这三个天的实测数据摆在一起,结论其实很清楚:同样一个模型,配置对了出图60秒,配置不对要么5分钟,要么灰块,要么直接崩。口碑反转里喊"拉"和喊"神"的人,差的不是显卡,是用法。
一、先看时间线:为什么"拉"和"神"会同时出现
9/20晚:官方开源。视觉生成部分只有7B(32层Single-Stream DiT),文本编码器是8.77B的Qwen3-VL,VAE是64通道RGBA,原生2048×2048输出、文生图与编辑一体、最多10张参考图、直接生成透明PNG。微博知乎
9/21:ComfyUI当天更新到v0.37,环境、模型、工作流全部跑通。同一天,有4090用户用196张图实测把这个模型的强项短板摸了个遍。另一边,"文生图一般、文字崩坏"的吐槽开始出现。知乎知乎
9/22:腾讯混元HyImage 3.5 preview等同批发布,9月成了国产文生图"疯狂上新"月;社区自量化踩坑帖密集出现,"自己量Q4出灰块"问得最多。
9/23:Unsloth Dynamic 2.0量化版来了,4-bit模型体积只有4.2GB,“Mac 16G玩家可以搞起来了”。有B站UP主实测100多张图后把锅归到提示词和用法上——开源三天,社区评价反转了三次。他还提到官方PE提示词增强模型更新后,一段流程从340秒降到6秒。小红书哔哩哔哩
也就是说:第一波"拉",主要卡在两件事上——低显存机型的权重搬运和文本编码器落CPU,以及提示词用法没跟上这个新模型;第二波"神",是量化把门槛补齐、工作流跑顺之后的事。两边都没说谎,但都只对了一半。
二、显存阶梯:你的卡跑到哪一档,出图要多久
把三天里小红书、知乎、B站能验证的实测数字汇总成一张阶梯(出图尺寸、步数不统一,看量级别看秒表):
你的配置 | 已被验证的路子 | 真实体验 |
|---|---|---|
GTX 1050(2G) | 社区Q4_K_M GGUF | 约15分钟一张,能跑,纯成就感 |
3060笔记本(6G) | Q4_K_M GGUF,20步、1216×832 | 不挂加速节点4-5分钟一张 |
4060笔记本(8G) | int8文本编码器全上GPU,或diffusers 4bit-nf4+CPU offload | 评论区实测:int8+加速节点单图约60秒、双参考图90多秒;offload路线数分钟一张 |
RX 7900XT(ROCm) | 8bit量化 | 约100秒一张,但简单提示词构图不如专门的动漫底模,偶发肢体错位 |
16G+显存 | BF16全家桶要offload/量化,int8起舒服 | 2K、高步数随便玩 |
48G 4090 | 全精度+VAE分块 | 1024²下0.526秒/步;开分块后峰值36.8GB与分辨率脱钩 |
Mac 16G / 128G迷你机 | GGUF 4-bit 4.2GB;Strix Halo统一内存实测 | 能进门;迷你机用户"安静画完一张图" |
这张表里有两个关键读法:
小卡的瓶颈不是7B主体,是那个8.77B的文本编码器。 知乎用户完整记录过一次排障:lowvram模式下ComfyUI直接把文本编码器钉死在CPU,fp8量化也只是部分算子回GPU;改nodes.py强制它上GPU后,日志显示文生图31秒出图。这个坑在SD 1.5时代不存在,换模型的人都会踩。知乎
量化版确实有画质代价。 有7900XT用户反馈8bit量化下简单提示词的构图不如专门的底模,有时还会出现肢体错位。小红书用户自己也承认写实人像"稍微有一、、假"。4-bit是用画质换显存,卡越小,这笔交易越肉眼可见。小红书
三、量化路线怎么选:33GB→12GB→4.2GB
目前能落地的三条路:
官方BF16:权重30GB出头,8G显存卡想都别想,这条路是给24G以上准备的。
diffusers 4bit-nf4 + 顺序CPU offload(4060笔记本用户的路):只量化文本编码器和transformer,VAE保留,量化完大约12GB放进内存,按"编码器→transformer→VAE"的执行链把模块轮流搬进显存。8G显存能跑通,代价是权重搬运时间,出图分钟级。知乎
社区GGUF Q4_K_M(Unsloth Dynamic 2.0):4.2GB,ComfyUI配GGUF Loader直接读,6G显存就能整模型驻留,当前小卡首选。自己动手量化的注意:Q4出灰块大概率是校准集不够或参数没调对,社区共识是换Q4_K_S或先过一遍Q5_K_M验证。小红书
A卡用户多一条:图生图直接段错误的话,根因是ComfyUI对RDNA3默认禁用了cudnn、撞上新模型的Conv3d;代码里留了口子,启动环境加`COMFYUI_ENABLE_MIOPEN=1`即可跳过。另外`MIOPEN_FIND_MODE`保持默认别改成0——有人改成0后首次出图从36秒飙到325秒。知乎
四、那些"文字崩坏、替换失败",其实是用法题
196张图实测帖和社区踩坑帖交叉下来,能直接抄走几条:
文字渲染是像素预算题,不是能力题。 三级字号的中文海报一字没错,但九宫格缩略图里约10px字高就崩——实测字高≥20px才稳定。要做小字密排的商品详情图,先把出图分辨率提上去,或者把字做大。知乎
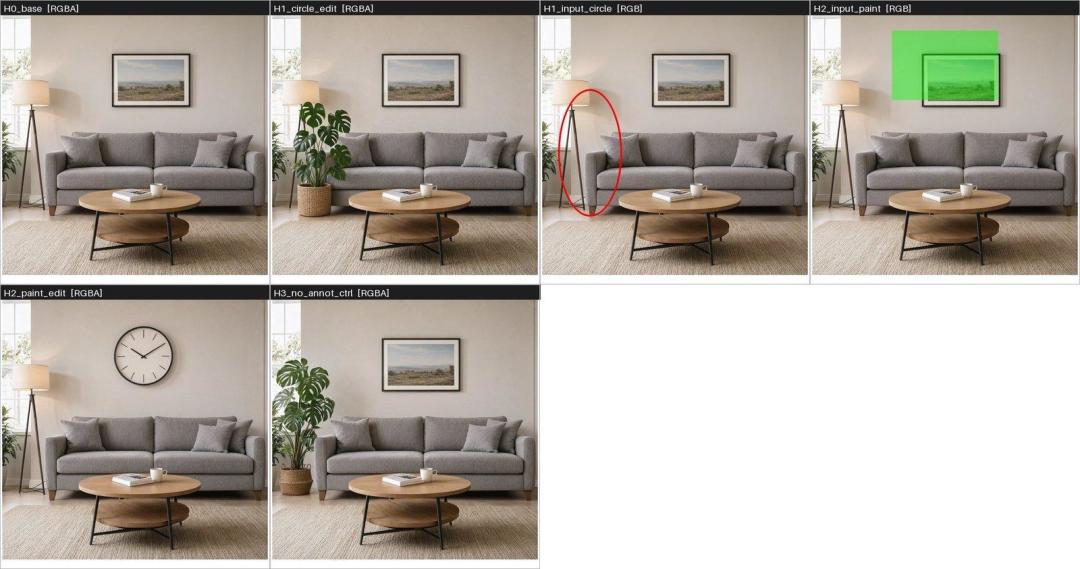
“把A换成B"经常退化成"添加B”,而且整图会重绘。 强改动像素只占1.32%,但外接框覆盖全图,非目标区域有"呼吸感"。标注本身是读得懂的,问题出在替换语义上——工程绕法就是拆两步:先删A、再加B;要求像素级不动的区域,在外部用mask把原图贴回去,模型自己不保证这件事。
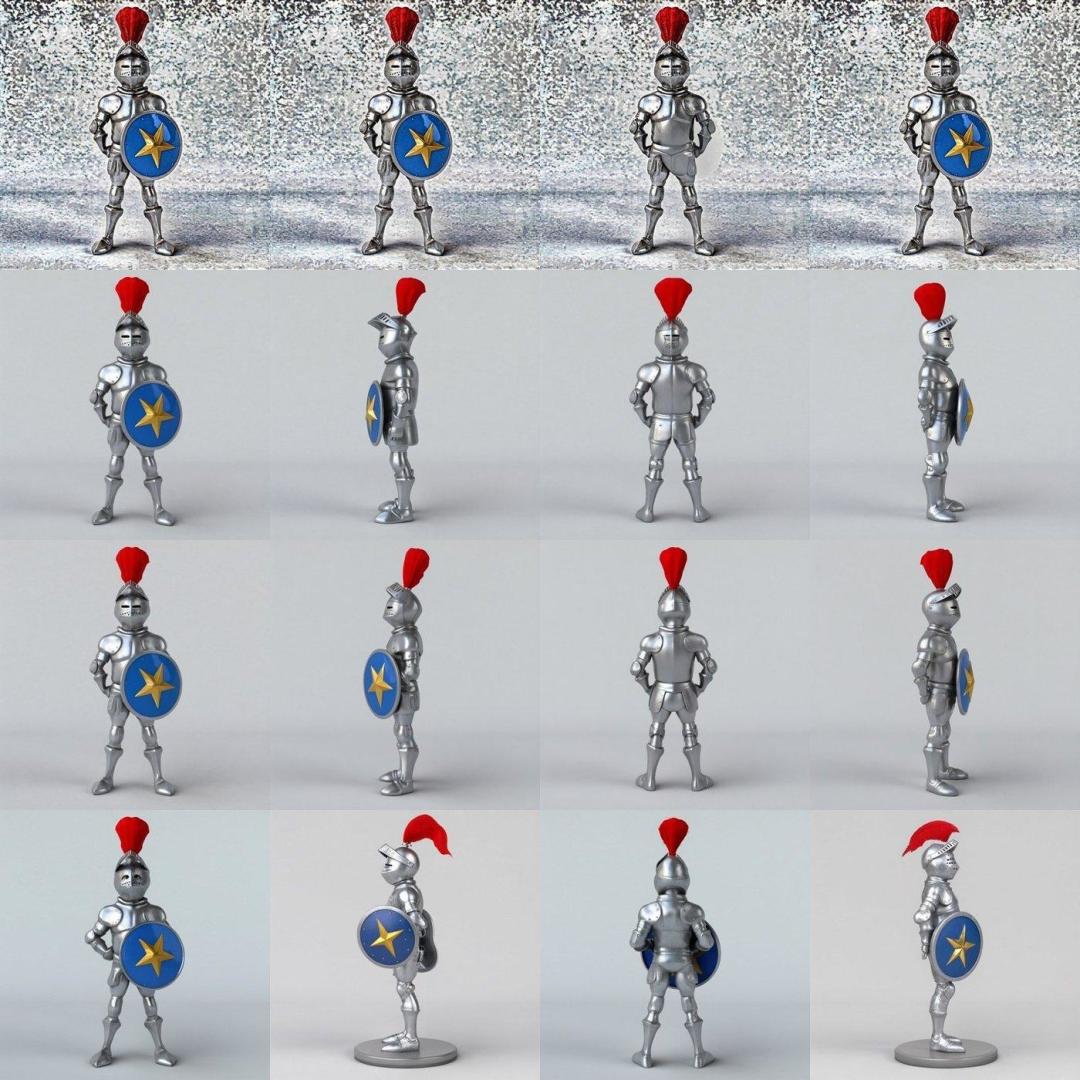
它听不懂"rotated 180 degrees",但听得懂"seen from directly behind"。 视角实验里,自然语言方位词八个方位全部命中,左右对称方位的响应差值只有0.04。指令没响应时,先换seed再怀疑模型——带参考图时某些seed会让视角指令整体失效。
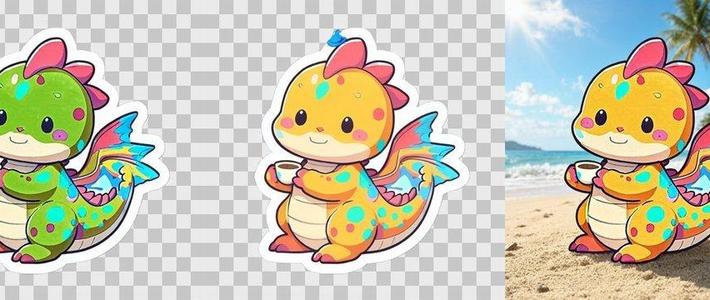
真正的杀手锏是原生RGBA透明。 玻璃杯能透过杯身看到棋盘格,那张样张是48.2%全透明、47.6%半透明、4.2%不透明,而没要求透明的对照组100%不透明、不乱发alpha。改色保留透明底和模切白边——贴纸、图标、商品图能省掉SAM/BiRefNet那一环,这就是"抠图硬刚BiRefNet"那批实测帖的底气来源。知乎
步数加速节点是速度叙事的一半。 四步LoRA实测帖的标题就是"4步就出图,这速度真的离谱"。T8加速节点"5倍vs2倍"的对决帖一天冲到77赞35评。这些叠在2K输出上,才是"60秒出图"的完整配方。哔哩哔哩哔哩哔哩
五、谁现在该动手,谁再等等
建议动手:
做商品图、贴纸、角色立绘、图文海报这类"要拿去用的素材"的人——原生透明+中文排版+10图身份保持全命中,换工作流成本最低;
6-8G显存笔记本、一直没进门的人——Q4_K_M这条路本周才真正打通,零成本试错;
已经在"Qwen-Image-2.1出图→MiniMax-H3图生视频"链路上的人——H3权重8月3日上传HuggingFace,开源三周全球下载量突破2400万次,公开衍生模型超过300个,整合包和工作流已经是现成的。知乎
建议观望:
动漫风格党和写实人像党——量化版的构图和"假感"还没被社区消化完,8G档和专门底模、云端旗舰仍有肉眼差距;
需要"就地替换、其余像素不动"精修流程的人——替换退化目前只能靠两步法+外部mask绕,不算能直接交付的功能;
企业内网部署——壁仞科技已在壁砺166M上快速完成该模型的推理适配验证,但官方README五百多行没有safety、水印、内容政策任何一个章节,风控得自建,这部分成本和合规评估没算在显卡账里。微博
接下来盯这些信号:混元HyImage 3.5 preview的下一步开源动作、官方是否放更小规格的文本编码器或原生量化、GGUF生态对加速LoRA/ControlNet类节点的兼容补齐、以及MiniMax-H3整合包在16G以下显存的视频生成体验。
一句话收束:Qwen-Image-2.1这波确实把本地生图的入场券从"4090起步"发到了"6G显存可进",但发的是入场券,不是会员证——出图60秒还是5分钟、是"神"还是"拉",取决于你落在显存阶梯的哪一档,以及上面那几个坑你踩没踩过。