内存涨成这样,本地跑大模型反而有了个新理由
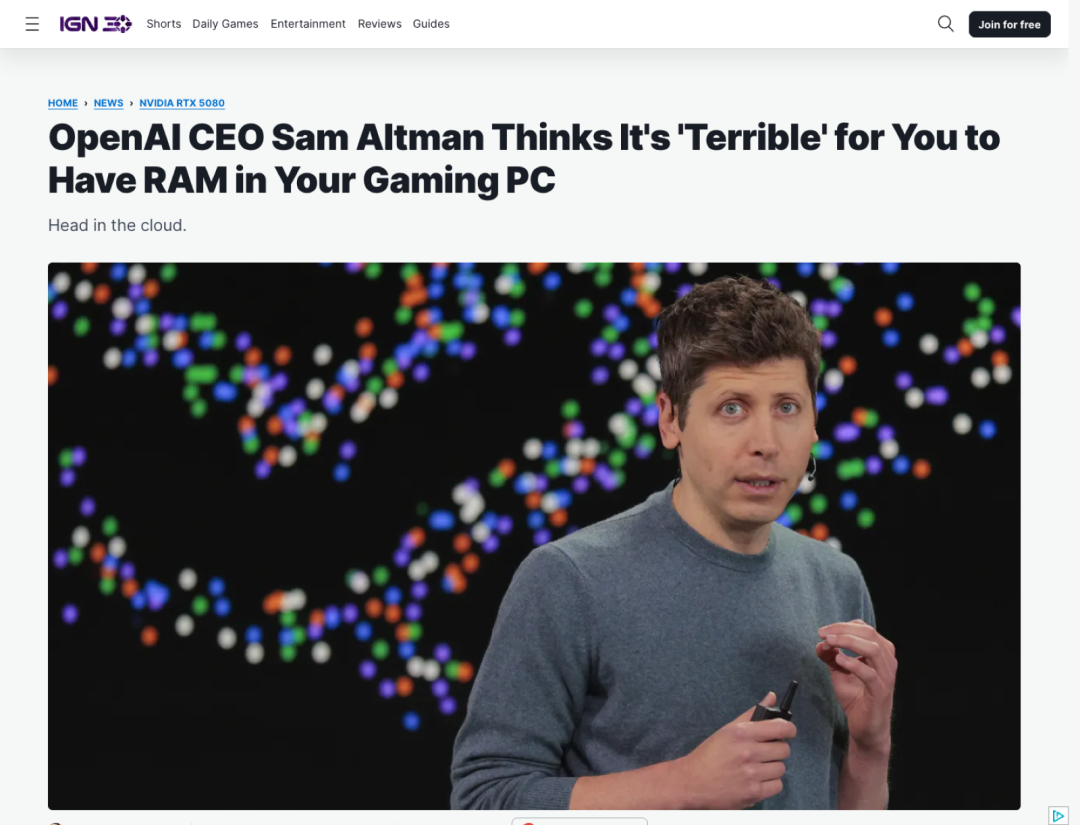
奥特曼最近的话让想本地部署的人听着刺耳:全世界内存本来就紧张,却分散在一台台个人电脑里,大概只有 5% 的时间在被真正用上——从全球资源配置的角度看,这相当糟糕。这话出自 10 月 29 日上线的一档播客节目,主持人是 Stripe 联合创始人 John Collison。马斯克的回应很短:人们也该有内存。知乎哔哩哔哩
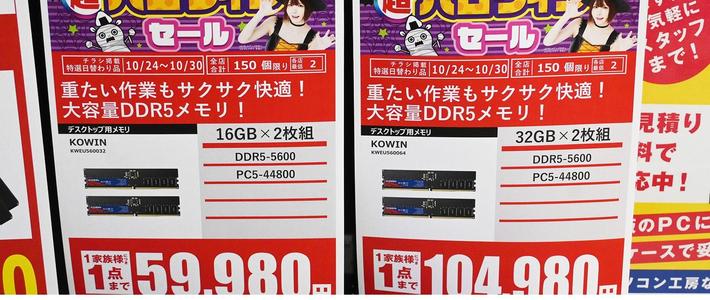
奥特曼说的背景是真的。TrendForce 数据显示,2026 年一季度常规 DRAM 合约价环比上调 90% 到 95%,PC 用 DRAM 价格预计至少翻倍。另一组被广泛引用的数字来自日本秋叶原市场:一套海盗船 DDR5-6000 128GB(64GB×2)内存,从去年 10 月的 59,800 日元涨到 514,800 日元,折合人民币约 2.18 万元,一年涨了 760.9%。知乎知乎
问题是,他说的"5%"站不站得住?
这个数字是他随口给的估计,原话里带着"maybe",谈不上是测量值。内存的作用从来不是"平时用满",而是"要用的时候在"——你买 32G,图的是打开一个大工程文件时不卡死。IGN 在报道里也点了一句:Altman 好像以为大家买内存都是为了跑本地 AI,但内存是几乎所有消费电子产品都要用的东西。知乎
不过,把卖云端算力的人这话当成纯粹商人立场扔掉,也不划算——他无意中点破了一件对普通人很重要的事:内存确实是现在本地跑大模型的核心,而这一点正在被大量教程用显卡数字盖住。
最近被反复讨论的例子是 DeepSeek V4.1 Flash。它有 763B 参数,全量权重要 508GB,有人在 12GB 显存的 RTX 5070 上把它跑了起来。靠的不是魔法:它用的推理引擎,核心原理是把高频访问的热门专家放进显存,其他的专家放在内存,大容量 n-gram 表放在 SSD。放到这套方案上,就是把 508GB 的权重压到 138GB,828 个专家留在显卡,其余的从内存和 SSD 现场读取。哔哩哔哩知乎
速度和代价都很具体:短回答每秒 11 个 token,23000 token 的长提示词要等 41 秒才出字。权重虽小,加上 n-gram 表等整套文件,下载量仍要 257GB,内存门槛 46GB——点赞最高的留言说的就是这事:看到标题以为门槛不高,结果一看还要 257G 硬盘和 46G 内存,“我的硬盘先开始紧张了”。哔哩哔哩哔哩哔哩
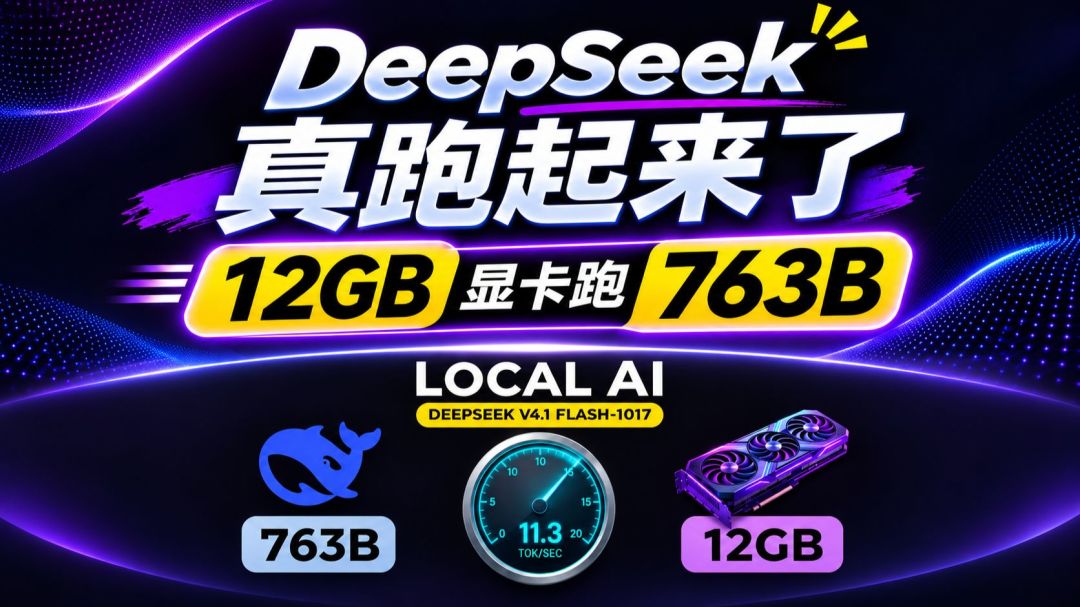
这套方案测下来的结论也很直接:真正决定你能跑多大模型的,是内存容量、SSD 带宽和压缩质量,而不是显卡本身。哔哩哔哩
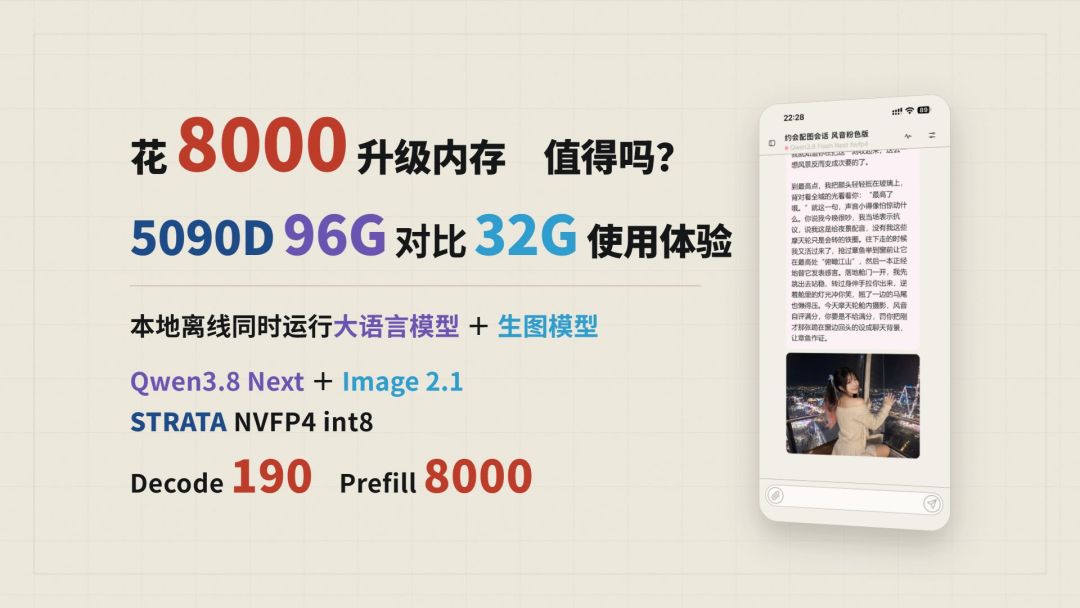
内存有多关键,还有更直接的对比。一位博主用 5090D 同时跑本地大模型和生图,在内存涨价最凶的时候花 8000 块把 32G 升到 96G:解码速度本来就不慢,但预填充——出字前的那段等待——从 11.4 秒降到 3.9 秒。哔哩哔哩
他自己的总结很到位:这 8000 块买的其实不是跑分,是"不用再等"。当然也有代价:显存被模型占掉大半、系统只剩 2G 预留,QQ 微信都不敢挂后台的紧张感一直在。哔哩哔哩
所以回到奥特曼那句话,换个角度看反而更有用:连做云端生意的 OpenAI 都要专门吐槽个人电脑里插满内存这件事,多少说明本地部署这条路,已经有足够多的人走通了。
这就是那个新理由:现在的真实门槛排序是内存 > 显卡。
一张 8G 显存的卡,配上足够的内存,能跑的模型比多数人想象的多。DeepSeek 是极端例子,更常见的是 35B 到 125B 的 MoE 模型:有博主在一台 8G 显卡(功耗墙 35W)的笔记本上实测,35B-A3B 跑 Q4 量化能到 200K 上下文、40+ token/s。甚至有博主用 500 块收的 64G DDR3 内存加洋垃圾 E5(二手服务器 CPU),在本地跑起了 128K 上下文的 125B Agent。哔哩哔哩哔哩哔哩
但有两个前提得说清楚。
第一,"能跑"和"能用"是两回事。压缩到极限的模型,日常聊天、读文档、看图都没问题,AIME 数学题也能四道全对;可一到写代码、做操作类任务就撑不住——12G 显卡跑 763B 那套方案,最难数独和表达式解析器都栽在小细节。这不是个例,另一条实测留言也说,聊天读文认图全能,一到写代码就掉线。哔哩哔哩哔哩哔哩
第二,内存现在买,是真的贵。前面那套 2.18 万的 128GB 是极端案例,但主流规格同样承压:DDR5-6400 64GB 套装在日本市场报 139,980 日元。知乎
更麻烦的是供应端。TrendForce 在 10 月 30 日的报告里还提醒,部分供应商正在减少 PC DRAM 产出、转向服务器产品,预计 2027 年供应可能进一步收紧。也就是说,这轮内存涨价短期看不到回头迹象。知乎
所以我的判断是:别为了"跑个大模型"去追高内存。
如果你的机器是 32G 内存加一张 8G 以上显卡,够了,直接装 Ollama 或 Strata 试试 35B 量级的 MoE 模型。如果想升级内存,只需想清楚一件事:这笔钱是给日常工作买的,还是给一个"可能用三回"的玩具买的。
至于那些教你"12G 显存跑 763B"的教程,看看就好。技术路线是通的,但不代表你该照着买——压缩得越狠,能力就越可能在关键任务上打折。
内存该不该买,你自己定。但"本地跑大模型"这件事,现在确实比一年前容易多了——容易到连奥特曼都开始抱怨了。