

11月18日,英伟达RTX Spark紧凑型桌面主机正式上市,华硕、机械革命、微星三家机型首批开售。官方资料里被引用最多的一句话是:可以本地运行1200亿参数大模型。上市后的几天里,多家评测媒体放出了真机实测,给出的答案更细——128GB版本实测把176B参数的模型完整跑完了一整轮高压智能体任务,而一个70B的稠密模型只跑出每秒7.34个词元,反而不如13B的小模型快。"跑得动多大"不是一个数字,要拆开三道关:装不装得下、快不够快、几个人能一起用。知乎知乎知乎
先摸清这台1.1升的盒子
RTX Spark不是某种小显卡,而是NVIDIA与联发科合作打造的N1X超级芯片:20核Grace CPU加6144个CUDA核心的Blackwell架构RTX GPU,最高128GB LPDDR5X统一内存,FP4理论算力1 PFLOPS,运行Windows 11 on Arm。它和常规迷你PC最本质的区别在内存:CPU与GPU通过NVLink-C2C实现600GB/s的双向带宽互连、共享同一块内存池,128GB版本的内存峰值带宽可达300GB/s。知乎知乎知乎
用户还能通过NVIDIA App划定划给GPU的"显存",128GB版本默认62.5GB、最高可以划到96GB。桌面形态把处理器功耗上限从此前笔记本形态的85W推到了140W。它的角色是一台全天候在线、专跑本地模型和智能体的专用盒子,而不是替换你的主力电脑。知乎知乎知乎
装得下这道关:官方1200亿是安全线,不是天花板
参数量只是账面数字,换算成权重体积才算数——判断一个模型能不能运行,不能只看参数量,还要考虑上下文长度、并发数量和运行时开销。一个27B—32B稠密模型,FP16精度下单是权重就要占去50GB以上,即便经过Q4量化也需要15GB—20GB的常驻空间,再加上KV缓存随上下文水涨船高。官方说的"运行1200亿参数",指的是量化权重加运行开销能装进显存划分配额内的稳妥档位;官方口径同样强调,能跑多大的模型和内存配置、量化方式都有关系,要跑大模型就得选大内存版本。知乎知乎知乎
实测把上限探得更高:128GB版华硕ProArt GR1X上,IQ4量化的Qwen3.8-Flash-Next(176B参数)完整跑完了Artificial Analysis AgentPerf Local负载——默认负载包含8个任务、共168轮对话,总输入Token超过200万,全程没有中断。还有评测者把开源推理引擎TensorFold编译成Windows ARM64版本,同一模型的4-bit权重包总容量达到105GB,开启256K上下文后把划分的80GB显存吃满、连系统内存也几乎耗尽。这基本就是128GB机器装"单个最大模型"的极限,余量已经很紧。知乎知乎
厂商宣传口径走得最远:机械革命称大师之路X10最大支持125B千亿级模型本地部署,支持252B模型顺畅运行,据称响应可以达到秒级。知乎
机械革命还宣称搭配AI SSD可以在同为4-bit精度下,把本地可跑模型从35B提升到397B。这两个数字均未经第三方实测检验,且后者的本质是把部分权重卸载到硬盘上按需读取,与全量驻留内存不是一回事。至于64GB版本,预算直接少一半,和千亿级模型不是好搭档:冲着跑千亿参数模型去的,只能锁定128GB版。知乎
够不够快这道关:带宽定上限,稠密和MoE是两个世界
"跑得动"的另一半是速度能不能用。卡住RTX Spark的不是算力而是内存带宽:每生成一个词元都要把参与计算的权重从内存里搬一遍,300GB/s的天花板决定了稠密模型越大越慢。《微型计算机》的梯度很直白:Mistral-7B跑到每秒54.45个词元,13B的Llama-2降到每秒28.48个。由70B蒸馏而来的DeepSeek-R1模型即便量化到Q3,也只取得每秒7.34个词元的推理速度——离线批处理、长文档精读尚可,即时对话不合适。知乎
反例是176B的MoE模型:在同一轮智能体负载里,它的Prefill速度达到每秒44.64个词元、端到端解码每秒27.9个词元、平均首字延迟约2.49秒,解码速度甚至与27B稠密模型打平。差别在架构:MoE(混合专家)每个词元只激活部分参数,速度看的是激活量而不是总量。知乎
Q4量化的Qwen3.6-35B-A3B在这台机器上达到每秒84.28个词元,是整组实测里最快的一档。知乎
所以"跑得动多大"实际要拆成两问:稠密模型过了13B就渐入批处理区,MoE模型的可用规模可以推到170B级。
智能层面,英伟达称这颗176B模型在Artificial Analysis智能指数上得分40,已经与云端付费的Claude Sonnet 5.5 Medium(41分)几乎肩并肩。智能、容量、速度在这个量级上第一次同时成立。知乎
推理引擎还留有余量:换成针对统一内存原生优化的引擎,同一模型的平均解码吞吐提升了116%,Prefill性能提升135%,首字响应延迟降低58%。同一组对比里,整轮能耗和单Token能耗还下降了44%。目前Windows下的通用llama.cpp路线,还没把这套架构完全喂饱。知乎
几个人能用这道关:能跑不等于多人可用,也未必省钱
容易被忽略的是第三层:128GB是整台设备的系统内存,不是专门分给模型权重的显存,系统、驱动、推理框架、模型权重、KV Cache和其他任务共同占用这部分预算。知乎
同一团队用同芯片的DGX Spark做过长期使用:一个人使用8K上下文也许体验不错,多人同时使用相近长度的上下文时内存压力会明显增加。"模型能运行"和"团队全天用"是两回事,这台机器的合理位置是个人设备或小团队错峰共享的推理盒子,不是高并发推理服务器。知乎
成本同样是条件题。按英伟达给出的账:本地跑176B模型,每月本地产出6100万Token的电费成本约20美元,同样的Token量走云端API大约要1200美元。这笔账只对智能体全天驻留、Token重度消耗的用户成立;偶尔提问的用户,还是拿设备价除以自己的月度云账单算回本周期更稳妥。知乎
价格、短板与谁该买
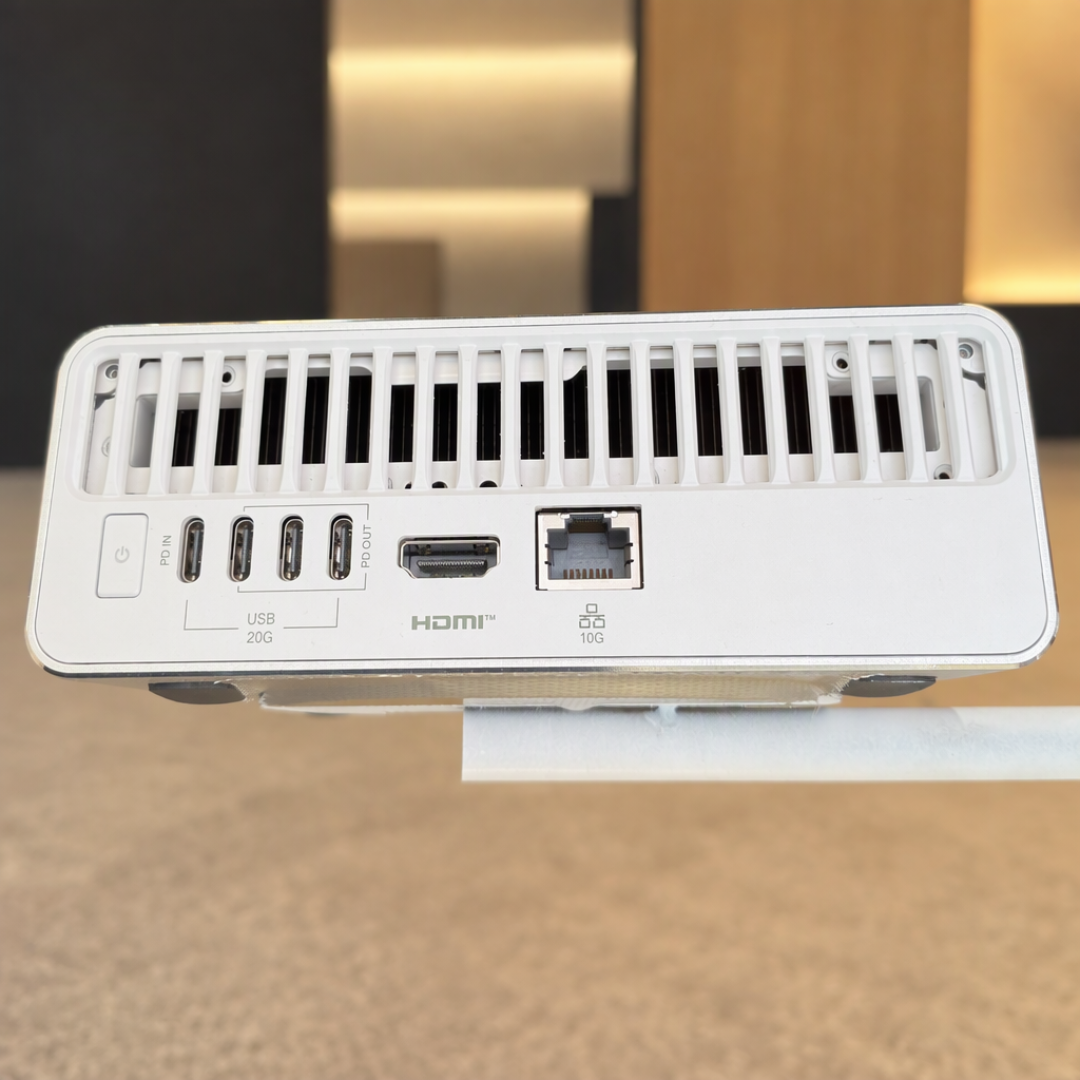
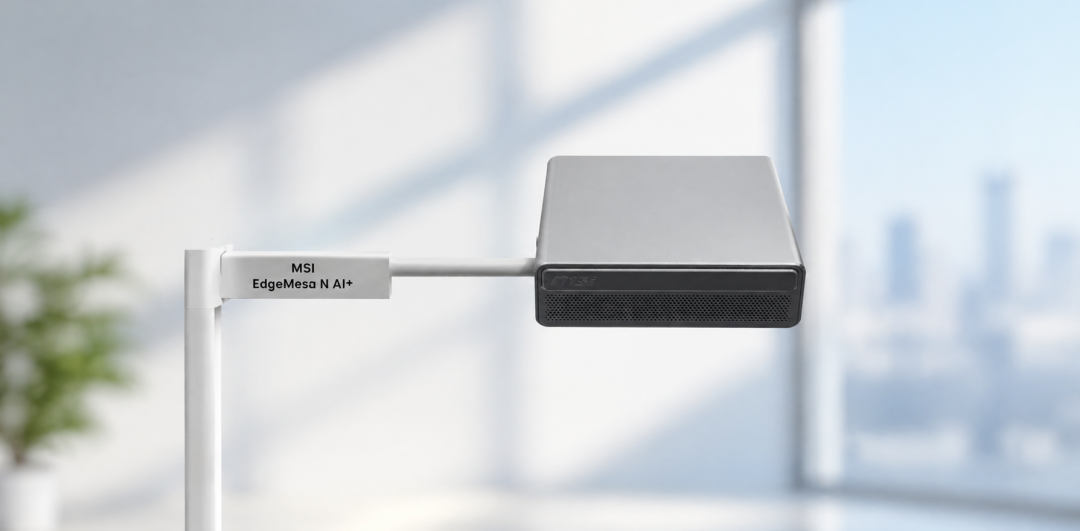
上市当天的价格锚点来自发布会:机械革命X10的64GB+1TB专业版售价32999元、128GB+2TB旗舰版49999元。据销售端报价,微星EdgeMesa N AI+日常价格33999元、华硕GR1X的128GB+4TB版本日常54999元。社区的主流态度是该有的好处都有、该有的不足也少不了,只是价格带着试水味。有观点认为这代产品1.5万到2万元才算合理区间。硬件短板同样具体:Windows on Arm的兼容性仍有个别边角需要补齐,常用行业软件最好上机前先确认。桌面版整机一个USB-A口都没有,也去掉了DGX Spark上用于两台机器互联的ConnectX-7高速网络接口。知乎知乎知乎知乎知乎
回到标题的问题,实测拼出来的答案是三个区间:128GB版本的装载上限约170B级的量化MoE,且这个规模下智能体任务尚能日常使用;7B—35B的MoE以每秒50—85个词元处在最舒服的日常甜区;稠密模型过了30B就该按批处理机对待。官方的"1200亿",只是三个区间里最安全的说法。值不值得买别看参数宣传,看你有没有一堆"必须全天留在本地跑"的活——有,它就是目前最小的带完整CUDA生态的解法;没有,不妨等价格回落、软件补齐再决定。

当前文章无评论,是时候发表评论了