假期里刷B站和小红书的人,大概率被这张2017年的老卡刷屏了:这边是4.5万播放的《Qwen3.8 27B NVFP4 V100逆天输出280token/s》,那边是《双V100 Nvlink模型服务器起飞了》《双CPU并行加速 四卡V100烤机测试》接连登场。连卖家都在10月1日发帖:“V100 32G 8卡SXM2服务器整机,节日也可发货”。哔哩哔哩
小红书上,《垃圾佬福音,最新神器,v100满血复活了》的帖子拿到49个赞、71个收藏,作者直言"想本地部署模型买不起显卡?v100满血复活了,堪比r9700"。Ninfer实测视频的评论区里,点赞靠前的一条是"突然想把r9700还没到货的退了"。小红书哔哩哔哩
比视频更扎眼的是价格。6月时,整合包卖家的视频简介里还写着"对于价格才1000块的V100来说,非常不错了"。到10月5日,小红书《两张二手老卡,跑平4090》一文给出的32G二手价已经是"卡是 Tesla V100 32G,数据中心退役卡,二手大概 3000 一张",其评论区有人喊"网上都炒到了3800"、有人直接报"现在4500了",还有人感叹"两个月前才千百来块,哭晕"。哔哩哔哩小红书
先把结论放在前面:这轮V100的速度是真的,个别场景确实摸到了魔改4090 48G的屁股;但它是一张被开源社区"续命"的倒计时卡——入教之前,先把四组实测、五个坑和三笔账对完。

一张2017年的卡,凭什么国庆封神
关键是软件,不是硬件。V100是Volta架构(sm_70),主流推理框架早已把它甩下:新版编译不带它,PyTorch只剩cu126版本还认它。真正改写局面的是几个专攻老架构的开源fork:
3月,1Cat-vLLM(一个面向V100/sm_70的vLLM工程fork)配四路NVLink跑通Qwen3.5-122B,视频标题直接喊"用V100的预算跑出A100的性能";
8月31日,1Cat-vLLM把Qwen3.8-27B的NVFP4量化跑到280 token/s——要知道V100硬件层面根本不支持NVFP4,这是软件层"反向量化"硬做出来的。这条4.5万+播放、600多评论的视频,就是本轮行情的点火点。哔哩哔哩
9月23日,GLM5.3F也被解锁,145 toks;
10月4日凌晨,ninfer-V100X2登场:双16G V100跑Qwen3.8-27B的quasar qat NVFP4,峰值236 t/s解码、2000 t/s预填充,两张16G的显存刚好塞下262K上下文。最有戏剧性的是作者自己在评论区求star,说"这对一名初三牲的简历很重要"。哔哩哔哩
10月5日,又有人把单卡16G跑27B做成了一站式整合包,宣称"1000+t/s prefill、60+ decode、256K上下文"。再加上同一周小红书上冒出来的双V100水冷装机秀,这张老卡在一个国庆假期里完成了从"洋垃圾"到"真神"的跳跃。评论区已经有人喊"一起入坑v100神教吧",理由是"1000内最强最强的计算卡 除了比较折腾 但T10,mi50什么的没有一个打得过他"。知乎哔哩哔哩
四组实测,四种命
先泼盆冷水:同一张卡,换个引擎和量化,性能能差近8倍。把本周和近期的代表性实测摆在一起看——
第一组,1Cat-vLLM跑27B NVFP4:UP主口径峰值280 t/s;有网友租卡自测,“峰值确实能200tps”,但仓库推荐的模型量化"压根没法用——死循环、只输出理由不输出内容",换成unsloth的NVFP4才正常,代价是KV cache开不了FP8,速度跌回50 t/s左右。哔哩哔哩
第二组,Ninfer-V100X2双16G:标题里的236 t/s是峰值,作者自己在评论区交底——实际写代码峰值200出头、平均190;短上下文平均140;180K长上下文平均100。哔哩哔哩
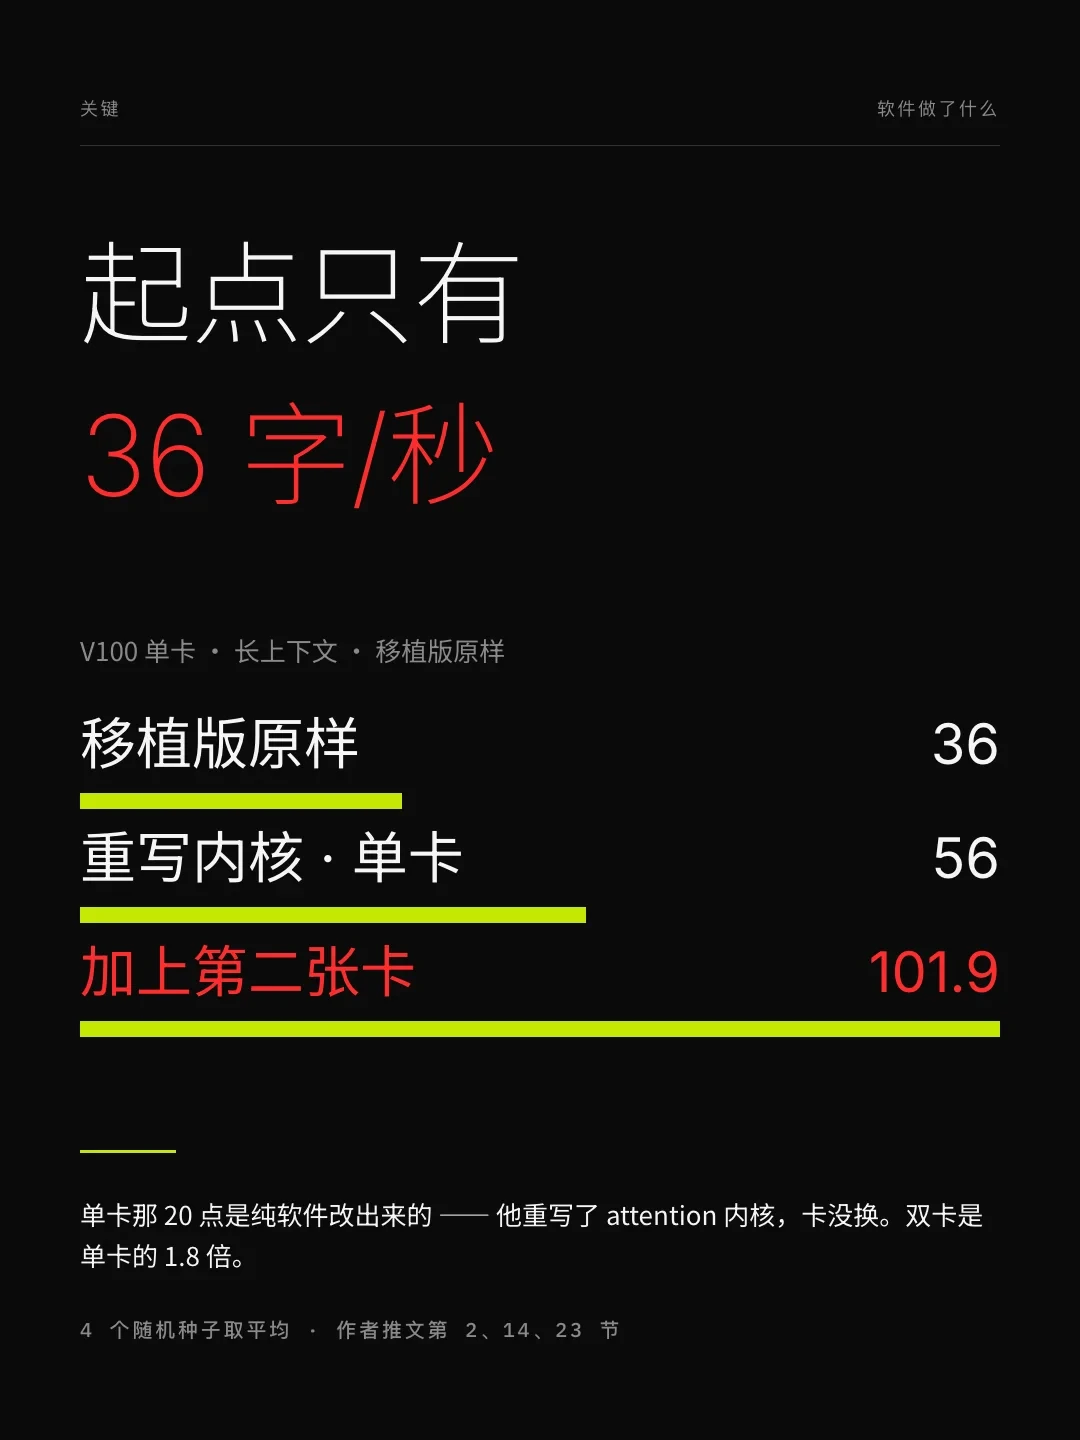
第三组,小红书《两张二手老卡,跑平4090》,数据最全的一篇:重写attention内核后,单卡从36 t/s提到56,加上第二张卡到101.9(双卡是单卡的1.8倍);256K上下文代码生成,双V100 94.7 t/s,对面一张约3万元的魔改4090 48G跑80.9 t/s;中文生成71.0对67.4,基本打平;300道题答对237比236,就差一道。但首字等待被反杀:V100要等393秒,4090是210秒——这一步卡在算力,软件补不了。作者还在评论区主动补充:两边用的是不同权重方案(V100是NVFP4、4090是groupwise-int),“速度可比,别当成严格同条件A/B”。小红书
第四组,反面教材:有人拿两张V100共64G显存、用llama.cpp跑27B的Q8量化,只有30 token/s左右——llama.cpp不做张量并行,相当于只有一张卡在干活,Q8的显存占用还比FP4翻倍。哔哩哔哩
三条口径记牢:峰值不等于日常(280是跑分,写代码平均190);解码快不等于响应快(长上下文首字要等6分半);引擎和量化决定这张卡是神是废铁(30到236,差出8倍)。
五个坑,坑坑都有前人躺着
坑一,生态倒计时。CUDA 13已经不再为V100编译,PyTorch只剩cu126一个版本可用。小红书高赞评论在催大家赶紧备份sm70-75驱动,“很快会被库删除,现在能跑moe_122b”。Volta硬件不支持BF16和FP8,NVFP4全靠fork续命,双V100水冷帖的评论区就有人叹气,说"这个卡感觉已经被放弃了,要跑量化很多精度都不支持"。哔哩哔哩小红书
坑二,平台门槛比想象高。V100没有视频输出,要么CPU带核显、要么加一张亮机卡,否则连BIOS都进不去;主板必须支持Above 4G,E3之类的老平台直接点不亮;迷你主机和笔记本几乎全军覆没;就算魔改4090散热器,散热器还会挡住相邻PCIe槽——有人为此把CPU从5700X换成带核显的5700G,自称"血的教训"。哔哩哔哩
坑三,散热和啸叫。V100是服务器机箱风道里的被动散热卡,进家用机箱双卡满载,卡温爬到81-84℃自动降频。刚哥的双V100服务器视频里满载70多度,评论区有人拆台"其实已经是压不住了",自己水冷改版压到满载55度以下。啸叫也躲不掉——电感跑大电流必然共振,评论区确认"有的"。小红书哔哩哔哩
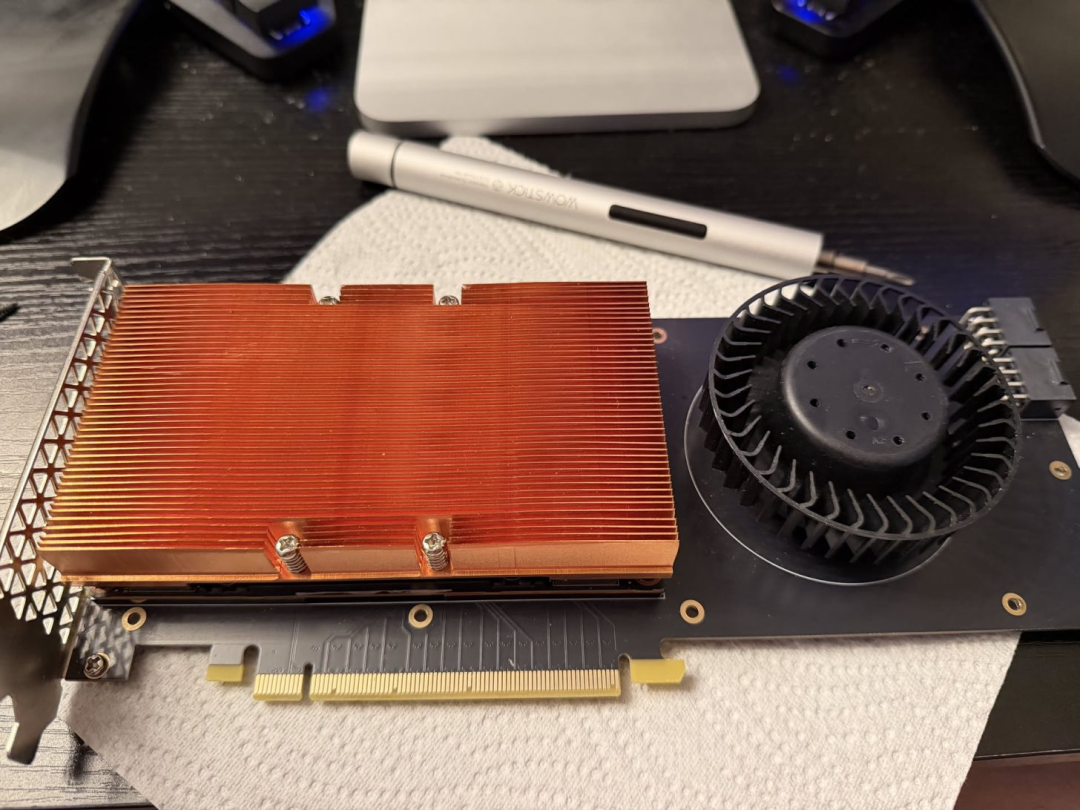
坑四,同样叫V100 32G,其实是两种卡。《两张二手老卡》作者发现:惠普定制版核心砍了一成,但显存频率1107MHz、实测带宽1058GB/s;标准SXM2版核心全开还带NVLink,显存却只有877MHz、实测878GB/s——带宽差20.5%,单卡生成速度差20.3%,多花钱买的NVLink版反而比老定制版慢。下单前用 nvidia-smi -q -d CLOCK 查Max Clocks里的显存频率。另外,560块的"好价"别眼馋,那是针脚有问题或报ECC错误的瑕疵卡。小红书哔哩哔哩
坑五,软件栈绑死Linux。Ninfer那套在Windows上跑不起来,WSL会打断P2P。单卡整合包用的KVMem有丢上下文的问题,agent模式还会"反复prefill,气死人"。想拿多张V100做ComfyUI视频生成的更要当心——连卖整合包的UP主都看不下去,直言"总有小白买了多张16G的V100要在COMFYUI玩多卡,还要做什么AI短剧"。哔哩哔哩哔哩哔哩
顺带拆穿NVLink
SXM2双卡整机最爱讲NVLink故事,但实测泼了冷水:视频生成只快1%;光开直连不改代码,提升是0,那一成速度是作者自己写代码把"信箱"搬进对方显存才拿到的;唯一明显用处是读长prompt,快12%到35%。而评论区的风向是"nvlink底板好像快超过板子的价格"。除非你专攻长上下文,别为NVLink三个字付溢价。小红书

三笔账算完再掏钱
硬件账:双32G按当前报价6000到9000元,加平台、散热、亮机卡,整套奔着小一万。四卡方案的评论区口径也是"整套机器小1w"。参照系有两个:魔改4090 48G约3万一张,没有官方保修。另一个是腾讯云4张32G V100的服务器,月租2万。但别忘了:按6月千元价,这是"用零头买4090五分之一速度"的神话;按4500报价,性价比已经被溢价啃掉一大半。哔哩哔哩小红书哔哩哔哩
电费账:评论区口径,机器一个月全程跑AI,电费约600元。对比API——27B级别的量"爽用一天轻松上百",重度用户一个月两三千,重度玩家上硬件方案确实省;但轻度用户一年电费就快追上二手卡差价了。哔哩哔哩
机会账:现在的价格是两个月翻三倍之后的价格,此刻接盘等于接在情绪高点。反过来,6月400、505元入手16G的人,手里已经是"保值的洋垃圾"。而且洋垃圾市场从不缺下一张卡:7月就有人感叹P100"居然涨价了!万恶的资本家,洋垃圾都不放过",同期2080Ti还在创新低。知乎
谁能入教,谁该回头
可以入的:能装Ubuntu、舍得改散热打印风道、主力需求是长上下文写代码或科研助手、家里台式机有核显或空槽且Above 4G能开的人。这套配置能给你262K上下文和200 t/s级的解码,价格只有魔改4090 48G的五分之一。下单前先租卡跑一天(有人租卡测出200 t/s峰值),确认自己咽得下这些折腾再买;买的时候查显存频率、认准无ECC错误的完美品。哔哩哔哩
再想想的:Windows党(这套软件栈Win跑不了)、即插即用党、AI视频和短剧党(多卡ComfyUI是死路)、对首字延迟敏感的人(256K上下文等6分半,不是6秒)。你的钱应该去看3090、新卡或者云端。
别入的:指望"买来就是4090"的人——237比236的答卷有前提,是特定引擎加特定量化,换个仓库推荐的量化可能就是"只输出理由不输出内容"的死循环。以及想碰FP8、BF16、新量化格式的人,Volta的天花板2017年就写死在规格书里了。小红书

最后说句实在的
这轮V100的香火是开源社区点起来的,能烧多久,取决于1Cat-vLLM、Ninfer这些fork还愿意更新多久——英伟达官方的支持已经停在CUDA 12.6。所以我的建议和"早买早享受"正相反:这是一张带倒计时的卡,只值得按"续命价"买,不值得按"升值价"追。3000以内,折腾党可以入;4500的报价,加一点都够得着二手3090了,何苦。哔哩哔哩
至于V100之后还有没有下一个"真神"——看看已经开始涨价的P100,看看刚创新低的2080Ti。洋垃圾的规律从没变过:只要大模型还在往大了长,老卡就总会有第二春,只是每一春的窗口,都在变短。知乎