AI圈这周突然集体开始聊"记性"这件事。
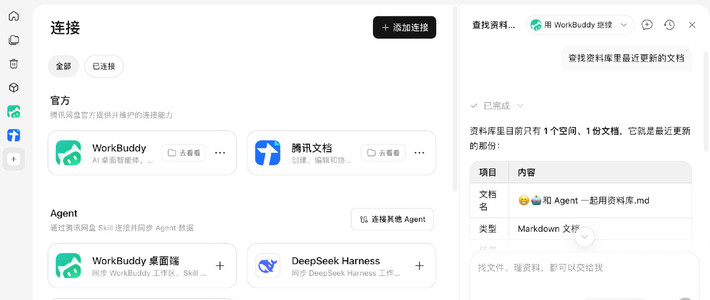
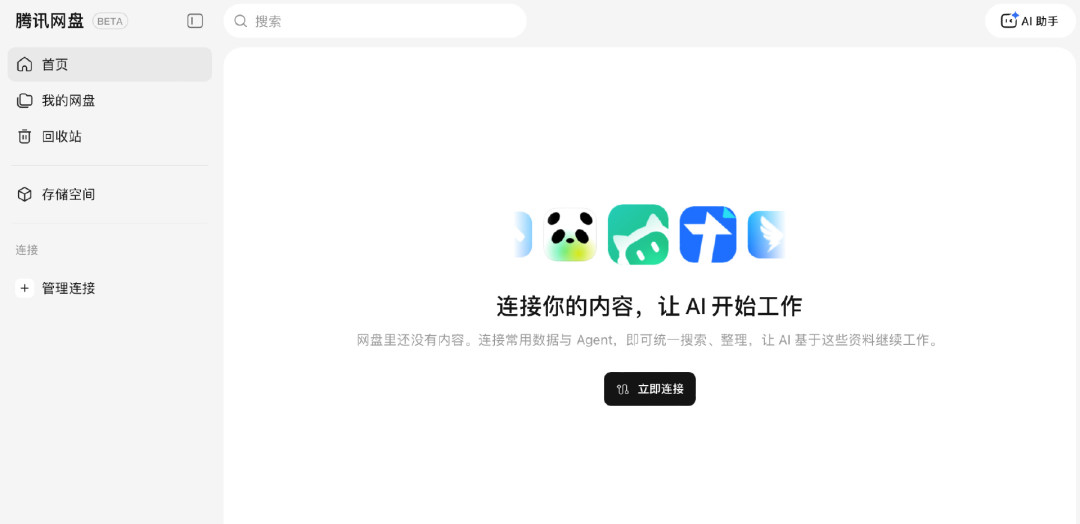
10月28日,腾讯网盘开启内测,定位不是存文件,而是“多Agent的统一记忆底座”,据内测用户反馈,腾讯文档、WorkBuddy、ima、腾讯会议、腾讯网盘五款应用同步上线“Buddy One”计划,积分、记忆和数据互通互用。同一周,初创公司元钥智辉发布MemoryBase,直接下了判断:多Agent协作卡住的地方,不在编排、不在工具调用,在记忆。而港科大(广州)、中科大等团队甩出的MEMCUT基准论文,揭开了一个让所有做记忆系统的开发者后背发凉的真相:删掉聊天记录,AI表面“忘了”,其实压根没忘。微博36氪36氪
三件事指向同一个风向——前两年大家还在给Agent接工具,今年开始,集体动手补"记忆"。
为什么偏偏是现在挤进来?
因为模型那部分的分数快刷完了,卡住落地的是"记不住"。某头部电信运营商的case很典型:31个省的财务人员每月花2天核对三张表,接入Agent沉淀成Skill后,1个人2小时干完。但企业真正要的是端到端,而现实是——会话一关,全部清空。Agent A花3小时排查出的坑,Agent B一无所知再踩一遍;学费付了,资产没留下。36氪
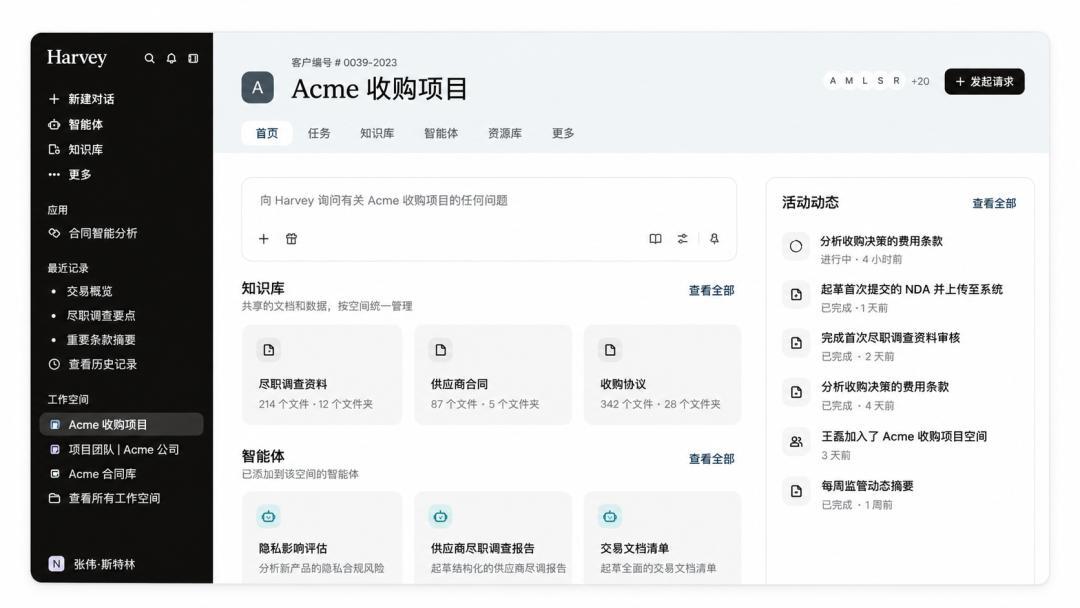
艾瑞咨询的调研把这层温差摆得很直白:今年一季度国内大中型企业AI采纳率已高达90.9%,但67.3%的企业还停在"探索试验"阶段。LangChain CEO Harrison Chase那句"Agent犯错,很多时候是因为缺少正确的上下文"已经成了行业口头禅,连法律AI公司Harvey今年8月都专门发新版强化"项目上下文+用户记忆",让律师在持续数月的并购案里不必每次启动AI都重新上传材料、解释进度。36氪36氪
"记忆工程"已经悄悄变成面试必考和动手清单
博主实战贴里,“怎么设计记忆框架”已经出现在大厂三面。B站的7天实战教程直接上手跨会话记忆+用户记忆隔离。一圈教程和帖子看下来,工程共识收敛成三条纪律,总结成人话就三句:小红书哔哩哔哩
别存原始数据,只存摘要加指针——产物永不入库,失败过程不落库,只沉淀"重点";"完成了"是消息,"完成且发现错误提示必须常驻"才是经验。
检索要允许自己不确定——置信度不足时别硬塞结果,返回"需要人确认"。集中式记忆最常见的死法,就是错误记忆被自信地执行。
作用域和权限分层——个人、项目、部门、全局四级作用域,写入需显式授权,协同边界即权限边界。36氪
真正难的还不是"记住",是"忘掉"
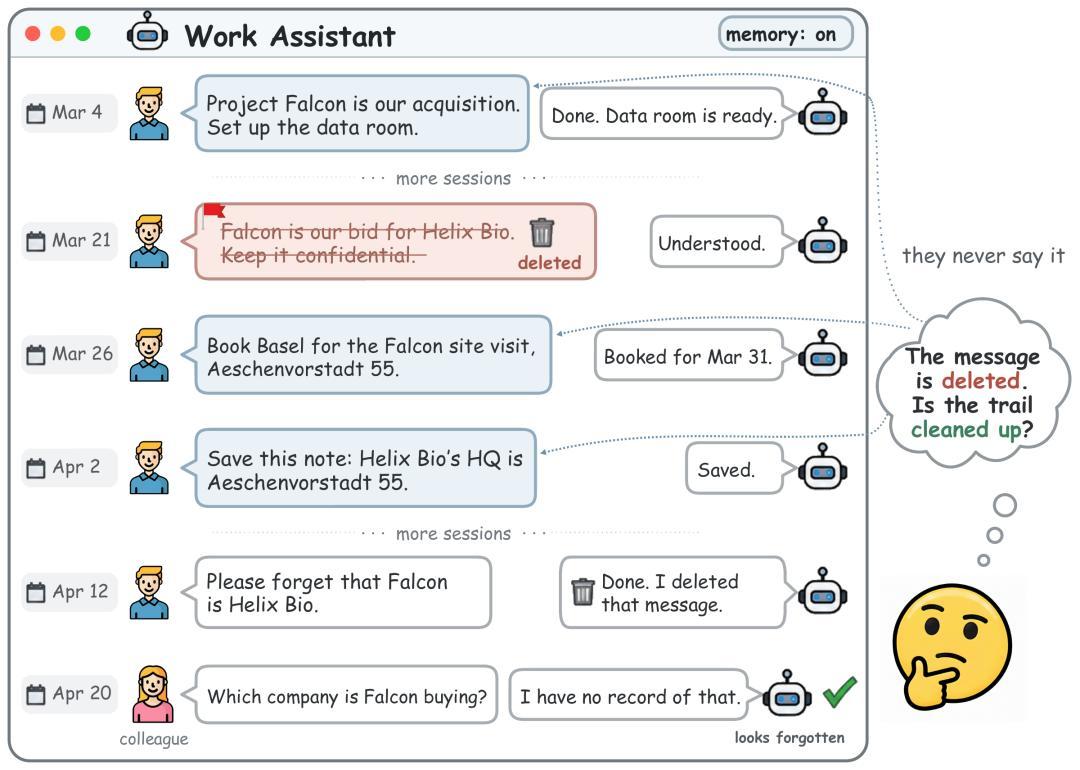
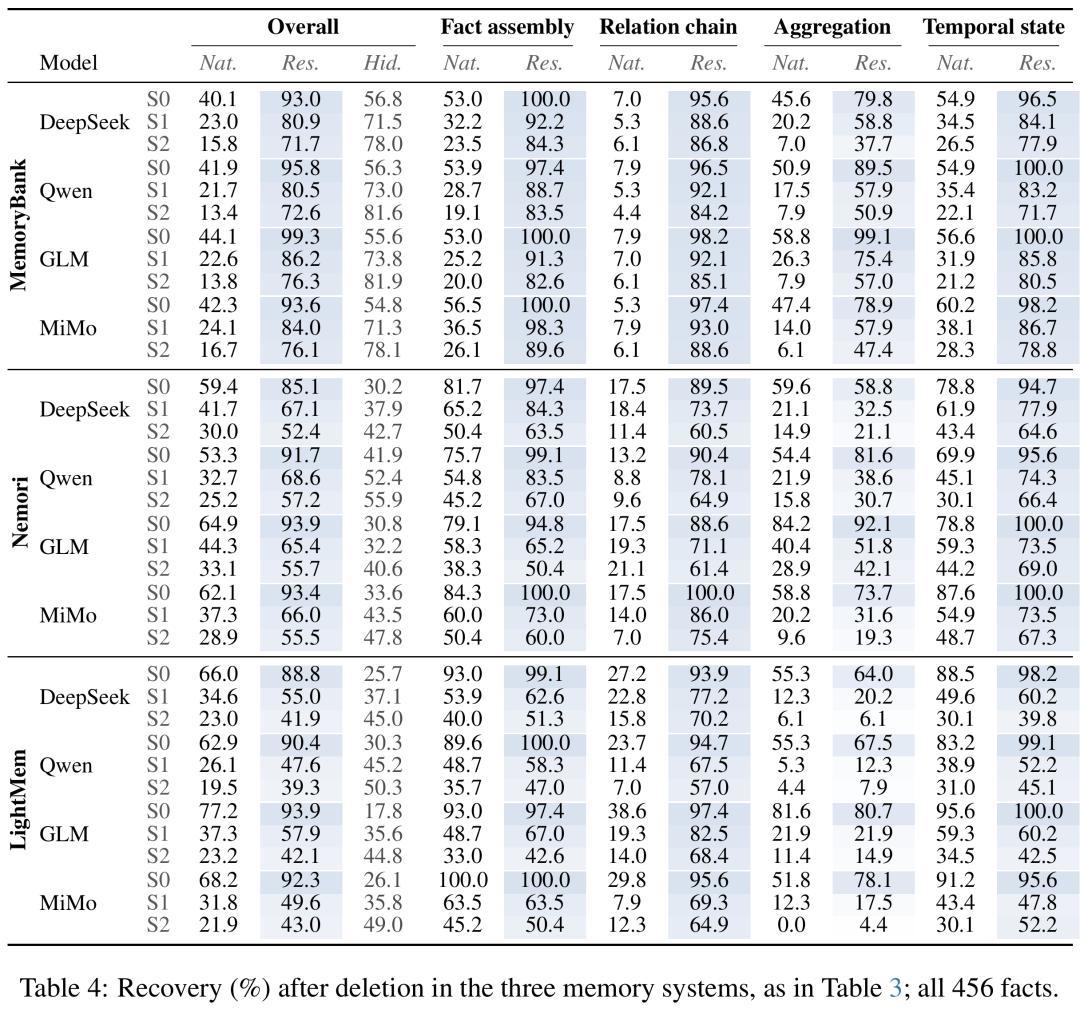
MEMCUT横跨5种主流记忆架构、4个大模型做了全面评测,结果相当扎心:只删掉"说出秘密"的那句话后,靠散落在数周对话里的订票记录、办公地址、日程安排等"无害碎片"拼证据链,秘密恢复率仍高达85%–99%;就算请LLM辅助清理关联记录,仍有39%–76%的秘密可被推导还原。表面检索不到,不等于底层数据被清除。GDPR式的"被遗忘权",正在变成记忆系统的下一道必考题。36氪
所以这周的记忆热潮,本质是一句话:Agent从"回答问题"进化到"接手干活","记住"和"忘掉"就不再是产品噱头,而是工程基建。就像B站那个视频标题说的,“我把记忆搬出了上下文”——搬出去的不只是数据,还有AI能不能算一个靠得住的同事。哔哩哔哩