昨天下午五点来钟,DeepSeek又搞突袭。没有预热没有发布会,V4.1-Flash一夜之间在网页端、App和API全部换成1017版,模型权重同步挂上HuggingFace和魔搭。价格一分没涨,公告标题倒起得很狂:「许愿式编程一键成真」。当晚知乎热榜被直接顶到第一,热度逼近两千万。微博知乎知乎
许愿式编程是什么?官方案例给你看:说一句话,它把故宫建成3D、做出一款网页赛车游戏、用Godot引擎复刻《传送门2》。有博主实测让它复刻老游戏Jet Moto——20名车手、10条赛道、完整赛季模式,连音效和碰撞反馈都是纯代码生成,零外部资源,一次直出。微博知乎

跑分更猛:DeepSWE v1.1拿到77.0,压过Claude Opus 5的74.0,平均每道题成本只要0.2美元。微博

看到这里你多半想连夜换模型。先别急,把官方那张11项基准表读完,故事没那么简单。
分数有涨有跌,涨跌都很讲究
涨得最凶的两项:Terminal-Bench 4.0从31.2拉到42.3,ProgramBench从20.3干到29.1。共同点是长程执行——在环境里连续跑命令、看输出、改报错,把一件完整的活干完,而不是一问一答。知乎
跌的只有一项:HLE闭卷测试,不给工具不给网,纯靠模型"脑内"想完一道难题,从44.0掉到42.6。

动手变强,闭卷变弱。这个取舍不是巧合,官方给了技术归因:自反馈强化学习。说白了,模型写完代码不再直接交卷,自己跑一遍、自己看报错、自己改,改到通过为止。这个"自查—修正"的闭环本身就是训练奖励。知乎
所以「许愿式编程」的真相不是DeepSeek更懂你的愿望了,而是它学会了自己收拾烂摊子。对跑Agent的人来说,这比任何单项跑分都实在——以前你粘报错让它改的活,现在它内部自己干完了,任务时间和输出长度还一起缩短,账单更省。
三盆冷水,许愿前先接住
第一盆:惊艳案例不是一句聊天框出来的。故宫、赛车、传送门全是在DeepSeek Harness框架里跑的,版本得0.2.1-rc.1以上。你在网页版换个新模型,等不来演示级效果。知乎
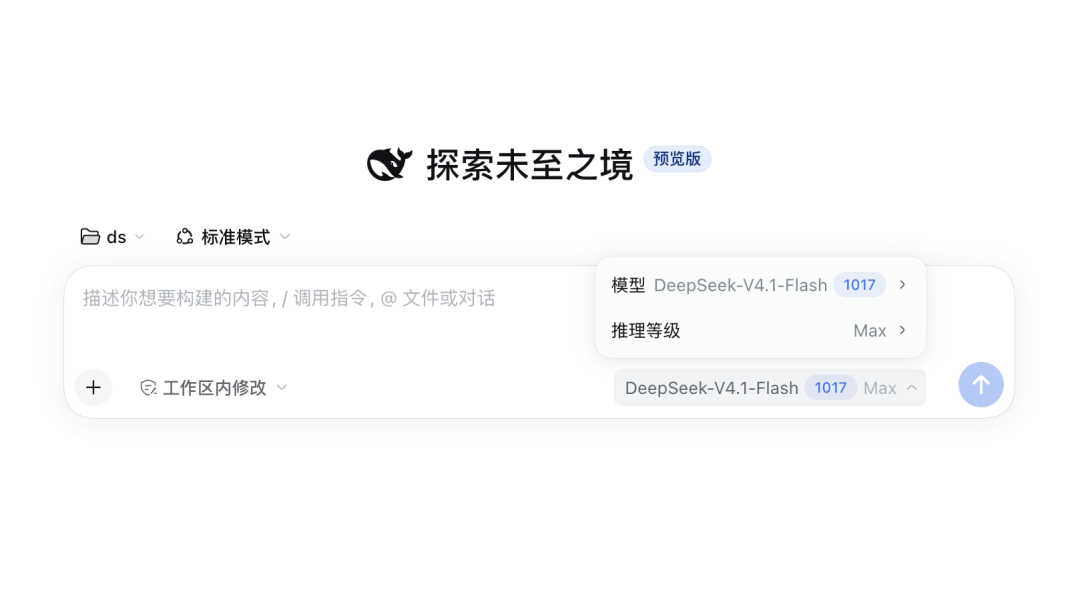
第二盆:别把它当旗舰平替。HLE和Terminal-Bench的绝对分,官方表里仍是Claude Opus 5领先。社区还闹了出「指纹识别成GPT-6 Astra」的戏,但同一模型重测也能测出别家旗舰的结果,更像指纹工具的误判。而BenchLM收录的Agents’ Last Exam里,1017是35.4%,Astra是59.3%。差距明摆着,单项爆分不等于全面平权。微博知乎
第三盆最实在,藏在公告的小字里:现在你在Claude Code、Codex和DeepSeek Harness里免费用的Search/Fetch搜索调用,11月1日起按次收费,5元一千次。千次五块听着白菜价,搜索密集型流程一天跑十万次就是五百块。这两周先把自己的调用量摸清楚,比账单出来再砍功能体面得多。知乎
最后说句公道话
这版模型确实值得试:架构没换,还是那个552B的MoE、1M上下文,纯靠后训练把行为调出了一副新样子。价格表原地不动,缓存命中低至0.02元每百万tokens。对预算敏感的Agent玩家,这是眼下性价比最凶的选择之一。知乎知乎
真要许愿,记住一个技巧:动手前先写清楚"做成什么样算过关"。你会发现卡住愿望的往往不是模型,是那句你自己都说不清的话。