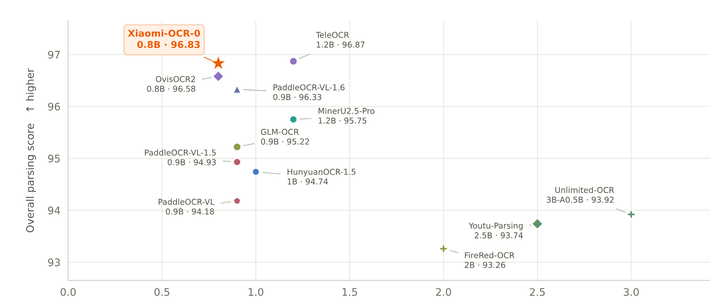
10月30日晚,小米技术官方账号宣布开源文档理解模型Xiaomi-OCR-0:只有0.8B(8亿)参数,却把文档解析、关键信息抽取、OCR视觉问答三项任务装进同一个模型,权重已上线Hugging Face和GitHub。小米官方技术报告同时给出了成绩单:模型在文档解析基准OmniDocBench v1.6上得分96.83,在Real5和Wild两项真实翻拍文档测试上分别拿到95.24和87.94。也就是说,这个8亿参数的模型在1B以下参数段位中OmniDocBench成绩登顶,全场榜首也只比它高0.04分。这轮热点真正值得关注的不是又发了一个小模型,而是“看懂文档”这项能力的门槛,被拉低到了本地设备级别。小红书arXivIT之家
一个8亿参数的模型,能干什么
文档解析把整页内容重建成结构化Markdown,表格转为可编辑的HTML,公式转为LaTeX;关键信息抽取按指定字段输出JSON,比如票据上的商户、税额、日期。OCR视觉问答则允许围绕文档与图表内容进行跨区域检索、数值计算和语义推理,而非仅做文字转写,还可以接入自动化处理流程。本地Agent工具也已备好:仓库自带MCP服务与一键体验口令,把指令复制给AI助手,即可自动完成环境配置、模型下载与本地体验。微博知乎小红书
以小胜大:分数从哪来
小米官方模型卡的参数对比中,与Xiaomi-OCR-0同为0.8B的OvisOCR2得分96.58,全榜最高分属于1.2B的TeleOCR(96.87),它在前三名里参数量最小。ModelScope
更醒目的对比在文档问答:它在五项OCR中心VQA基准上平均83.2分,研究者评价其“性能媲美更大规模模型”——对照模型卡,2B的Qwen3.5-2B同口径均分为80.9。小红书ModelScope
成绩背后是数据工程和训练配方。模型以Qwen3.5-0.8B为起点,在约1.7亿条OCR中心样本上训练,先后经过Q-Mask文本锚定、继续预训练和混合任务强化学习三步。训练数据的标注方式颇有看点:小米让PaddleOCR-VL、GLM-OCR、dots.mocr等一批开源OCR模型组成“专家池”,用共识投票筛选标注,有分歧的候选再渲染回图像与原区域比对纠错,并针对模型反复出错的类型定向合成数据。微博arXiv
论文还给出一个反直觉发现:在解析训练足够充分之后,加入理解类任务的监督反而能进一步提升解析成绩。arXiv
热搜前一个月,它其实已经挂上网了
值得交代的时间线:9月30日,技术报告与权重就以小米SeerRay团队的名义发布,科技博主当天即上线实测与安装记录。沉寂一个月后,小米官方账号10月30日宣布“全面开源”,把它重新推上热榜。选择这个时点官宣,正值开源OCR集体“卷小”:前一天,面壁智能开源了MiniCPM-OCR双模型,1.3B负责识别、2B负责判定,主打“识别成功不等于识别正确”。各家不约而同把参数压到1B上下,说明文档解析对模型容量的需求已被验证可以很低,竞争重心正从“云端谁的分数高”转向“谁能离用户的数据更近”。微博知乎
谁能用上,用在哪
对普通用户,最直接的收益是隐私和成本。小米官方帖子的评论区里,“由于合规问题一些文件没敢直接用在线的AI搞”是呼声最高的一类需求,这正是本地小模型的位置。模型以Apache-2.0协议开源,商用无碍。发布一周内社区已贡献GGUF量化与Ollama实验部署,门槛还在下探,科技博主实测的结论是“不用服务器,自己的电脑就能跑”。小红书Hugging FaceModelScope
边界同样要说清楚。它是OCR中心的专用模型,不是通用视觉助手;在隶书、草书等历史书写的Chronicles-OCR测试中得73分,与Seed 2.0 Pro的72分只是相当,古籍手写仍是短板。实测博主给手机、平板用户的建议也很务实:先用官方在线Demo处理发票和PDF,有显卡、会开终端再谈本地部署。至于它会不会进入手机系统和超级小爱,小米官方尚未披露——眼下这张成绩单兑现的,主要是PC与Agent工作流里的文档自动化。ModelScope小红书