把一段混着机器轰鸣、汽车声和小孩说话的录音交给模型,再问一句:孩子在哪儿?
这是讯飞给 SparkAudio 1.0 出的题。模型没给转写稿,而是给了一段推断:孩子周围有大型机械设备的规律性噪音,可能在火车或地铁上。智东西
它没有因为孩子提到“歌声”就认定有人在唱歌,而是把嗡鸣、机械声和“在车上”几条线索拼在一起。
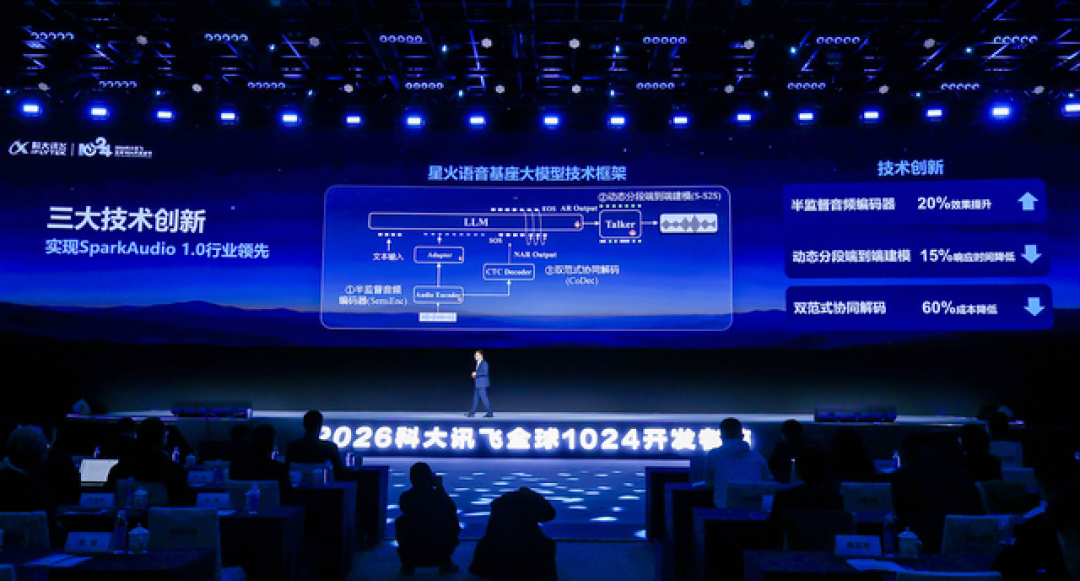
演示发生在 10 月 22 日的 2026 科大讯飞全球 1024 开发者节。SparkAudio 1.0 是当天发布的语音基座大模型,训练依托全国产算力。智东西IT之家科大讯飞
它支持文本、语音双模态输入,能做语音转写、多语言翻译、多方言识别、环境音识别、说话人分离、情感分析和复杂音频问答。
过去谈语音 AI,指标围着“听写准不准”转。SparkAudio 换了做法:先做吃透声学细节的底座,再在上面长专用模型。
Spark-ASR-2.0 管识别,Spark-LiveTranslation 管同传,Spark-Audio-Realtime 管实时交互。
底座负责听懂人声、环境声、时序和说话人关系,专用模型负责把单项任务做到工程可用。
技术上,讯飞提了三项:半监督音频解码器 SemiEnc 补表征能力,动态分段端到端建模 S-S2S 压时延,双范式协同解码 CoDec 降推理成本。智东西
落到产品上,讯飞输入法 16.0 已经接入 Spark-ASR-2.0,支持中英文任意切换和说话人实时识别。
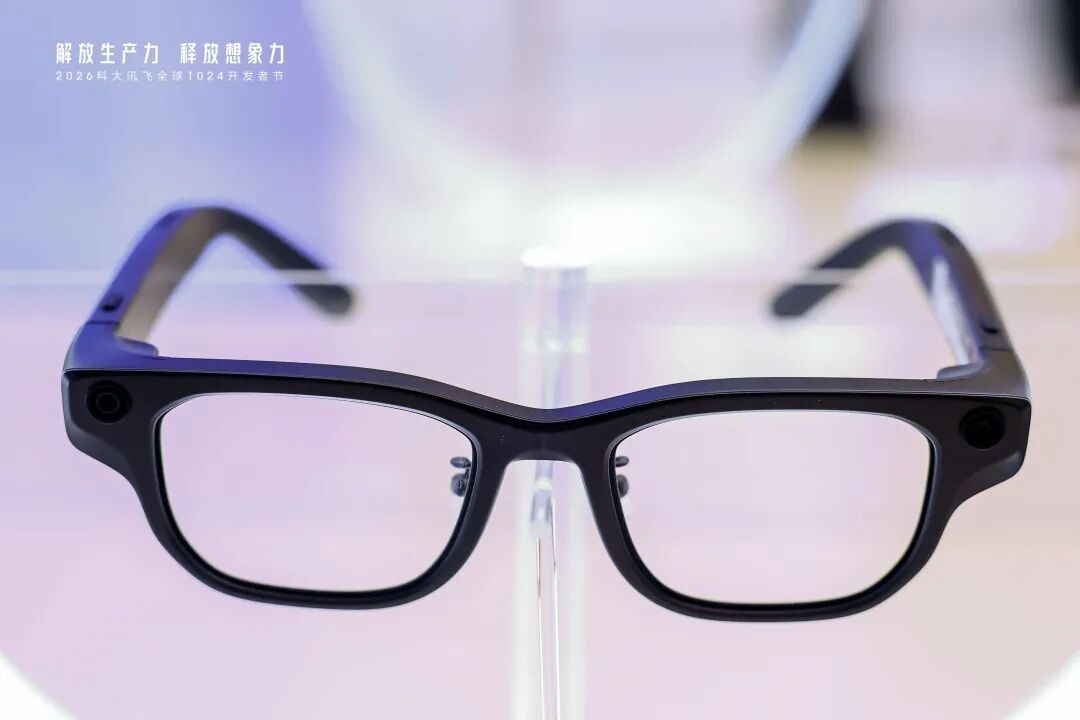
办公本可以手写标注说话人姓名,抢话、多人交叠时也能分开。录音环、翻译机、AI 眼镜和机器人超脑平台,也在发布名单里。智东西科大讯飞
但演示终究是演示。那段刑侦音频里有一声短促的警示音,模型没有分析。两段音频之间,它也没有做综合判断。智东西
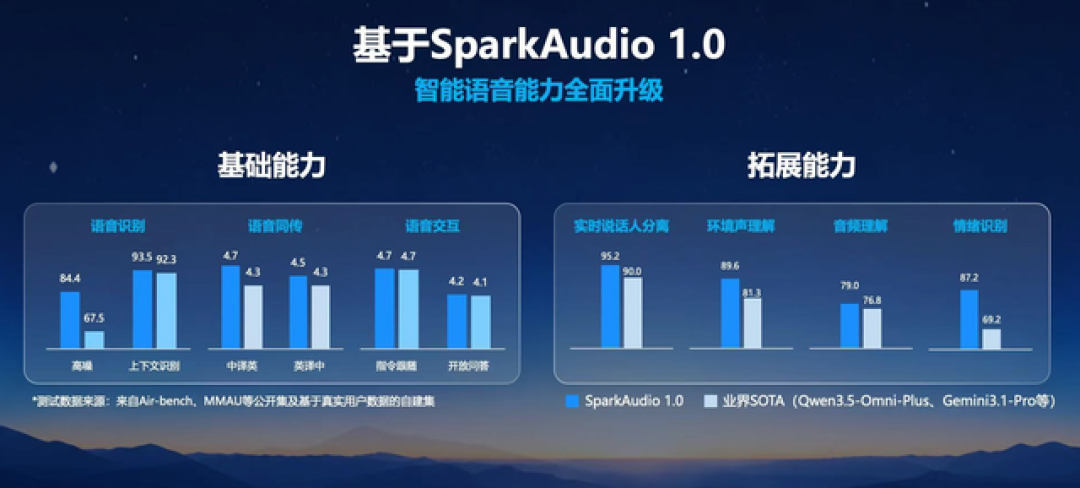
讯飞公布的基准成绩优于多款闭源模型。可这些数字由厂商给出,还需要第三方复现。智东西
语音模型从“听得清”走到“听得懂现场”,中间隔着的正是这类没被剪进演示的细节。
这次值得看的,不是它答对了哪道题,而是它开始答另一类题:不再只问这段声音是什么字,而是问这段声音里发生了什么。