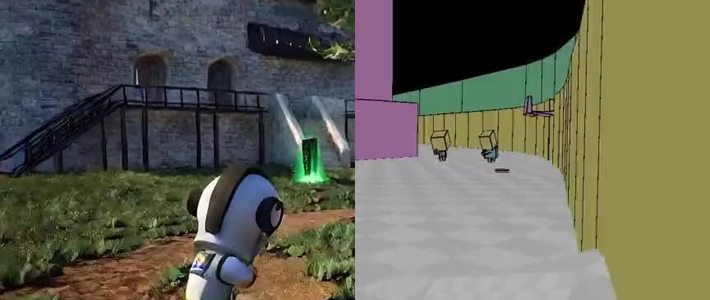
买5090只用来打传统游戏,2026年10月15日之后可能有点亏了。就在今天,昆仑万维旗下Skywork AI发布Matrix-Game 4.0,官方称这是全球首款能在单张消费级显卡上实时运行的"游戏世界模型"。游戏画面不是硬盘里做好的素材,而是显卡一边玩一边实时"画"出来的。更狠的是,模型权重、推理代码和游戏资产已全部开源发布。MIT协议,直接下载。量子位微博GitHub

不是"AI视频当游戏",规则真在跑
以前刷到过不少AI生成世界的演示:按下方向键,模型接着往下画,看着能逛,但血量、道具、输赢全是模型临场发挥,穿帮是迟早的事。
Matrix-Game 4.0换了个思路:让游戏引擎管规则,AI只管画画。引擎实时维护世界状态,先渲染出一份低多边形的"毛坯房"画面;视频模型照着毛坯房精装修,补上材质、光影和环境细节。所以你中弹时,先掉的是盾牌耐久,盾碎了才扣血,血量归零游戏真的结束——结算全由代码说了算,AI画歪一帧也改不了你的血量。Matrix-Game官网
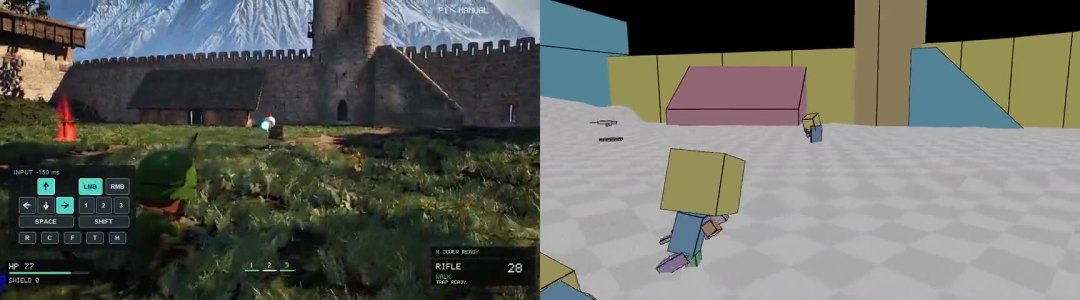
目前开源了三个场景:中世纪城堡、古埃及(第三人称射击)和城市赛车。玩法还能改:用自然语言告诉内置的Coding Agent"把计时赛改成拦截目标车辆",它直接写代码改规则,一局追击战就上线了。量子位
一张5090,怎么扛住的
显卡佬最关心的硬数据来了:480p分辨率、60帧运行、按键响应低于150毫秒、整套系统显存峰值约18.5GiB。对32GB显存的卡来说还有富余。微博量子位
速度是"减"出来的。视频模型基于Wan2.2 5B改造,蒸馏到只需1-2步去噪、一步生成4帧。FP8融合算子、CUDA Graph、KV环形缓存、轻量编解码器全用上,文本编码器、DiT、VAE全部常驻一张卡。单步去噪时稳态生成速度能到83FPS,跑60帧的游戏绰绰有余。Matrix-Game官网量子位

有意思的对照是:几乎同一时间,英伟达研究团队也发布了同路线的StreamRender-H3,其官方展示的部署配置是8张GB200 GPU。据量子位粗略对照,其端到端延迟约545毫秒,约为Matrix-Game 4.0的五倍(后者按键到画面显示约需112毫秒)——不过两者分辨率和统计口径不完全一致,不能直接排座次,但"从算力集群搬上一张桌面显卡"这个工程冲击是实打实的。量子位
没有5090的怎么玩
现在的门槛说实话不低:Linux系统、Python 3.12,显卡要么RTX 5090、要么A100 80GB。但官方在GitHub上明确说了,RTX 5080和5070适配版预计下周发布。中高端卡的等等党可以蹲一波。GitHub
连卡都没有?官方提供了WebRTC浏览器演示:服务器端跑模型,客户端零显卡需求,Safari和Chrome都能玩。想研究游戏本身的,三个场景的源码也能单独编译运行,不加载模型、不开AI渲染,照样能玩能录像。GitHub仓库星标已经超过2.5k,热度还在涨。

泼盆冷水,也说句公道话
先说冷水:480p的画质就是"演示级",只有单机、只有三张地图,官方也承认当前分辨率仍有提升空间。指望它替代传统游戏画面,现在还差得远。微博
但对显卡玩家来说,信号已经很清晰:旗舰卡的价值正在被AI重写。5090的FP8算力成了这类实时AI渲染的入场券,18.5GiB的显存占用也在提醒市场——32GB不是奢侈配置,而是"AI游戏主机"的起步价。游戏从"显卡跑出来的"变成"显卡画出来的",这个开头,你的显卡算是见证了。











