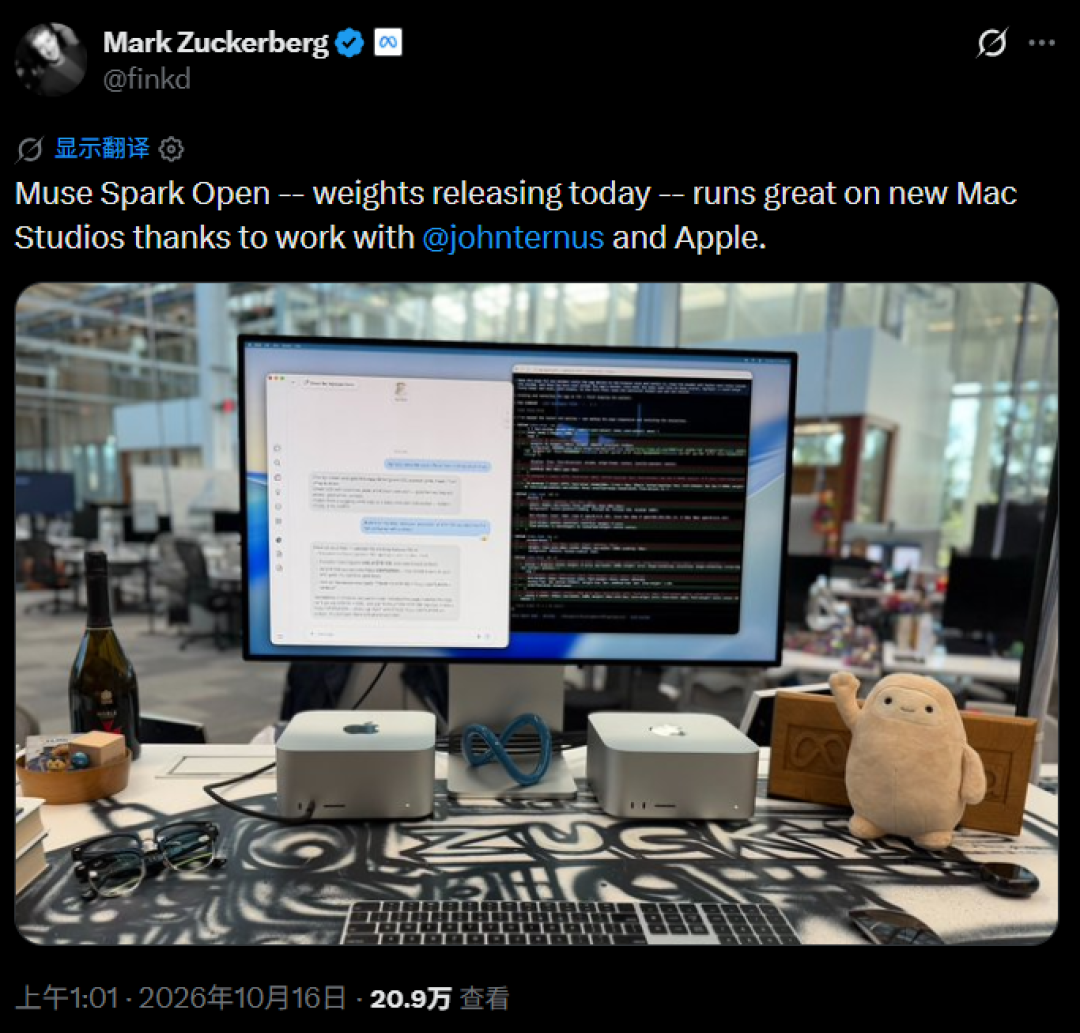
今早科技圈的时间线相当热闹。10月15日(当地时间),Meta在Hugging Face放出开放权重大模型Muse Spark Open;北京时间16日凌晨,扎克伯格晒出桌面照片——两台Mac Studio用雷雳5连在一起,跑的就是这个8160亿参数的模型,苹果机器学习团队同一天发布了实测博客。"美国最强开源大模型"的热搜词条很快就位,自部署党的群聊开始转发。Meta还现场演示了它的拿手活:用Muse Code给开源Mastodon客户端Ice Cubes提交了真实的iOS代码修改——修漏洞、加功能、跑完整构建,还能端到端操控达芬奇剪辑软件逐帧审阅素材。红星新闻界面新闻
但把各家的数字摆到一起算一遍,你会发现标题里每个短语都需要重新定价。
成本账:"两台Mac"是真话,也是半句话
先看权重体量。Muse Spark Open是MoE架构,总参数816B、每个token激活42B、100万token上下文。很多圈外人(包括一部分带节奏的号)以为"只激活42B就只要42B的内存"——恰恰相反:256个专家的静态权重必须全部常驻内存,省掉的只是每步计算量。知乎上有博主算得很直白:内存按816B准备,速度按42B算。NVFP4量化后纯权重约493GB,一台512GB的Mac Studio放不下——因为计算过程还要占用内存。这才有了"两台"的方案:2×512GB=1TB统一内存,Meta官方形容"相当于一台1TB内存的超级计算机"。界面新闻知乎知乎
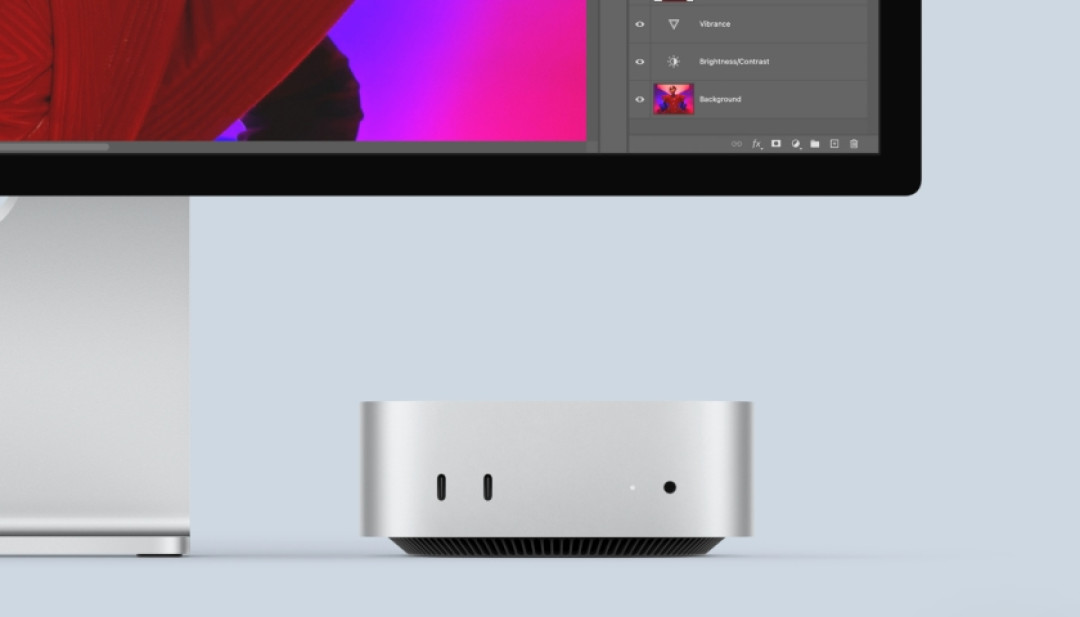
苹果挑中Mac Studio打这套牌,吃的就是统一内存架构的红利:M5 Ultra内存带宽1.2TB/s,解码速度受带宽限制、首字延迟受算力限制,"内存大、算力一般"正好合MoE的胃口。知乎
再看苹果实测的运行表现。两台直连约每秒25个token;四台做张量并行,在8192-token预填、batch=1条件下解码约36.7 token/s——机器翻倍,速度只涨一半,瓶颈在机器间通信。首字延迟更要命:四台短输入也要4.8秒,输入拉长到6.5万token时TTFT直接飙到40.6秒。所谓100万token上下文是理论上限,Hugging Face技术博客算了KV cache这笔账:满窗口要多两百多GB,日常建议压在128K以内。知乎知乎知乎
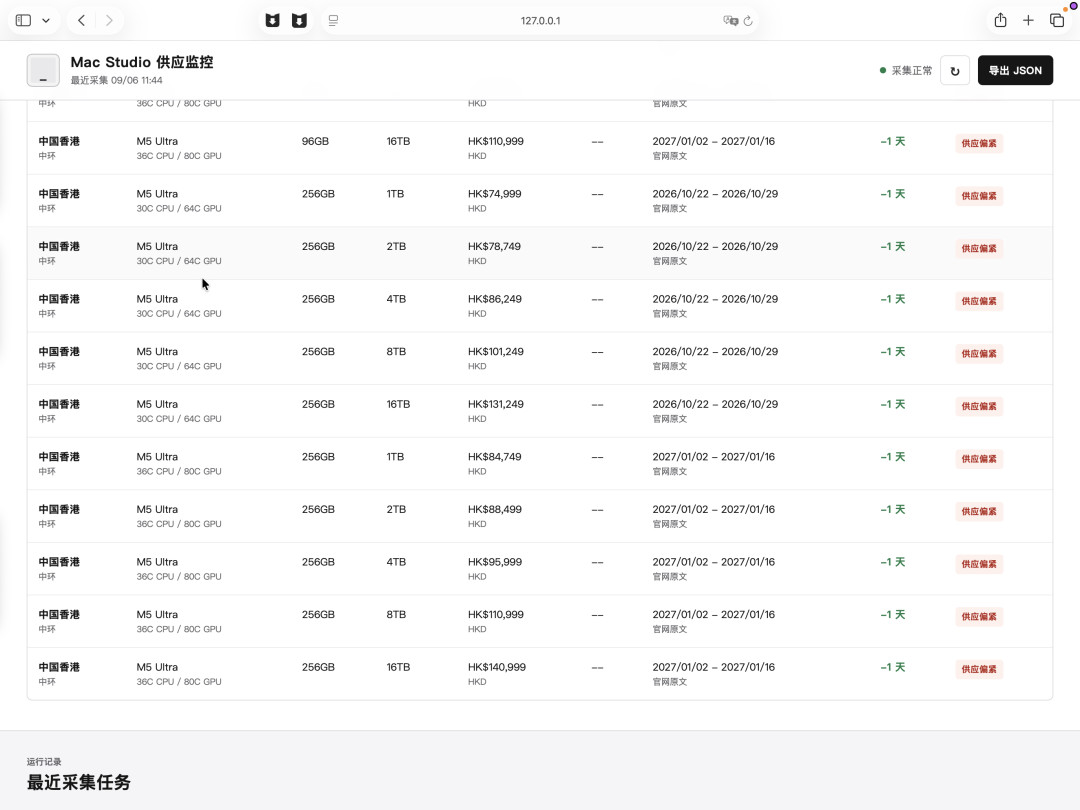
然后是很多人不会说破的部分:这台"能跑1TB模型"的机器,现在根本买不到。512GB内存版M5 Ultra Mac Studio至今未正式开售——界面新闻从苹果发售安排里核实到,高配机型因产能安排延至10月下旬上市。作为价格锚点:8月发布时国行M5 Ultra版起售42999元,9月22日正式发售:M5 Max起售19999元、M5 Ultra起售46999元。苹果今年6月起对多款Mac做过全球涨价;电商叠加国补、教育优惠和以旧换新后,Mac Studio最低到手价约16599元——但那只是96GB的入门档。美区256GB顶配已超过1万美元;微博博主肥威把官网能下单的顶选配了一遍:256GB内存+16TB存储标价142999元,其中那块PCIe 6.0的16TB SSD单加要56250元。界面新闻新浪微博新浪微博
有知乎用户估算:两台512GB大概20万起步,四台256GB集群也奔着20万+。这只是市场猜测,512GB的真实国行定价要等上架才揭晓。想省钱也有路:Unsloth当天就放出2bit压缩版,一台256GB机器就能跑,但压缩越狠智商掉得越多——量化税最后是从"聪明"身上收的。知乎知乎
门槛账:"开源"二字,既不是MIT,也未必兼容你的显卡
第一道门槛是许可。Muse Spark Open用的是Meta自定义的Muse Model License,并非完全开放的开源。条款写得很具体:微调、蒸馏、商用都可以,但基于它开发的产品必须醒目标注“Built with Muse Spark Open”。想拿它对外卖模型服务,还挂钩一条看全公司总流水的营收门槛——条款同时豁免企业内部使用、学术研究和非纯模型托管的自有产品赋能。对比隔壁:DeepSeek V4.1 Flash同样支持百万上下文和图像输入,Terminal-Bench 2.1跑出90.6、代码与权重是纯MIT。开发者换模型的动力,从来是体验跃升或成本红利,不是"开源"标签。知乎知乎
第二道门槛是硬件格式。Apple方案依赖macOS 26.2以上、MLX 0.30.1以上加雷雳5直连;NVFP4是Blackwell原生支持的格式,H100、H200没有硬件加速。NVIDIA路线下的官方建议是至少700GB显存,也就是单台4卡Blackwell、比如4×B300起步,这是含KV cache和框架开销的估算。也就是说,Mac路线本来就是给不想碰数据中心卡的人准备的。493GB、700GB、1TB三个数字对不上不是打架,是三本账:纯权重、全量推理、买机器时该按的水位。知乎新浪微博
还有一层版本小字容易被跳过:这次开放的是基于8月Muse Spark 1.2、额外补了一轮安全后训练的权重,与1.3共用基座。当前Meta最强的Muse Wonder依旧只走自家API。小扎4月立下的开源承诺,两个多月后兑现的是一档而非顶配。名字里那个Open,读的时候最好带个星号。知乎知乎
阵营账:"美国最强"是真的,出了美国就两说
Meta自测11项赢6输5,赢的六项集中在工作流程、工具调用、知识推理、知识可靠性和两项视觉测试,多模态上能接招的国产选手基本只有Kimi K3。输在编程——Terminal-Bench 2.1只有76.4,对比Kimi K3的85.0、GLM-5.3的83.9,DeepSWE在6个有成绩的模型里排第4。"专为编程与智能体任务设计"的官方话术,和自己表格里的编程分打架。红星新闻知乎
第三方机构Artificial Analysis给出的综合智能指数是39分,在117个开源大模型里排第8:小米MiMo-V2.6-Pro以46分居首,GLM-5.3 45分、Kimi K3 44分,Muse Spark Open和DeepSeek V4.1 Flash同分。网友总结得刻薄但准确:“把定语’美国’摘掉,榜单就是排名”;评论区那句"Meta的’美国最强’跟百度的’国产最强’差不多意思",大概是对这场发布最好的注脚。技术博主karminski-牙医的判断更细:这是个Agent能力特化模型,42B的大激活量对多步任务稳定性有帮助、不容易上下文漂移,代价是吃硬件、降速度,“任何一个国产旗舰应该都能超过它的编程能力”。优缺点本来就是同一枚架构硬币的两面。知乎新浪微博新浪微博
谁该上车,谁该先等
只想尝鲜的:OpenRouter、Together AI等平台当天已上线API,OpenRouter定价输入$1.25/输出$4.25每百万token——和闭源的Muse Spark 1.3完全同价,毫无价格优势。按二流开源模型的价格,买的是"工具调用+全模态输入"的样本,适合拿它做Agent编排层(选工具、排步骤),写代码这种主产出别指望它。知乎
需要数据不出内网的企业:这才是官方场景描述的真正买家——vLLM/MLX起服务,前置OpenCode、Cline,截图、录屏、语音一起进上下文的桌面自动化。注意三件执行层面的事:reasoning_effort默认xhigh(烧延迟的元凶),别把原始思维链直接展示给用户,不可逆操作加人工确认——这些都是Meta模型卡自己写进部署建议的。知乎
被"两台Mac"种草想升级硬件的:建议至少等两个信号——10月下旬512GB版上市后的真实售价,和Meta承诺"即将发布"的完整评测报告及第三方复测。如果只是日常短上下文使用,同预算的国产27B级量化模型在三十二显存的算力卡上已经能跑出200+token/s。本地token自由在前,硬件自由在后。知乎
顺手排除一项:普通用户不必为它上四台M5 Ultra——那台机器的主业是3D渲染、影视调色和AI研究,跑大模型只是副业,不该成为你的购买理由。
接下来盯什么
512GB版国行定价与到货日期;Meta完整评测报告是否补上第三方复测;GLM、Kimi、MiMo这批"榜上压它一头"的国产开源如何跟进工具调用赛道;社区量化版本(Unsloth之后还有没有更聪明的压缩);以及终极悬念——扎克伯格会不会连Muse Wonder也放出来。
一句话收个尾:这次发布真正值得记的,不是"最强开源",而是"816B塞进桌面"这条路线被苹果和Meta联手验证了——但它验证的是可行性,不是性价比。钱包决策,等10月下旬价格公布那天再启动也不迟。