














20
18
AI录音卡转写引擎换装实录:8.9秒录音,0.3秒出稿
2026-11-14 17:35:31
0点赞
0收藏
0评论
买
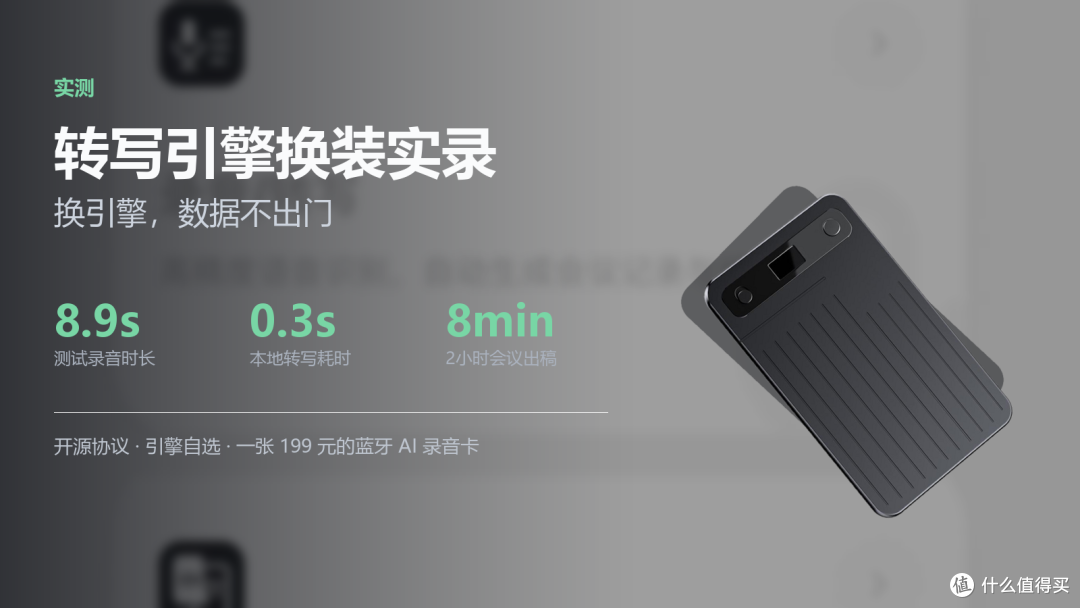
AI录音卡之前,我最好奇的问题只有一个:转写引擎,到底能不能自己换?
市面上的录音卡不少,但敢把协议和 SDK 开源的,难寻。厂商的演示视频里都是"一键出纪要",但一键背后跑的是谁的转写、传到了谁的云上、每月会员费几何——没人演示这个。所以我干脆自己做了一遍实验:把录音卡同步出来的录音文件,换一个自己选的开源转写引擎,在一台普通办公笔记本上,全程离线跑通。
结果是:一段 8.9 秒的测试录音,本地转写耗时 0.3 秒,速度是音频长度的 32 倍,全程断网、没登录任何账号、没花一分钱。
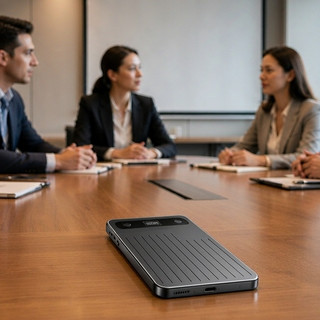
这次实验的主角,是一张 199 元的蓝牙 AI 录音卡,信用卡大小、往会议桌上一放就开录。
硬件参数:
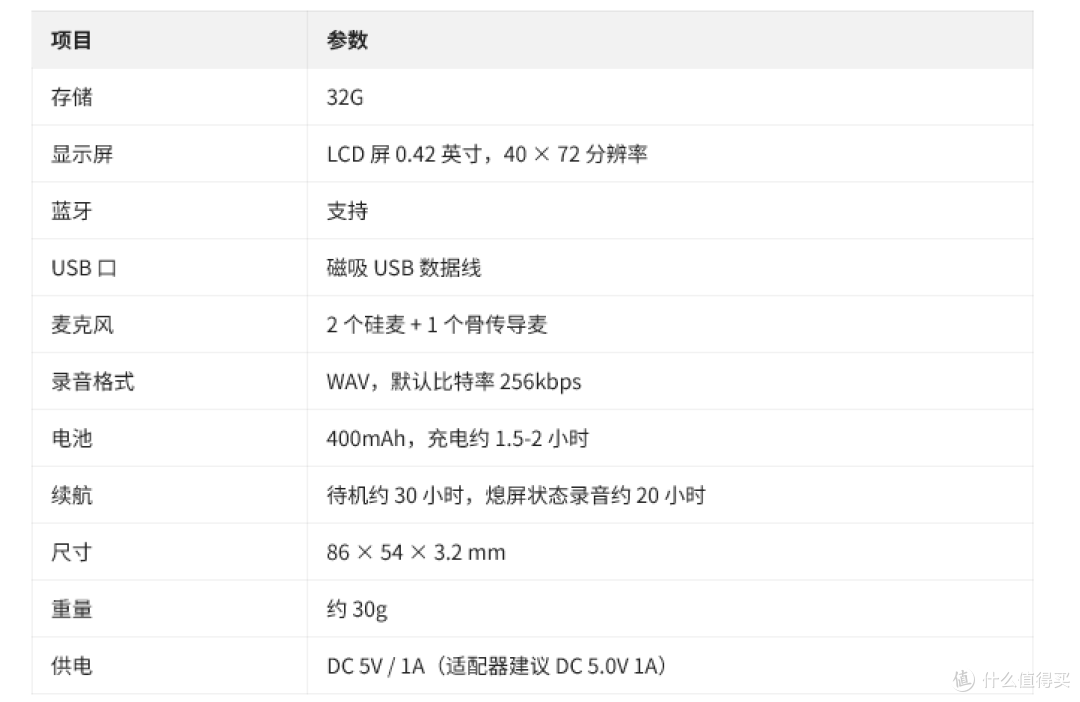
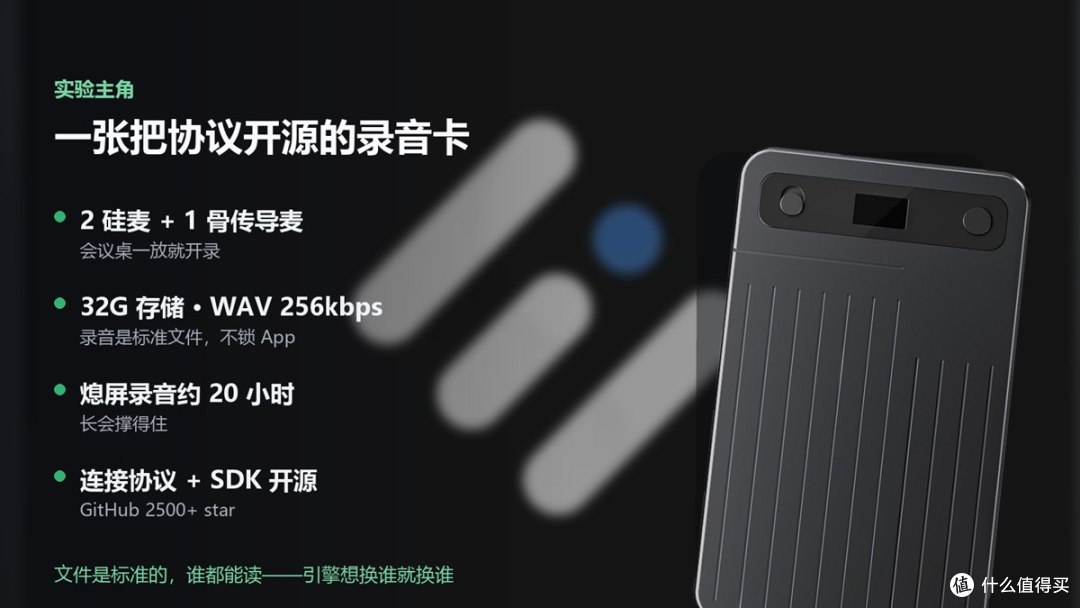
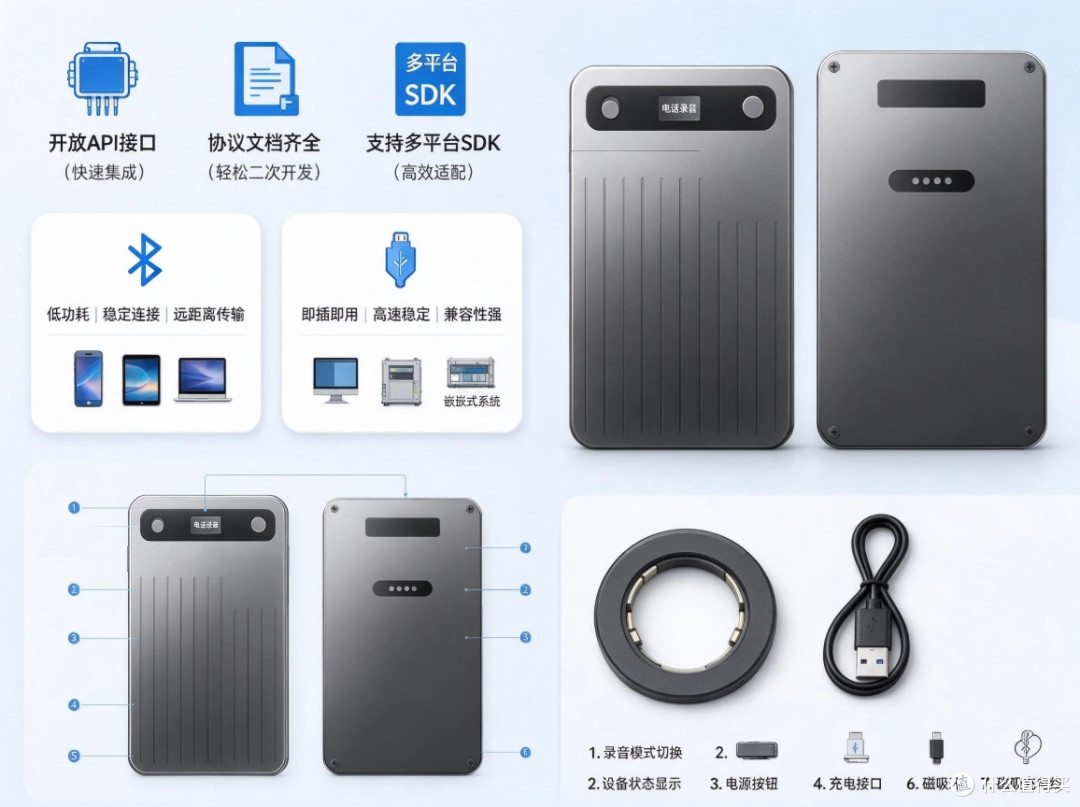
数只是入场券——真正让我选它的,是它把连接协议和 SDK 开源在了 GitHub 上(组织 SonicloudTech,主仓库两千五百多 star):录音通过蓝牙同步到电脑,落下来的是标准音频文件,不被锁在自家 App 里。文件是标准的,谁都能读,转写引擎自然想换谁就换谁——这次换的是 SenseVoice,阿里开源的语音识别模型,中英文混说、方言、日语韩语粤语都能听。
下面是完整的部署过程。
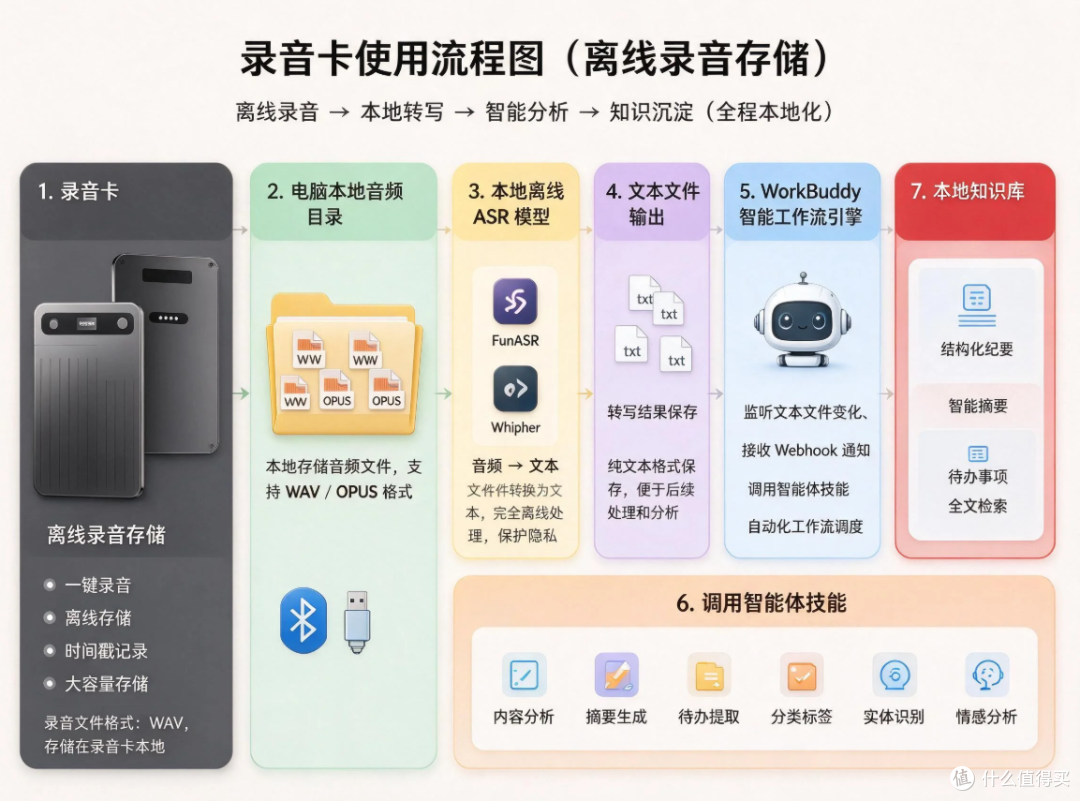
整个流程分六步:装运行环境 → 下载转写模型 → 准备一段测试录音 → 转成模型认的格式 → 跑转写 → 看结果。
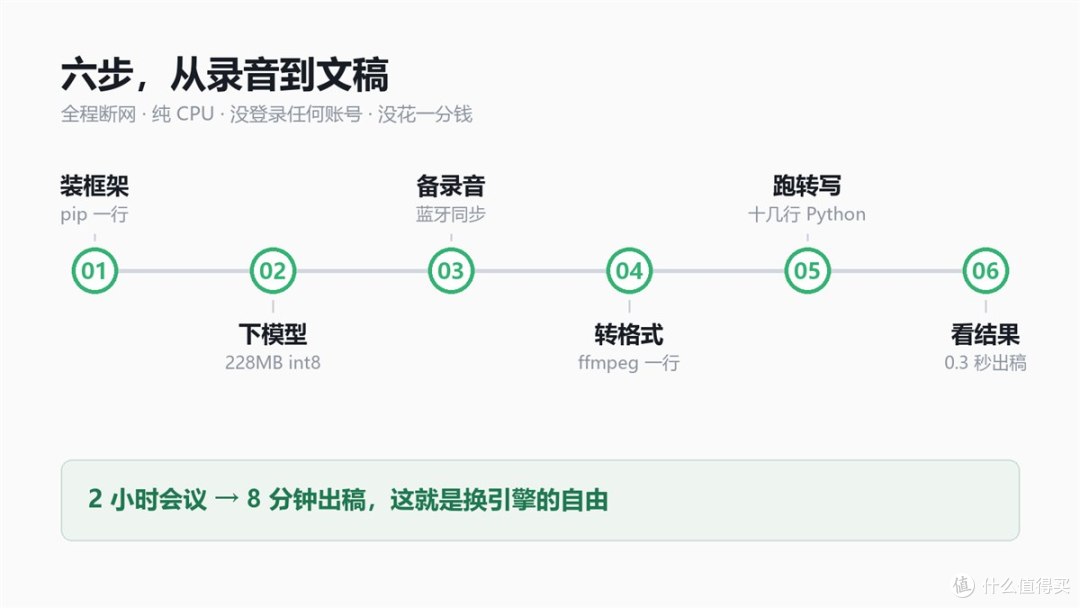
部署实录:六步
第一步,装推理框架。 SenseVoice 本地跑,社区通用的方案是 sherpa-onnx 推理框架,一行命令装完:pip install sherpa-onnx
第二步,下载转写模型。 从 sherpa-onnx 官方仓库的模型区,下载 SenseVoice 多语种版(中英日韩粤五种语言),选择 int8 量化版——228MB,比一张高清图还小,普通电脑完全无压力。
第三步,准备一段测试录音。 真实场景里,这一步就是录音卡本卡:会议桌上开录,蓝牙同步到电脑,落下一个标准音频文件。这次实验为了排除干扰,我用语音合成造了一段 8.9 秒的中文测试音频,内容里故意埋了"转写引擎""部署方案"这类专业词。
第四步,转格式。 模型要求 16kHz 单声道的标准 wav,一行命令完成转换:ffmpeg -i test.mp3 -ar 16000 -ac 1 test.wav
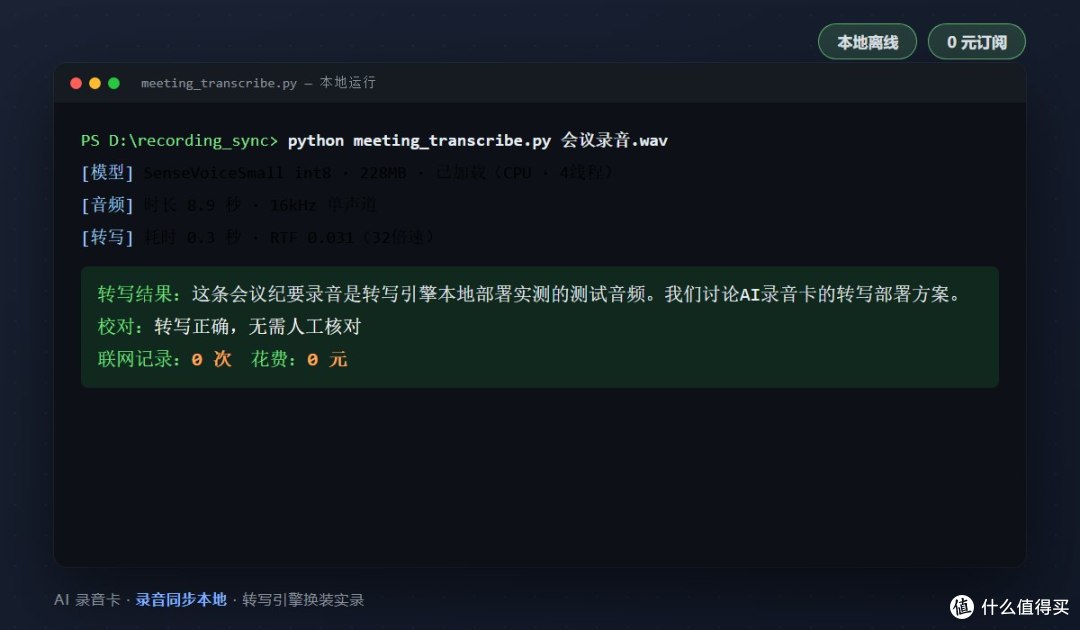
第五步,跑转写。 十几行 Python:加载模型,喂进音频文件,解码。完整脚本不用自己写——仓库 Speech-to-text—text-to-speech 目录里就有现成的 Python 示例,照抄就能跑。然后是全程最爽的一行输出——AUDIO_DURATION_SECONDS: 8.9;INFER_SECONDS: 0.3;RTF: 0.031
8.9 秒的录音,转写只花了 0.3 秒。RTF(实时率)0.031 的意思是:这段音频的长度是转写耗时的 32
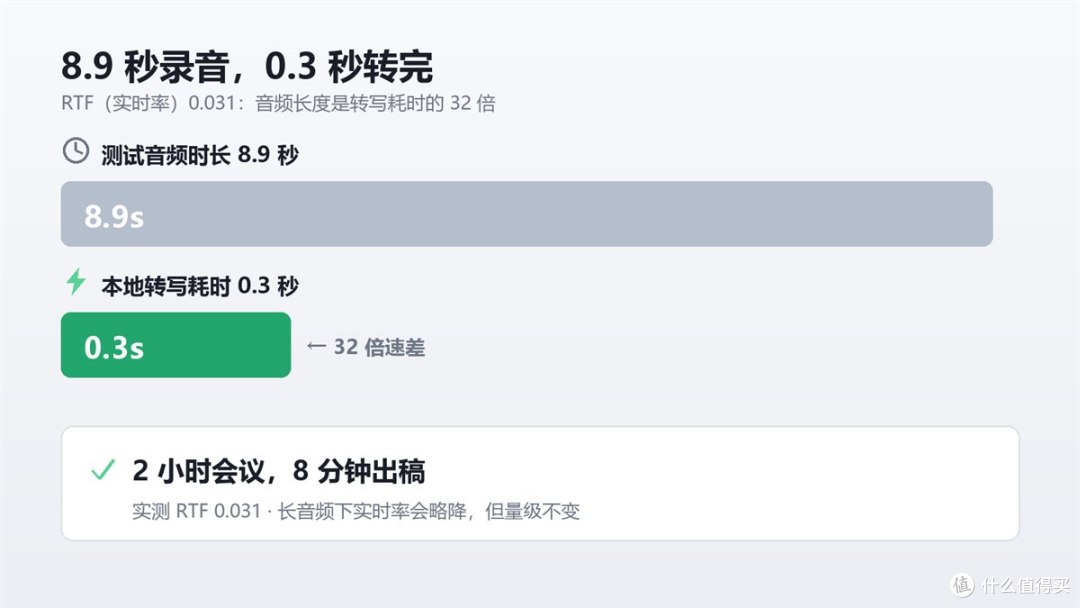
倍。按这个速度推算,两小时的长会,8 分钟上下就能出全文
第六步,看结果。 转写出来的文字是:
这条会议纪要录音是转写引擎本地部署实测的测试音频。我们讨论AI录音卡的转写部署方案。
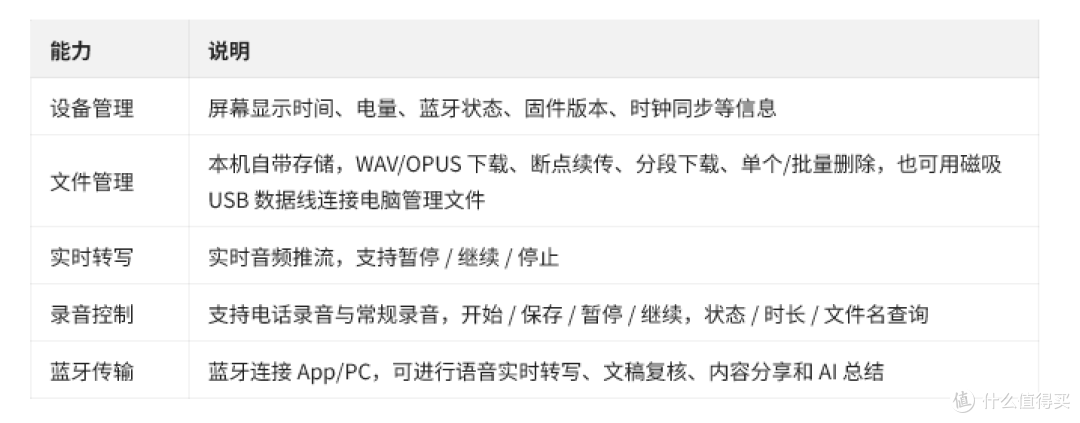
AI 录音卡的官方 App 有它省心的地方——开箱即用,自带转写免费额度,区分发言人,自动出纪要,配套的 App / PC 端能力也齐全:
但额度用完之后,转写这条路走不走得通,取决于协议开不开放。
这张卡把协议开源在了 GitHub 上,录音同步下来的文件是标准格式——所以这张卡同步下来的任何一段录音,都能照着上面六步做。引擎是自己的,模型是自己的,账单也是自己的。顺带说一句,这套方案连模型带框架都是可商用的开源协议,企业拿去做内部工具没有许可上的顾虑。
开源仓库:https://github.com/SonicloudTech/sonicloud_opensdk





