

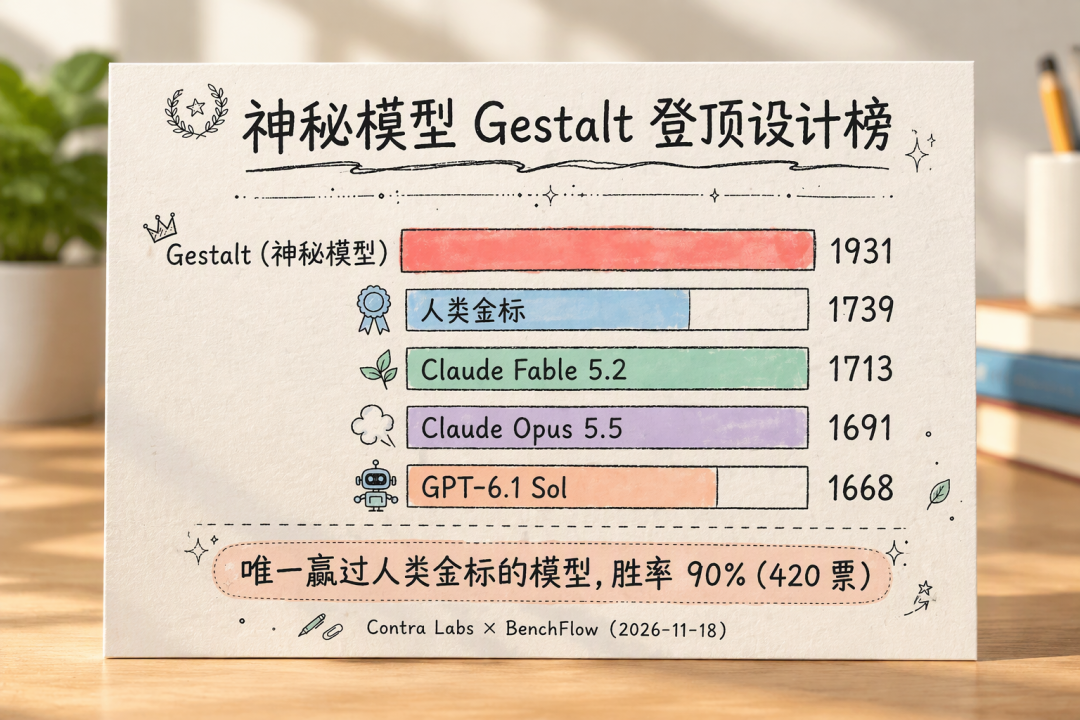
11 月 18 日,创意平台 Contra Labs 和评测机构 BenchFlow 发布了首期 Frontier Design Benchmark(前沿设计基准)。专业设计师的盲测里,匿名模型 Gestalt 以 1931 分 Elo、90% 胜率登顶;人类设计师的“金牌参考稿”1739 分排第二;最强的具名模型 Claude Fable 5.2 只有 1713 分,屈居第三。在 Gestalt 与人类金牌稿的 28 次正面交锋中,不知道作者身份的设计师们,20 次选了模型那一边。知乎微博知乎知乎
先把结论放这里:在这套评测“专业人盲评偏好”这一个维度上,Gestalt 确实赢了人类作品;但“全面超过人类”并不成立。同一评测的设计规范评分里,Gestalt 拿到 83 分,反而略低于 Fable 5.2 和 Claude Opus 5.5 的 84 分。真正值得盯的也不是 1931 这个排名分,而是另一个数字:1.2。知乎
它考的不是“做不做得出”,是“像不像专业水准”
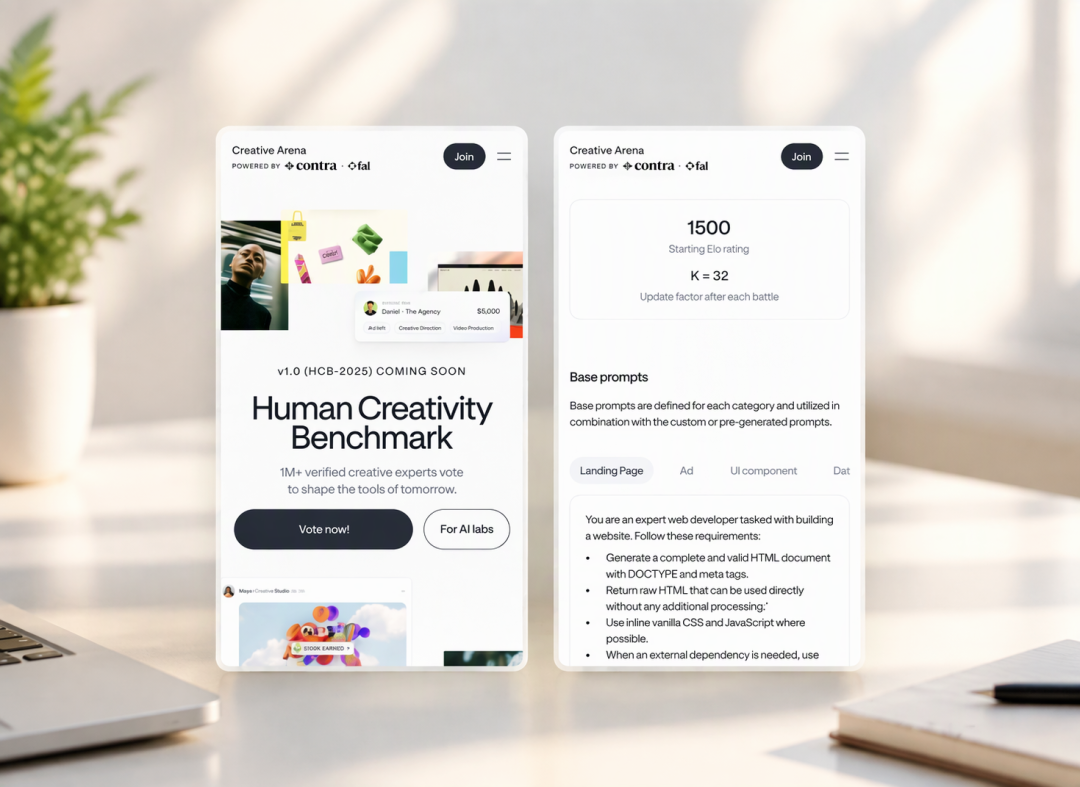
这个榜单的题目不是“给咖啡店做个落地页”式的即兴生成。33 个任务中,27 个改编自 Contra 平台上的真实客户委托,6 个来自合作创业公司,品牌素材、旧网站、产品图一并提供;场景覆盖多页网站、营销落地页、带操作流程的 Web 应用和移动端界面。35 位职业设计师两两盲比投票,累计 4311 票折算成 Elo 分。评测方给出的配套设计评审标准与设计师投票的相关性高达 0.94,说明打分不是各凭口味。知乎知乎知乎知乎
榜单因此呈现出清晰的梯队:Gestalt 1931、人类金牌稿 1739、Fable 5.2 1713、Opus 5.5 1691、GPT-6.1 Sol 1668、Claude Sonnet 5.5 1667、Kimi K3.1 Pro 1663,从第一梯队的 GPT-6.2 Astra 的 1638 分再往下到 Qwen3.8 Max 的 1434 分,中间隔着 204 分。模型之间通常只差几十分,Gestalt 领先人类参考 192 分、领先 Fable 5.2 218 分,是断层级的。微博知乎知乎
它赢的方式:不是最会设计,而是最不像 AI
这套基准有一个别的榜单没有的东西——“AI 味”检测器,0 到 100 分,越高越像 AI 做的。基准团队发现,93% 的 AI 生成页面带着同一套视觉指纹:标题上方一行小号大写字母的微文案(人类页面只有 11% 这么干)、标题里塞斜体强调词、按钮后面必配箭头、卡片到处堆砌、01/02/03 式的章节编号——人类金牌稿一次都没用过章节编号。知乎知乎
在这个口径下,人类金牌稿得 0.9 分,Gestalt 得 1.2 分,差距在误差范围内;其余头部模型最低也在 31 分以上,与人类差了两个数量级。知乎知乎
所以 Gestalt 登顶的实质,不是“比别的模型更会做设计”,而是“比别的模型更不像 AI 在做设计”。主流模型的工作方式接近组件式生成:单独一个卡片、一段渐变、一个圆角都“合理”,拼在一起却透出 AI 味——因为组织原则是局部优先。设计师们盲选出的“好”,首先是一种整体上的“说得通”,这恰恰是 Gestalt(格式塔,整体大于部分之和)这个词的本义。设计规范那 83 分也提醒我们:它在局部规则上并没有碾压,赢的是整体观感。
1931 分要连着四个“但是”一起读
第一,身份没人认领,产出看不见。Gestalt 以 stealth(隐身)模式挂在 OpenRouter 上,没有公司署名、没有定价、没有体验入口。公开画廊只展示具名模型的产出,Gestalt 的项目不在其中,读者无法复核评委究竟看到了什么。11 月 21 日起,有知乎回答按“创始人公开喊出创意 AGI 并点名相关方、公开招聘模型研究员、融资文档致谢爆料人”等间接线索,把它指向旧金山的 AI 界面设计公司 Variant,但该公司和 Contra 均未确认。X 上甚至出现“中文网友猜 Fable 5.5、英文网友猜 GLM 5.5”的镜像互猜。这些说法都没有官方佐证。中国人民大学高瓴人工智能学院有一项同名的多模态研究,属于概念撞车,不能当作身份证据。知乎知乎知乎微博知乎
第二,评测方与受益方存在重合。Contra 既运营设计师市场,又发布评测设计能力的基准,且没有第三方复现。“AI 比设计师行”的结论出自卖设计师服务的人之手,发起方自己的推文措辞其实也留了余地:“设计师仍然更好”。知乎知乎
第三,样本小、榜单在动。Gestalt 的领先建立在 420 票之上,与人类的正面对决仅 28 次。11 月 18 日发布当天的快照里,排第一的还是人类金牌稿,18 日与 19 日两版数据的票数(3591 票与 4311 票)也对不上。知乎知乎
第四,成本未知。有分析按保守口径估算 Fable 5.2 每做一个网站约 127 美元,Gestalt 没有对应数据点,无法判断优势来自更聪明的生成路径,还是不计代价的推理开销。知乎
对设计师和普通人,这意味着什么
Contra 顺手公布了自家平台的行情:一年约 4600 个网站订单,客户需求说明的中位数只有 138 个单词,预算中位数 1050 美元。如果这份榜单反映的能力是真的,最先被冲击的就是这种千元级“标准件”建站生意:小店主多了一个便宜选项,但验收的功夫得自己下——至少学会识别上面那几种 AI 味,判断交上来的页面是“像你的生意”,还是“像所有人的生意”。知乎
对设计师,这份榜单指向的不是转行,而是护城河移位:把局部组件拼整齐的执行价值在变薄,值钱的越来越是理解客户、把关整体品味、对结果负责。这事的时机也耐人寻味——Anthropic 刚刚在 11 月 19 日敲钟上市,一个匿名模型随即在设计榜上把 Claude 全家压在身后。全网“谁在狙击谁”的猜想在相当程度上是资本叙事的延伸,而非技术结论。小红书知乎
至于它到底是谁、能不能持续,观察三个信号就够了:开发方是否认领、是否开放公开测试、其他机构复测时能否复现这个断层差距。在这三件事落地之前,“AI 设计全面超过人类”是过度解读,“AI 在整体品味这一关通过了专业盲评”才是这份榜单真正给出的东西。

当前文章无评论,是时候发表评论了