

让AI看错,而不是看懂:中大本科生把逆向Token账单推高639倍
「逆向一切」的 REA 还在刷屏,反制它的人已经动手了。
GitHub 上 10 月 25 日出现了一个叫 BLA 的项目(全称 Blind LLM Agents,让大模型 Agent「失明」),如今 GitHub 官方 API 显示已攒下六千多个 star。作者 Timo Zhang,中山大学软件工程大三,现在在字节实习。他干的事,就是让那些「什么都看得见」的 AI 逆向工具看错。知乎GitHub
AI 逆向太便宜,有人坐不住了
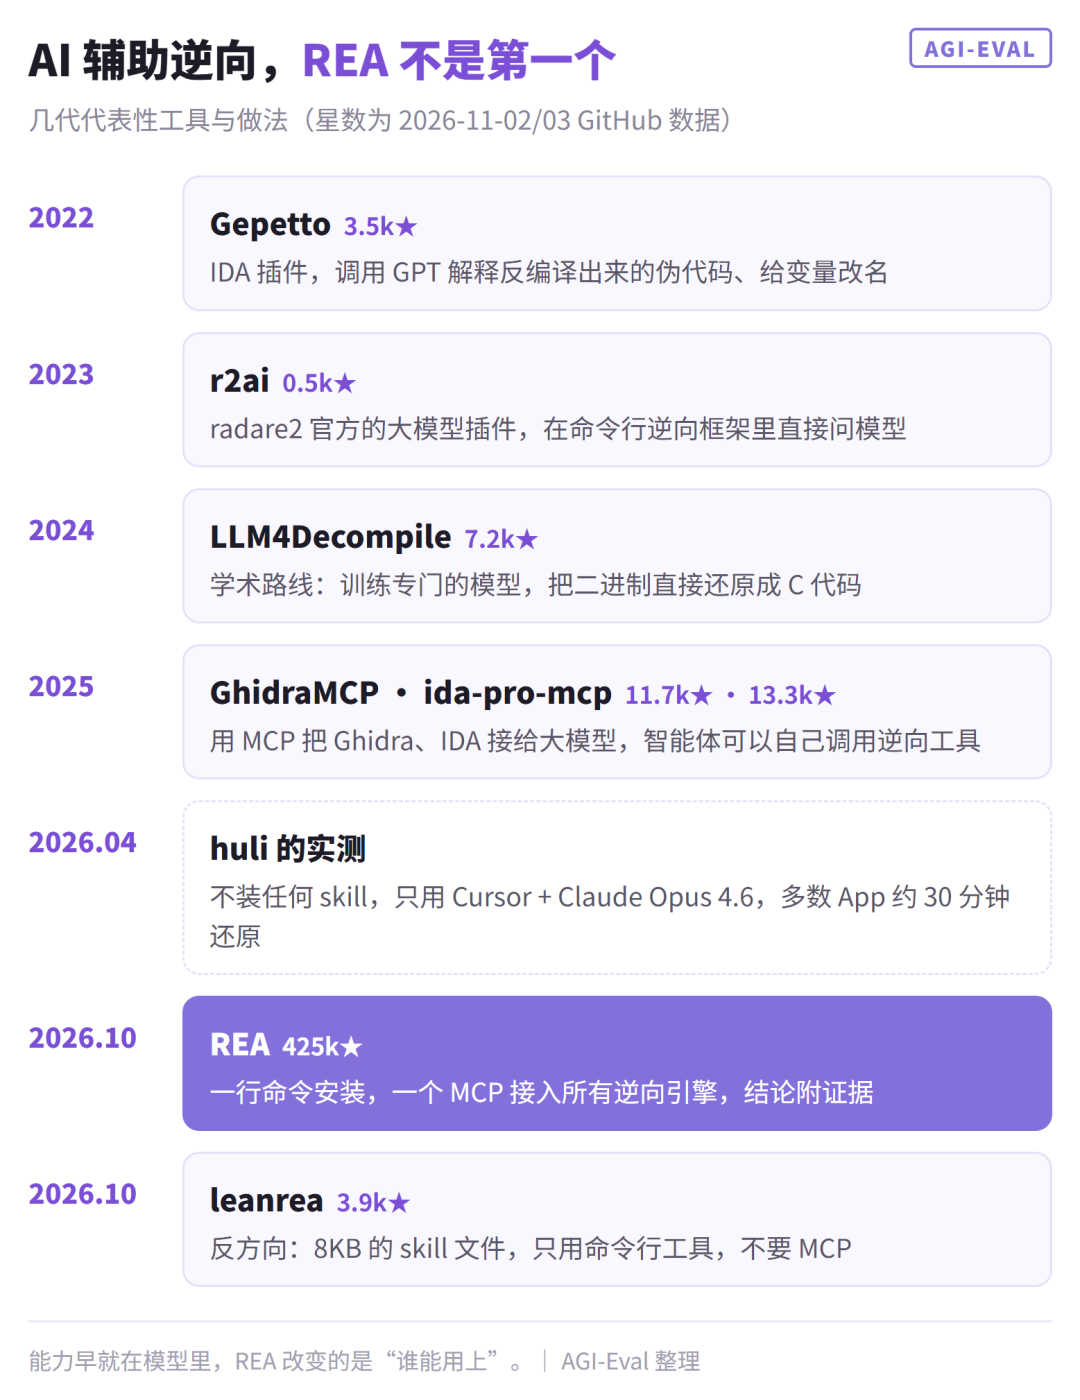
REA 是这两年逆向圈的怪物,GitHub 星数已冲到 47 万(官方 API 实时数据)。你把一个编译好的 .exe、前端 bundle、APK 丢给它,它自己接上 Ghidra、IDA,自己追函数、推意图,最后按你的技术栈重写一份「同款」。社区吵得最凶的也是成本。逆向从「几个人几周的手工活」,变成了「烧几个小时的 token」。微博
于是 BLA 反击了。它的路数比加密更阴——不是把你的代码变难读,而是故意造假证据,让 AI 读错。
三步,把对手账单推高 639 倍
第一步,投毒。 BLA 往你的文件里塞「诱饵」:最典型的是假 Source Map,格式完全合法,内容全是编的。一段普通客户端代码可以被伪装成在调用硬件安全区,连远程认证接口和注释都配齐了。Agent 一旦信了这条线索,就会顺着一根根本不存在的调用链往下刨——走得越深,烧得越多。
第二步,卡爆配额。 REA 的分析器内部有硬编码上限,BLA 精准踩点。以 Electron 的 .asar 包为例,索引头里塞进约 4000 条诱饵条目,每条内容极短、路径极长,体积全堆在索引上——作者实测,一个 607 字节的包能撑成 16.93 MiB,REA 读取时直接报错。知乎
第三步,诱导误判。 假线索堆够,Agent 就把假的当成真的,反复验证、反复推翻,token 继续涨。作者做了 13 个加固前后对照:内部测试口径是加固后 token 消耗约为原来的 300–2800 倍,按 14 个示例包均值估算约 639.5 倍、费用约 304.4 倍。要说明,这些是作者自测数据,目前没人独立复现过。知乎知乎
BLA 打中的不是代码,是 Agent 的设计缺陷
这项目的聪明和局限是同一件事。它防不住逆向,只是让逆向变贵。 13 项对照里有 3 项根本没被阻断,包膨胀大不了忍了,配额上限也可以调——它买的是时间,不是安全。但它暴露的问题是真的。Agent 默认无条件信任输入,这和 prompt injection 是同一个病根。知乎上有分析说得直接:BLA 的教材价值大于防御价值,当摩擦层用挺好,当护城河用就找错地方了。知乎知乎
真正的转变在度量衡。以前聊软件安全,聊的是「能不能进去」;现在多了一层,聊的是「进去要花多少钱」。逆向成本一旦低于购买成本,付费软件就开始「裸奔」;加固的逻辑反过来——把成本抬回对手不肯掏钱的线上。
给普通用户的三个实用判断
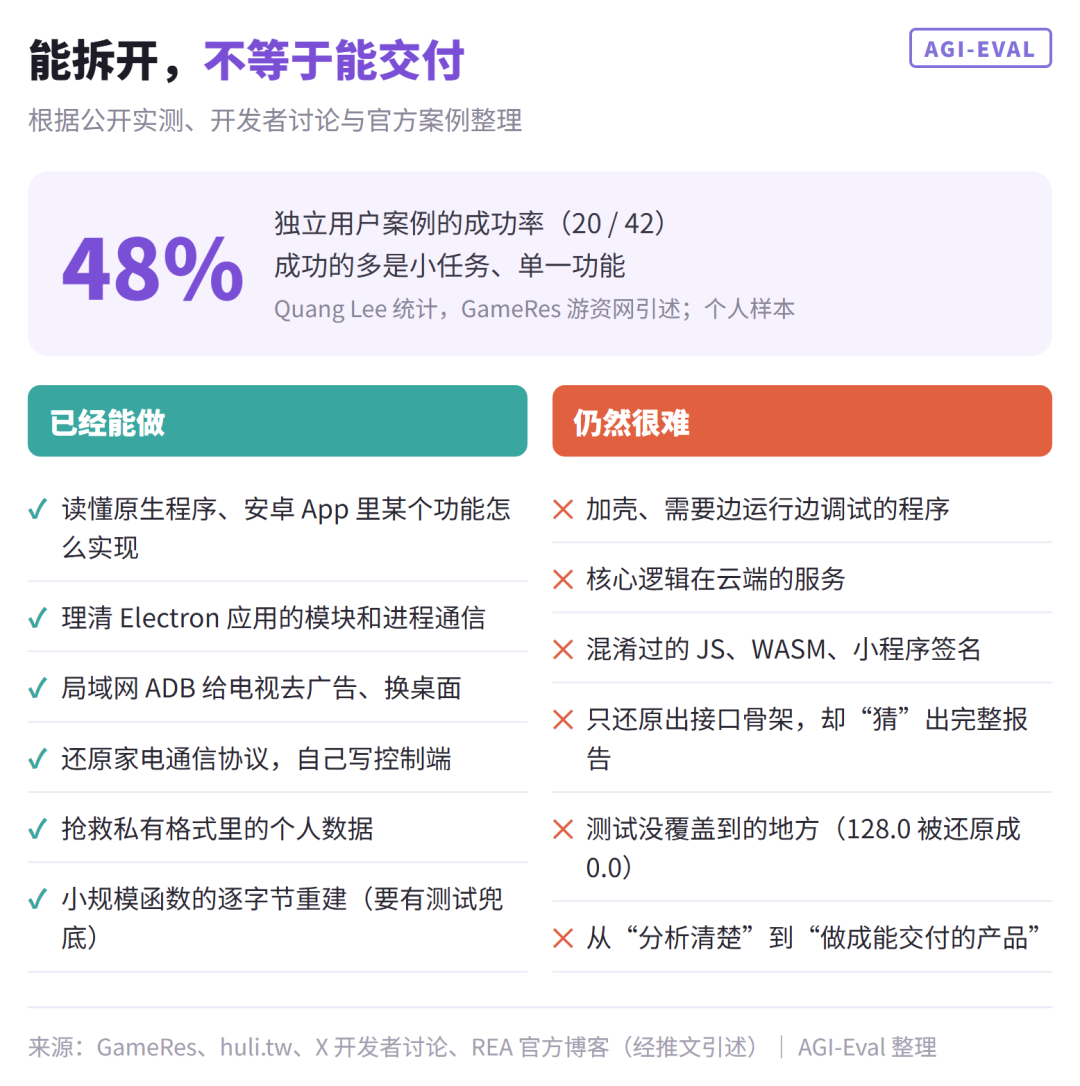
做付费小工具的,别赌「逆向不了」。核心逻辑放服务端,客户端只留壳,AI 拆得再狠,拆到的也是空壳。
拿软件做个人折腾(比如给自家智能电视去广告、改个自用版),和把破解版放出去传播,不是一回事,红线别踩。
同一个人还写了个叫 mu(μ)的项目,专门帮 Agent 省 token。一个帮你省钱,一个帮对手花钱。 这俩放一起看最有意思:Token 成本,已经成了一个可以被设计、被攻击、被防御的量。
以前逆向是手艺人,现在是流水线;以前只有师傅会拆,现在人人一句话就能拆。BLA 的出现说明另一件事也在同时发生。流水线刚铺好,挖坑的就已经把坑挖到了流水线上。这场攻防没有终局,它只是换了一张计价单。
当前文章无评论,是时候发表评论了