

匿名参测——行业里更准确的说法是stealth(隐身模型)——确实是AI圈的常规操作,甚至有固定节奏:新模型官宣前的最后几天,厂商把它以匿名代号送进盲测,真实用户在不知情的情况下投票。Gestalt真正反常的不是匿名,而是匿名的地点:它登顶的榜单刚上线三天,主办方不是大家熟悉的中立竞技场,而是一家自己就靠设计师接单吃饭的平台。所以这盘算很可能是双向的:厂商在布局,评测方也需要这个故事。知乎
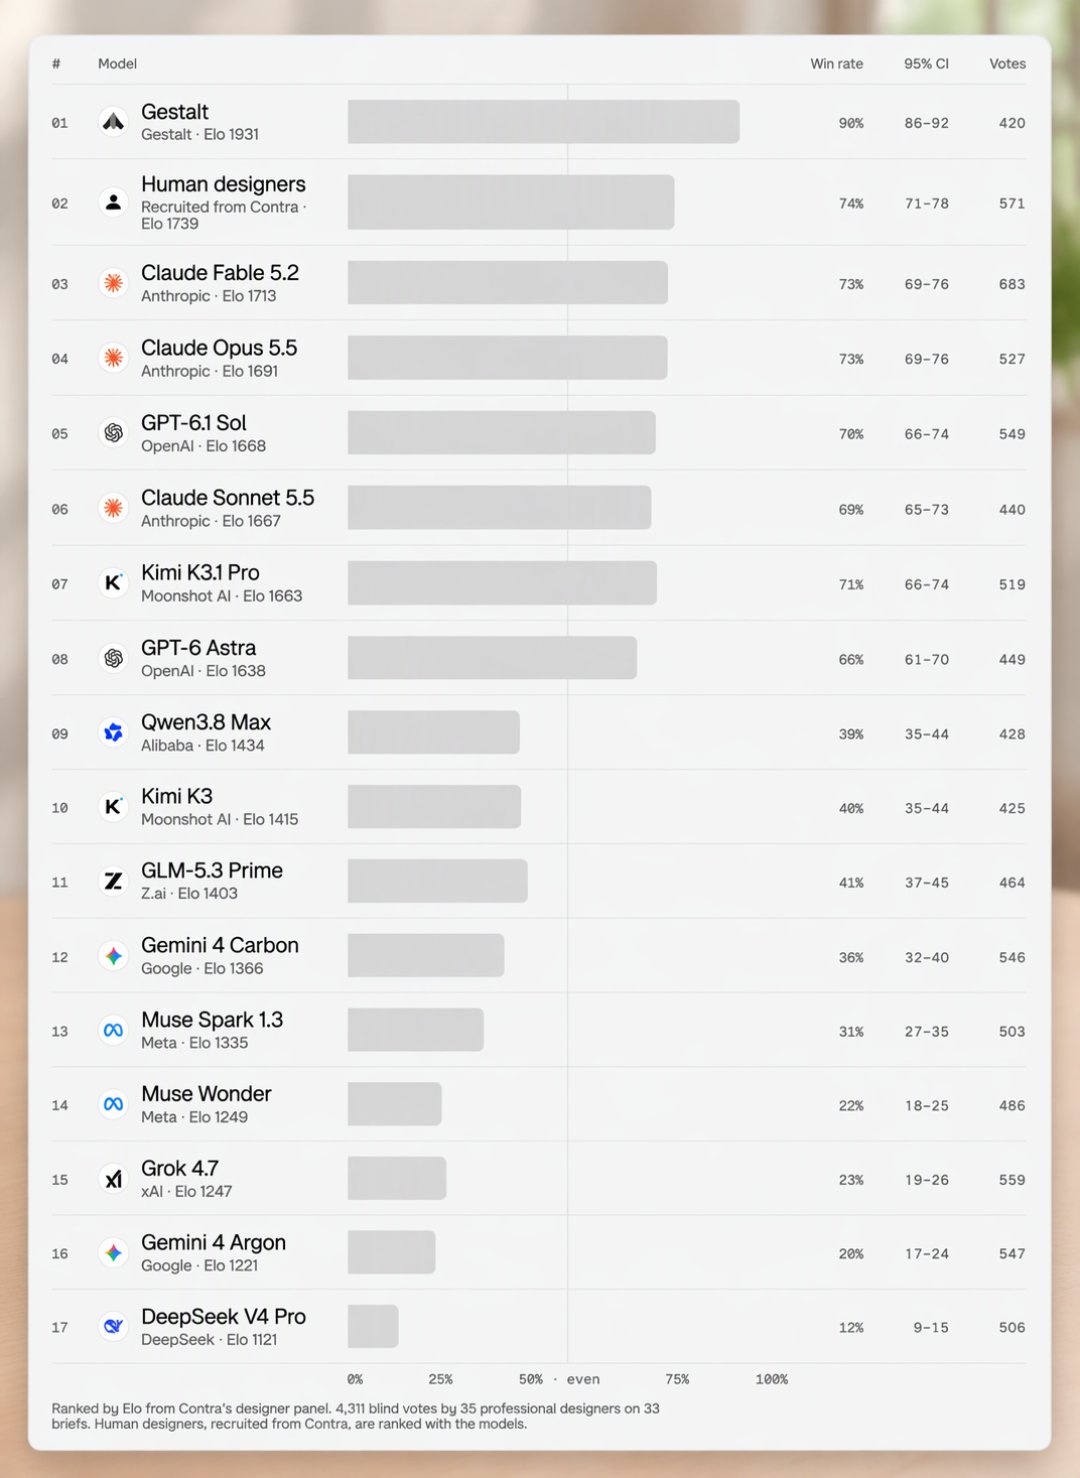
先摆成绩。11月18日,Contra Labs与BenchFlow发布首期Frontier Design Benchmark:33个真实客户brief,覆盖多页营销网站、众筹结账流程、带测验的在线课程,35位网络内专业设计师两两盲评投票,4311张票汇成Elo分。知乎知乎
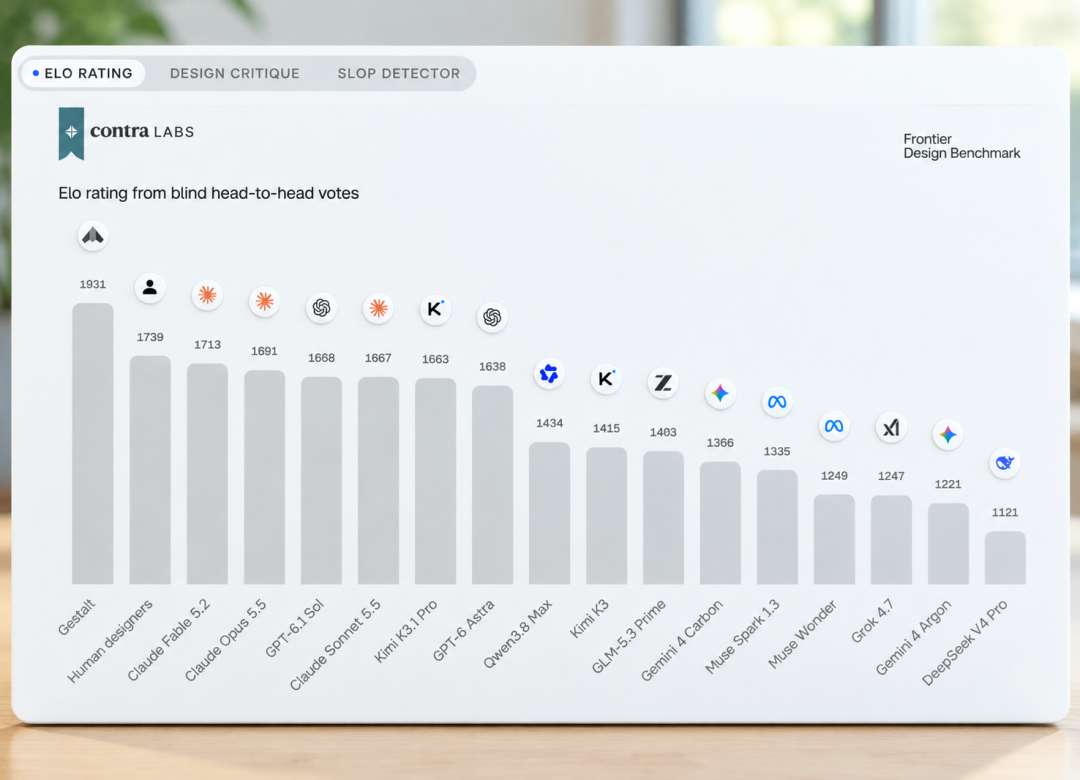
榜单上线后不久,一个没人听说过的匿名上榜者出现了:Gestalt,Elo 1931、胜率90%、420票,人类设计师参考作品以1739分屈居第二,具名最强模型Claude Fable 5.2只有1713分。按技术拆解的口径,Gestalt领先人类参考设计192分、领先Claude Fable 5.2达218分。知乎知乎微博知乎
再往下看,Claude Opus 5.5、GPT-6.1 Sol紧随其后,第一梯队向下到Qwen3.8 Max这一档隔着两百多分,直接分成两个梯队。截至11月21日媒体报道时,它的开发团队与架构尚未公开,价格与试用方式也没有任何官方信息。知乎微博
厂商的算盘:匿名测试是有剧本的老套路
这套行规近例一抓一把——Kimi K3发布前,代号Kivine的模型提前数天现身;Qwen3.8-Max发布前,代号Kaleb仅仅提前一天出现;今年10月下旬,两个匿名模型Kibitz和Kalmia出现在编程盲测里,被社区大量拆解,分别被疑为Kimi K3.1和Qwen 4。最典型的还是Kimi K2:按LMArena官方博客的记载,它以匿名代号首秀就拿下高难度题第一、总榜第四,是第一个挤进总榜top 5的开源权重模型。知乎知乎
算盘有三层。其一,盲测过滤品牌偏见,成绩看起来更干净;其二,匿名期冲进头部,揭晓当天就是一波免费传播——K2那句"首个进前五的开源模型"就是这么挣来的。其三,相当于正式发布前跑了一轮免费的真实场景压测。连代号都是预告:Gestalt是德文"完形",格式塔心理学的第一命题是"整体大于部分之和",在设计榜上用这个词,摆明竞争的是品味而不是出图。知乎知乎
反常之处:这场匿名不在常规场地
对照剧本,Gestalt有三处不一样。常规匿名发生在第三方大型盲测、投票来自全网用户;Gestalt的评委却是一个与榜单主办方关联的封闭设计组——公开画廊只展示具名模型的产出,它的项目不在其中,最抓眼的"与人类金标28次对决赢了20次",样本量偏小、外界无法查验,依据的正是这个封闭评委组。时间上,它登顶的窗口与Anthropic敲钟上市几乎重叠,社区拿"狙击上市公司"开玩笑,但没有任何证据支持因果——Anthropic自己还是榜上最大的具名玩家。知乎知乎
更值得玩味的是评测方的位置:Contra既运营设计师接单市场,又发布评测设计能力的榜单,既当裁判又与结果存在利益关联,还邀请各家实验室联系其团队获取真实需求、金标和选票,全程没有第三方复现。而且这期榜单刚上线时排第一的还是人类设计,Gestalt是后来才冒出来、一出现就把所有人甩开的。知乎知乎
这并不意味着分数造假——这套榜单的评审标准与设计师实际打分的相关性达到0.94,机器判断和人的判断基本一致。但反过来想:一期新榜单想要全球声量,最好的开局剧本恰恰就是"匿名模型打败了人类"。在身份揭晓前,1931分是个需要认真对待、也值得认真怀疑的数字。知乎
最该盯住的数字不是1931,是1.2
如果Gestalt只是"赢面更大",这新闻两天就过去了。真正让技术圈讨论的是它独有的另一项指标:这套榜单配了一个别的榜没有的slop检测器,0到100分,分数越高说明页面越"像AI做的",而基准团队发现约93%的主流模型输出带着同一套视觉指纹——标题上方的小型大写微文案、01/02/03编号版块、渐变滥用、玻璃拟态、超大圆角、巨大居中头图。知乎
而分数出来之后:Gestalt和人类的差距落在误差范围内,主流模型和人类的差距是两个数量级。说白了,Gestalt登顶的实质不是"更会做设计",而是"更像人做的"。盲评里,消除AI感比提升任何单项都更有杠杆,这也和代号呼应:组件式生成每个零件都对、拼起来就是AI味,它赌的是整体组织。知乎
代价是个黑箱:拆解文章给出的保守估计是Claude Fable 5.2每个站点约127美元成本,Gestalt没有任何成本数据点——218分的优势来自更高效的路径还是烧钱推理,没人知道。知乎
是常规操作还是行为艺术:看信号,别看猜名
目前评论区的嫌疑人名单从Anthropic、Meta一路排到智谱、豆包、人大,这些猜测都没有来源支撑,讨论也很快从"它做得怎么样"转到"到底是谁家的"。小红书上相关笔记一天内攒下八百多赞、四百多条评论,"超过Claude Fable 5.2、把人类设计师挤到第二名"成了最常被转述的卖点。知乎小红书
最耐人寻味的是,中国人民大学高瓴人工智能学院等机构确实有一篇公开研究同名Gestalt,主打模态间的受控交互,技术叙事上最有呼应——但同名不等于身份,在开发方认领之前它只能算假说。知乎
等答案的人可以直接抄社区流传的信号强度清单:第三方托管平台模型列表上新是硬证据,推理栈的部署加固提交是强旁证,盲测平台匿名代号居中且有撞名风险,API端点嗅探截图最弱——截图成本太低。落到Gestalt身上,开发团队没有公开、厂商和价格没有公布,接下来要等的就是三件事:有人认领、作品开放可见、第三方跑出同数量级的复现。三样齐了,1931才和普通用户发生关系。知乎知乎
所以标题那两问各有答案:匿名测试当然是常规操作,有名字、有先例、有剧本;但"在一期上线三天的自营榜单上匿名登顶、且看不到任何产出"不是常规,是选择。至于算盘打给谁,裁决方式很朴素——揭晓并开放使用的那天,这个分数要么兑现,要么现形。在此之前,唯一已经确定的信号是:AI设计生成的竞争轴正在从"局部组件质量"转向"整体像不像人做的",这比冠军是谁更值得留意。

当前文章无评论,是时候发表评论了