

那个常年放话"AI 九成是营销"的男人,这次亲手把「llm」写进了内核分支名。
真事:Linus 官方仓库里,挂着个带 LLM 后缀的分支
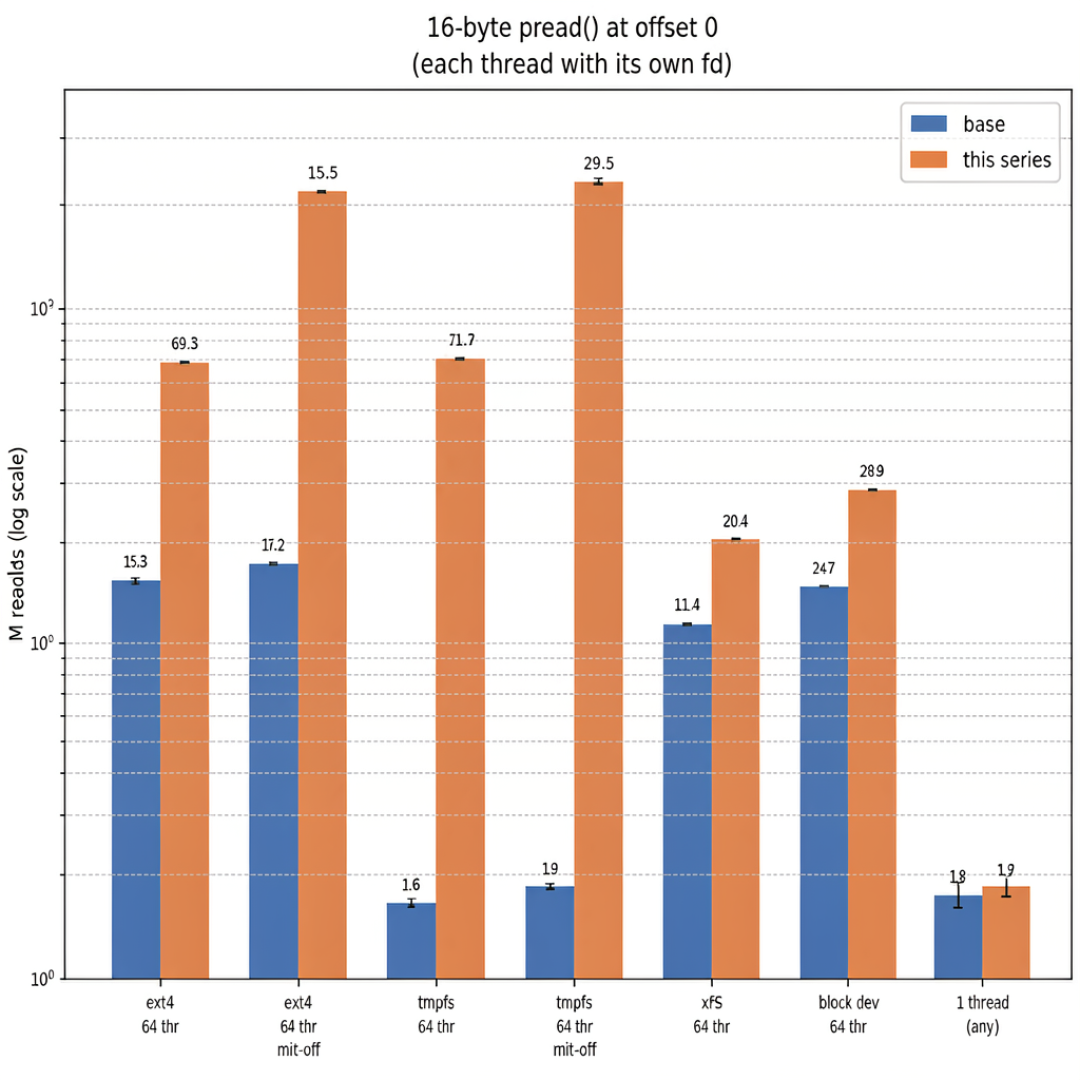
10 月中旬,开发者刷 Linus 的官方内核仓库时发现一个诡异新分支:noref-filemap-read-with-llm——后缀明摆着写着"有 AI 参与"。更罕见的是 Linus 在补丁说明里大大方方承认:核心代码、测试用例、改动审查到文档初稿,全是他手把手带着 Claude Code 搞出来的。据 Phoronix 报道,这轮优化把 8 线程并发读同一文件的吞吐量干到了原来的约 3 倍。知乎哔哩哔哩
硬核拆解:AI 动的是内核最核心的内存管理
Linux 用 page cache 缓存文件数据,多个线程读同一个文件时,每次都要在承载缓存的内存块(folio)上加减原子引用计数。几个 CPU 核心为同一个计数疯狂执行 `lock cmpxchg`,把缓存行传来传去——这个顽疾早在 2024 年就被核心开发者 Matthew Wilcox 点出过,Linus 实测瓶颈吃掉了 99.92% 的开销。知乎
Claude 参与的方案很聪明:读取路径上干脆不加引用计数(noref),缓存页被移除后延迟归还分配器,靠 RCU 宽限期保护正在进行的读取。在一台 i7-8565U 笔记本 + ext4 的测试里,8 线程每次只读 16 字节,吞吐从约 1000 万冲到 3300 万。
顺手还挖出一桩十年旧案:第二天仓库又冒出 assoc-array-fixes 分支。Linus 嫌这个 2013 年的老数据结构代码晦涩,让大模型梳理、拆函数,再塞进用户态测试框架跑——不仅确认了外部报告的 Bug,还额外揪出 3 个同样潜伏十余年的缺陷,其中一个只要 18 个键就能触发对象丢失。知乎
评论区:玩梗归玩梗,清醒的人也不少
B 站和知乎热评第一梯队全是梗:"Linus 早就在邮件列表指挥能工智人搞 vibe coding 了,只不过以前得回邮件,现在不用。"但仔细看,段子背后有个关键共识被反复提及:AI 只负责初稿,透明披露写进补丁说明,维护者照常 review——“Linus 不会允许 Agent 写出屎山”。这才是这件事真正的信号量:不是 AI 接管内核,而是内核这种最难分支,AI 已经能进正式工作流了。别忘了 OpenAI 更早让 Codex 写过 3000 行 Gluon 内核级代码——跑得快,但工程师自己都讲不清它干了啥。哔哩哔哩知乎知乎
对搞内核的你,这是焦虑题也是送分题
先说证据边界:目前这只是一个实验分支,别脑补"内核程序员没用了"。反过来想:AI 最擅长的恰恰是边界清晰、验收可自动化的任务——输入输出明确、跑分说了算。而"知道该写什么、判断写得对不对"这两件事,AI 至今没展示出替代能力,它的底座全在老功夫里:内存管理、锁的演进(从关中断到 futex)、内核里那十几个反复出现的数据结构。哔哩哔哩知乎
一句话总结这次事件的价值排序:写代码在降价,判断力在涨价。你现在背的每一页 TLB、每一个 RCU 语义,都正在变成和 AI 对话时的定价权。
Talk is cheap——但这次,Linus show 的 code 旁边,真站着一个 Claude。

当前文章无评论,是时候发表评论了