

11月19日,DeepSeek V1 作者之一、DeepSeek-VL 前负责人张博,开源了新公司 Simplex AI 的首个项目 Linger:一个装在自己电脑上的个人 Agent。两天里 B站相关视频播放过万。它的三句宣传,正好戳中本地部署 AI 的人:12GB 显卡跑 125B、零 token 费、数据不出本机。三句都成立,也都有前提。小红书哔哩哔哩微博小红书
12G 跑 125B,是"轮流经过"不是"塞进去"
125B 压到 2bit 还有 39GB,12G 的卡装不下。Linger 靠自研的 PolyStrata 拆开:最忙的专家权重常驻显存,次忙的放内存,最冷的扔 SSD,用到哪块调哪块。显存不再是天花板,代价是每换一次专家就搬一次数据。小红书哔哩哔哩
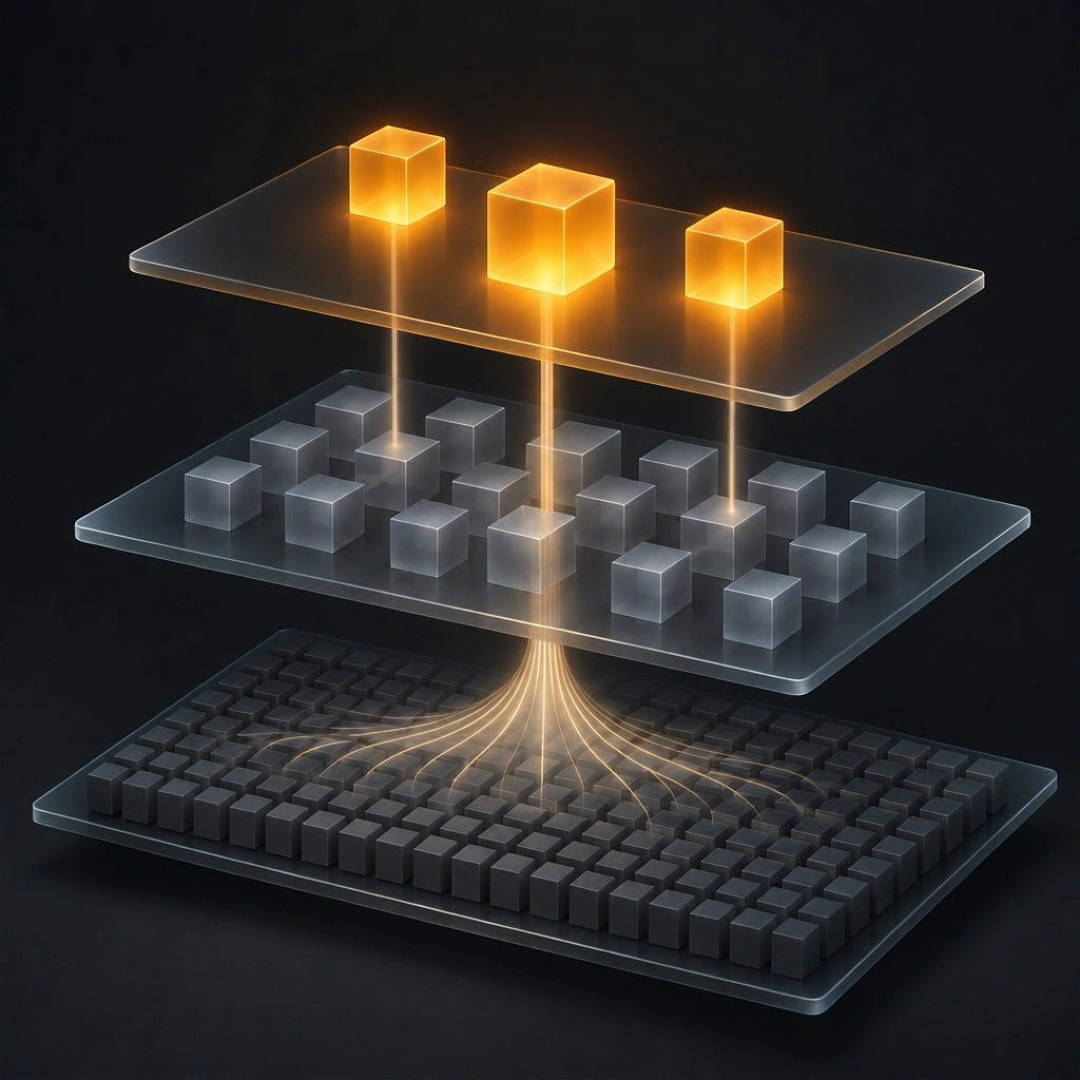
官方数字:12GB 显存的老 RTX 3060 配 64GB 内存,跑 125B 的 Qwen3.8-Flash-Next,45.5 tokens/秒,脚注写着这是稳态速度、不含首 token 等待。内存砍到 32GB 那档掉到 21.3 tok/s,首字要等约 3 分钟。而且低配那几档不是真机跑的,是在一张 96GB 卡上限制显存预算模拟的;12GB 这档默认给的其实是更小的 35B,125B 只是上限。小红书哔哩哔哩小红书
零 token 费是真的,账单换了个名字
本地推理不产生云端账单,这句没错,但只是账单的一半:硬件你出,电你出,首字等三分钟的时间也是你出。更要紧的是 Linger 本身是个壳,干活的 Runtime 挂 Claude Code、Codex 或 Pi——图省事用已有云订阅,对话照样发给服务商。Gmail、Slack 走 Composio,语音走 Soniox 和 xAI,免费额度之外都要花钱。哔哩哔哩小红书小红书
“数据不出本机”,文档自己列了四个出口
这条最值得看,它是大多数人装本地 AI 的真正理由。
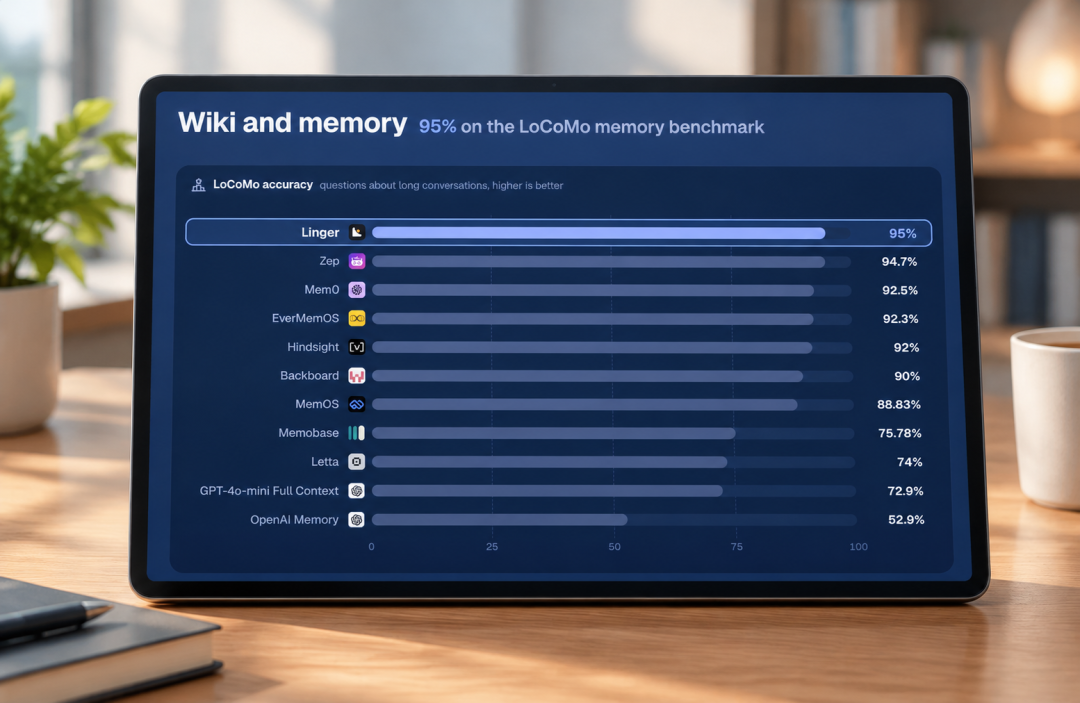
做到的部分是真做到了:文档写明模型优先本地跑,记忆和知识库留在你的磁盘。内置助理 Another Me 每晚 00:00 把收件箱、日历、聊天和会议整理成本地 Wiki,记忆基准 LoCoMo 官方报 95%。小红书哔哩哔哩小红书
但同一份文档也写着,对外连线走四条路:远端模型 Runtime、Composio、Soniox、xAI。后台记忆任务永远跑在 Claude Code 或 Codex 上,挂了云订阅,每晚读到的邮件和聊天照样发给服务商。哔哩哔哩哔哩哔哩
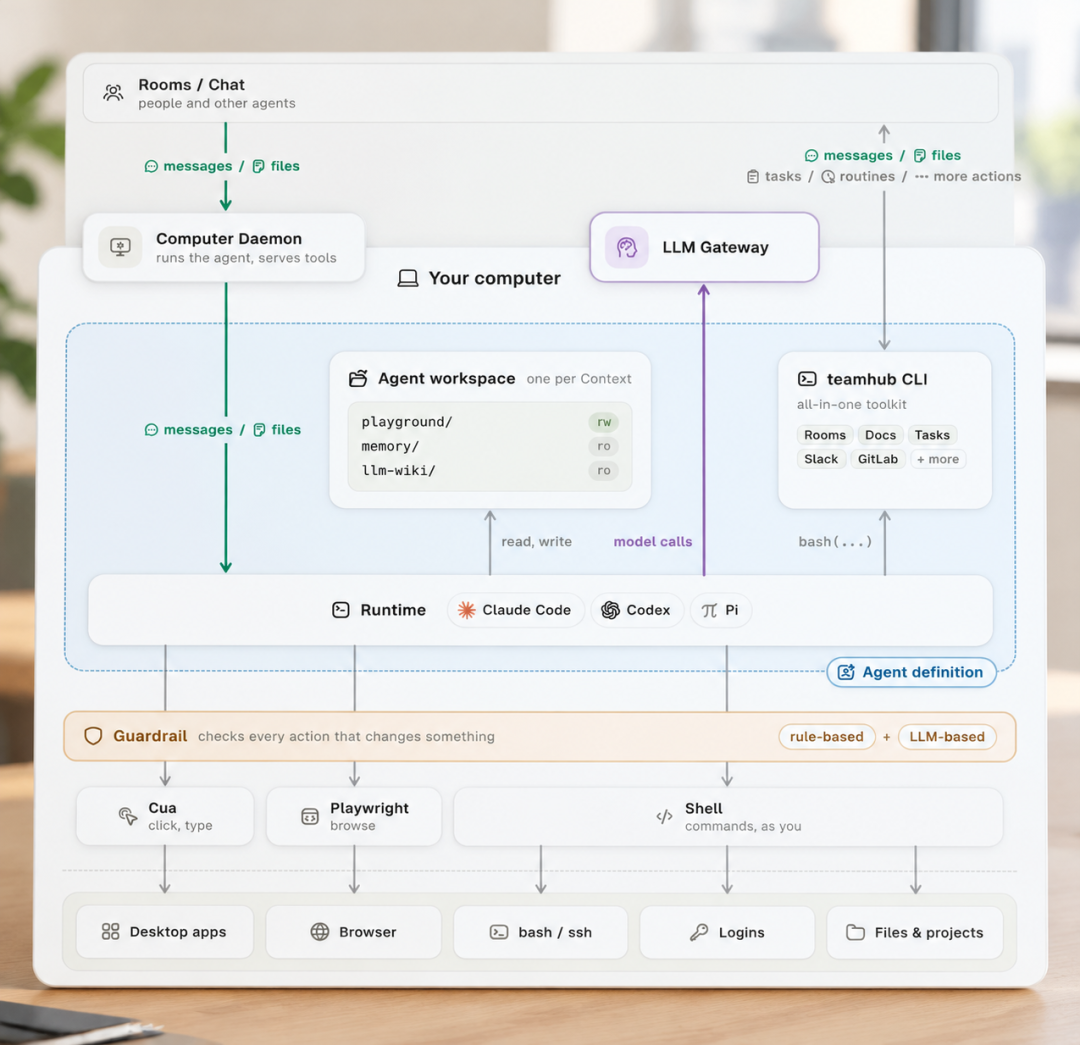
还有一条更直接:没有沙箱隔离,Agent 以你的系统权限运行,能碰这台电脑的文件、已登录应用和命令行。确认卡和服务端校验只挡写操作——发邮件、改文件才弹卡,读直接执行,你不会被逐次打断。所以本地能跑,不等于数据不出门,这条线得你自己划:要不要挂云订阅、要不要接 Gmail 和 Slack、给哪几个文件夹授权,装之前就定。哔哩哔哩小红书
该不该装
许可证是 Apache 2.0 加附加条件、不是 MIT,商用前得看一眼。别的企业不能拿源码做托管、不能删改前端 Logo,hosted 版只开了等候名单、没公布定价。想试的话,官网下载还标着 Coming soon,只能从 GitHub 拉源码或配 Docker Compose。开源和生意,在这里分了层。小红书哔哩哔哩小红书
这天不是"云要被干掉"的一天,是 Agent 分成两层的日子:一层常驻你的机器,管每天重复的收邮件、整日程、翻文件;另一层是重活,还得上去按次付费。张博说想让数据、上下文和智能都回到你自己电脑上,这话说对了一半。另一半是:分散之后,运维、权限、电费,全归你。小红书
当前文章无评论,是时候发表评论了