

11月18日中午,腾讯混元官方账号宣布 Hy4 flash 开放权重,指令版、FP8 版、Base 底座版一次放出三个。权重同步上架 HuggingFace、魔搭、GitCode 和 GitHub。刷屏的那句是“总参数量为 224B,激活参数 12B”。不少人第一反应:12B?我那张 24G 卡是不是能试试?知乎微博知乎腾讯混元
不能,而且差得挺远。
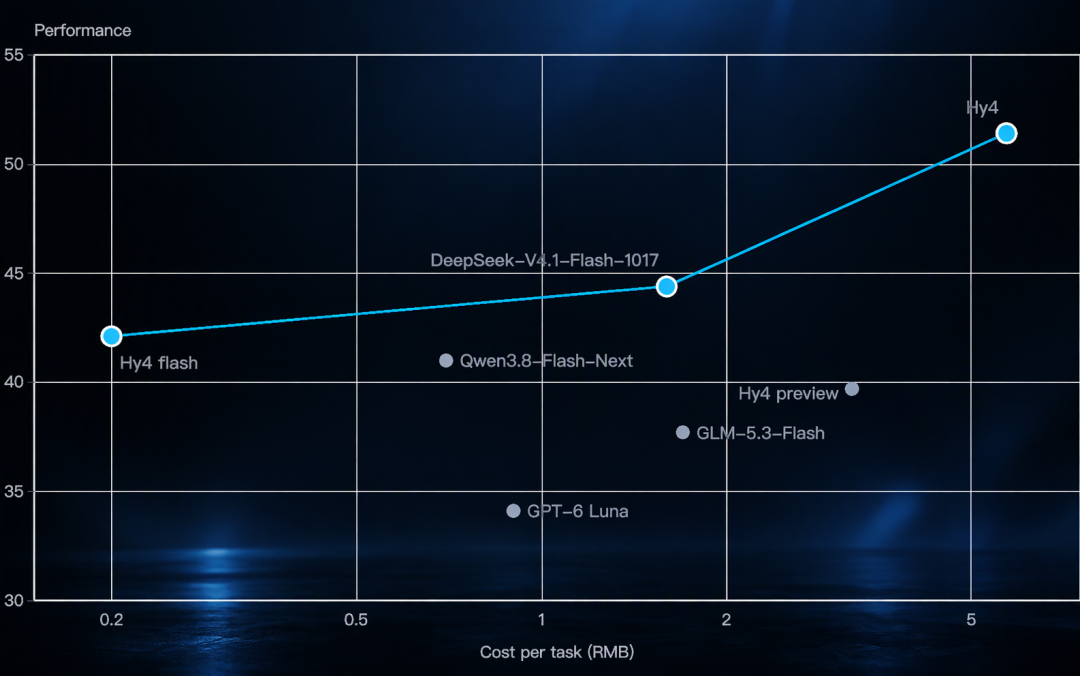
激活 12B 决定速度,不决定门票
MoE 的玩法是 512 个路由专家里挑 16 个干活,可这 512 个专家得先全躺在内存里,你才挑得出来。激活 12B 只说明每生成一个 token 要从内存搬多少权重——它管你跑多快,不管你跑不跑得起来。知乎
门票是总参数。220B 权重,一个字节都少不了。
官方路线是八卡
魔搭那篇部署文档写得直白:生产部署走 vLLM 或 SGLang,服务示例采用官方给出的 8 卡配置。这不是今晚能在家一键开服的模型。魔搭社区知乎
微调更硬:官方建议至少 4 台机器、共 32 张 GPU,每张显存不低于 96 GB。魔搭社区
家用机只剩一条缝:128GB
真正把门推开的是 AngelSlim,腾讯自家的压缩工具包。它放出了 Hy4 flash 的 GGUF 量化版,Q4、Q3、IQ2 都有,配套部署方案目前只给一档:128GB 设备。128GB 统一内存的 Mac,或者 DGX Spark,就这两种。魔搭社区哔哩哔哩
B站有 UP 主引官方数据:Mac M5 Max 上 4K 上下文约 48 tokens/s,拉到 32K 还有 44。这数暂时只有这一路来源,他自己也说后续要拿 M3 Ultra 512GB 再实测一遍,先等等。哔哩哔哩
还有一句得看清:那份 GGUF,官方注明是“用于端到端测试”。测试和日常主力,是两回事。知乎
比“激活12B”值钱的,是 KV cache 砍到 1/24
本地跑长上下文,卡死你的从来不是权重,是 KV cache——每层都要给每个 token 存一份 K 和 V,上下文一长,它比模型还吃内存。
Hy4 flash 这刀砍得狠:42 层里 30 层只维护固定大小的滑动窗口,只有少数稀疏层保留整个历史,再用 IndexPool 把查找历史 token 的索引器也压掉。官方口径,KV cache 只有 Hy4 的 1/6、Hy3 的 1/24。这一条直接决定你那台机器能不能开着长上下文活下来,比参数表实在得多。知乎知乎知乎
那 63.5B 哈希表,是明年的事
规格表里有个耐人寻味的拆分:骨干 155.5B,Engram 63.5B。将近三成参数是一张 N-gram 哈希表,不参与矩阵乘,查表取出。知乎
理论上这部分完全能扔去更慢更便宜的存储,SSD、CXL 内存池都有人在研究,但官方现在的 vLLM / SGLang 方案还是整模型上 8 卡。所以它是个信号——门槛以后可能降,今天还不能拿它当省内存的理由。知乎
它到底能干什么
官方请了 85 位内部用户,在 27 类 259 个日常任务上盲测:Hy4 flash 满意度 2.79/4,Claude Haiku 5.5 是 2.81/4,同场 DeepSeek 以 3.09 分拿到最高。魔搭社区知乎
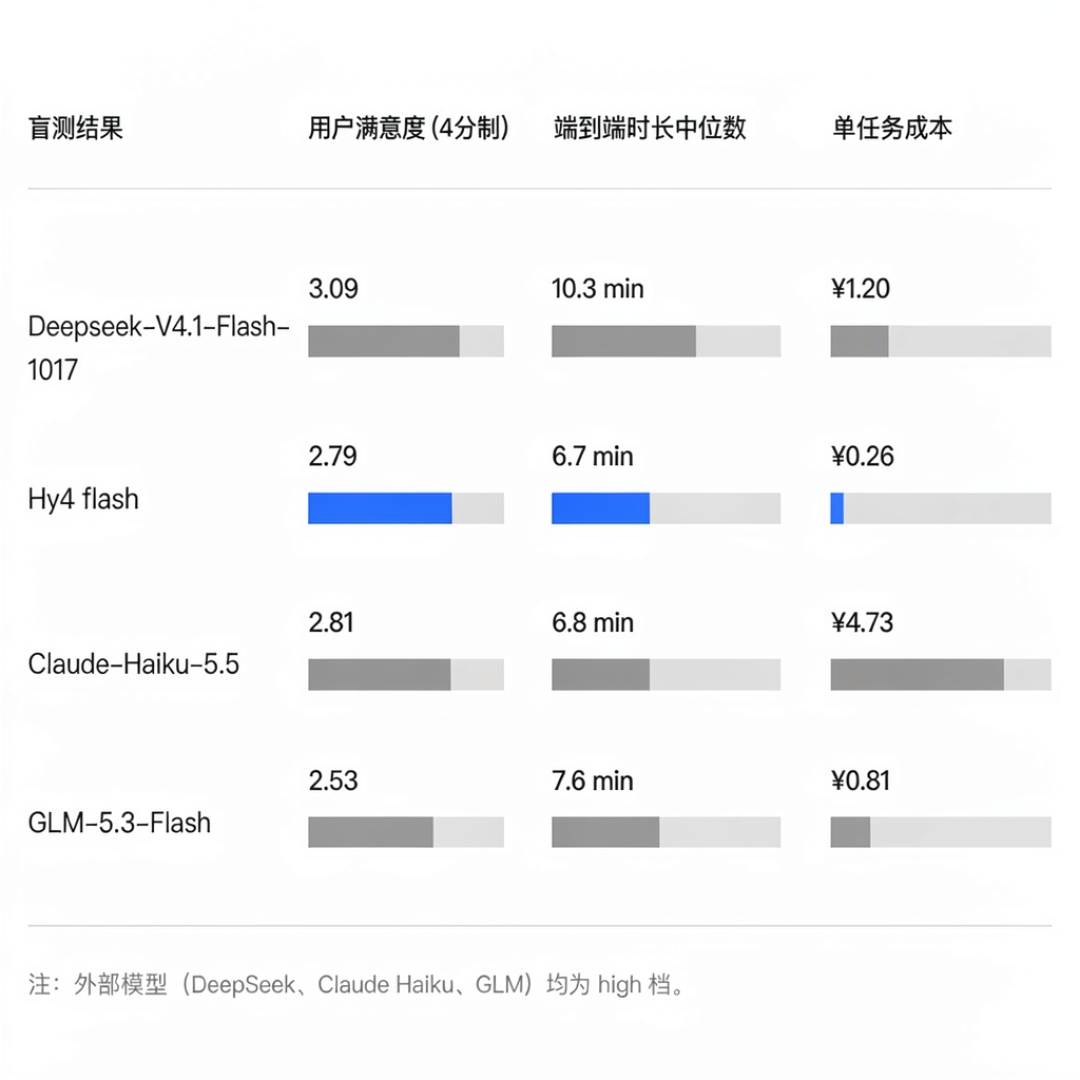
Hy4 flash 赢在时间和钱:完成时间中位数 6.7 分钟,DeepSeek 是 10.3;单任务 0.26 元,DeepSeek 是 1.20。知乎
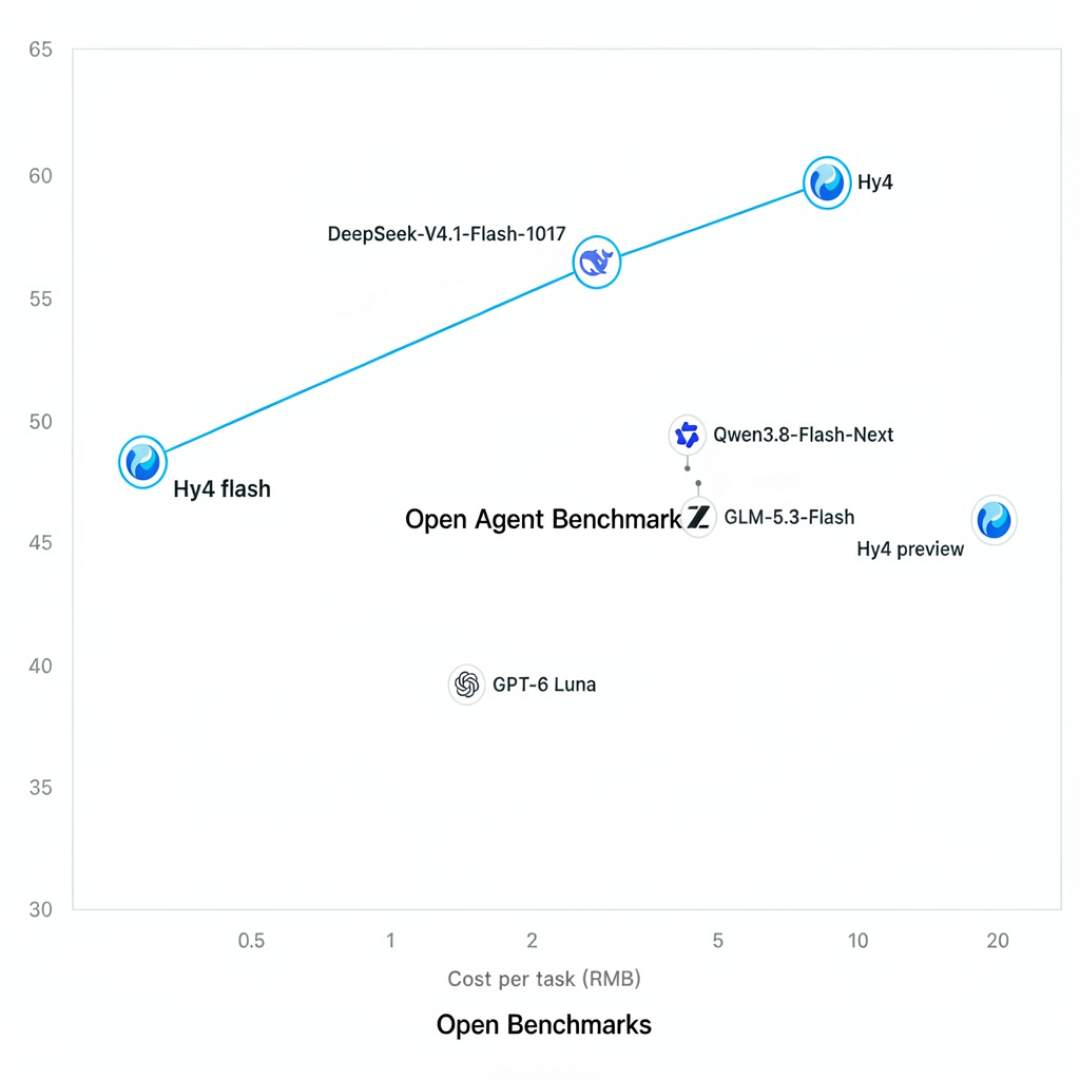
另一处更该记住:Base 版的 SimpleQA 只有 37.5,Hy4 Base 是 57.2,长尾事实差一大截,查表补不回来。微博上已经有人说它“真的不能干重活,省下来的积分要用其它模型用几倍还回来”。知乎微博
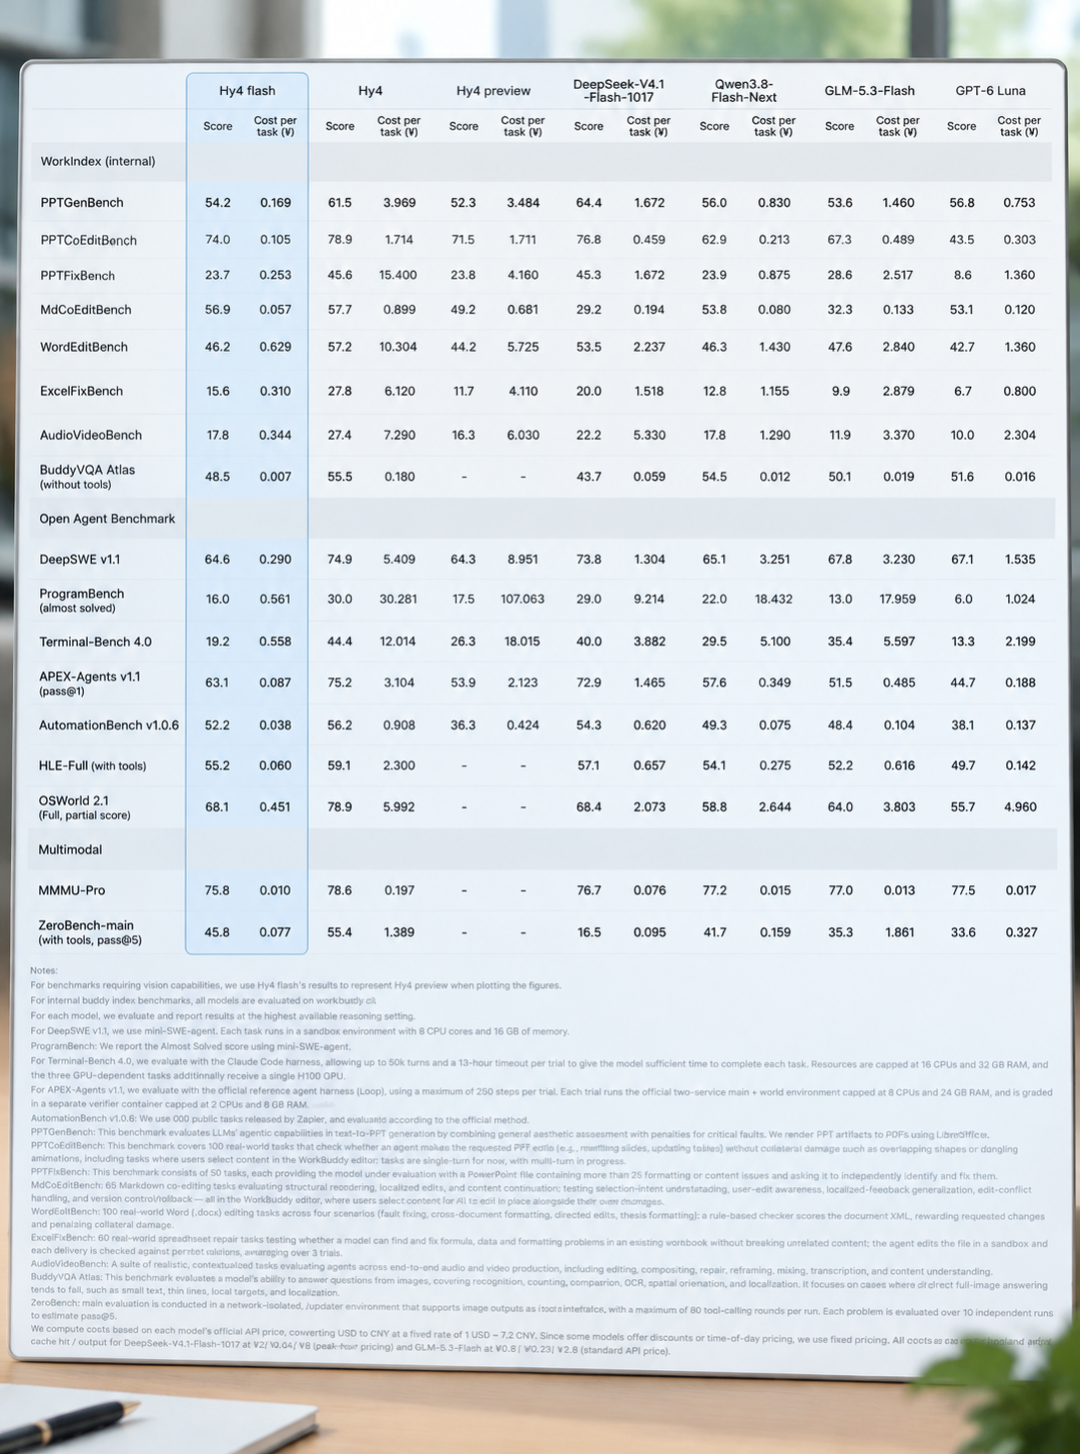
高频、能一眼核对对错的活,它合适。当唯一的大脑,别。
现在该做什么
先别下载。11 月 30 日前 WorkBuddy 限时免费、腾讯云 TokenHub API 限时 5 折。OpenCode 那边也开了两周近乎不限量的免费额度。把自己那批真实的活在线跑一轮,看它接不接得住——这一步不花钱,比任何跑分都准。腾讯混元知乎
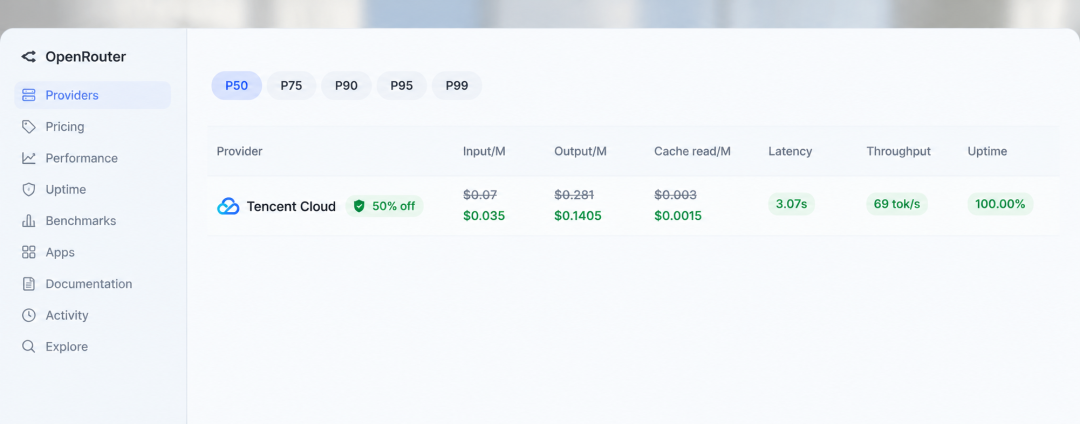
真有 128GB 统一内存的机器,再去 AngelSlim 拿 GGUF,记住“端到端测试”那四个字。只有 24G、32G 显卡的,等社区把 Engram 拆出去的方案,现在下只有硬盘受伤。
最后两个坑:
参数口径官方自己就有几套,模型卡总览 220B、新闻稿 224B,Engram 一处 63.5B、一处 63.4B、官宣 64B,都是原文,别自己加总。知乎
许可证是 Tencent Hy License 1.0,由 Apache 2.0 衍生,但原文明确写了它不是 Apache 2.0,大型 MaaS 业务另有商用条款。知乎


当前文章无评论,是时候发表评论了