本地跑大模型的人最恨的不是模型笨,是跑不动:显存不够、内存爆掉、出字慢得像打字机。专为 Qwen3.8-Flash-Next 这类 MoE 模型打造的开源推理引擎 Strata,10 月 19 日刚放出 0.2.0 测试版,把本地推理的门槛重新按了一遍。
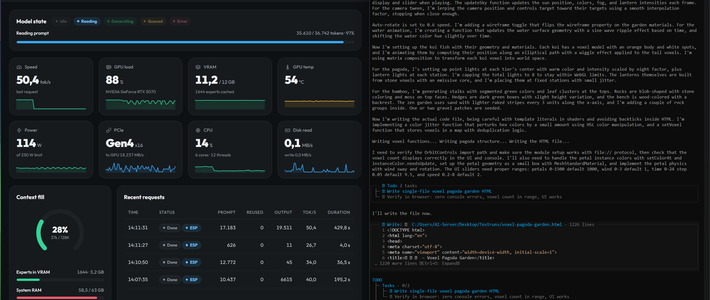
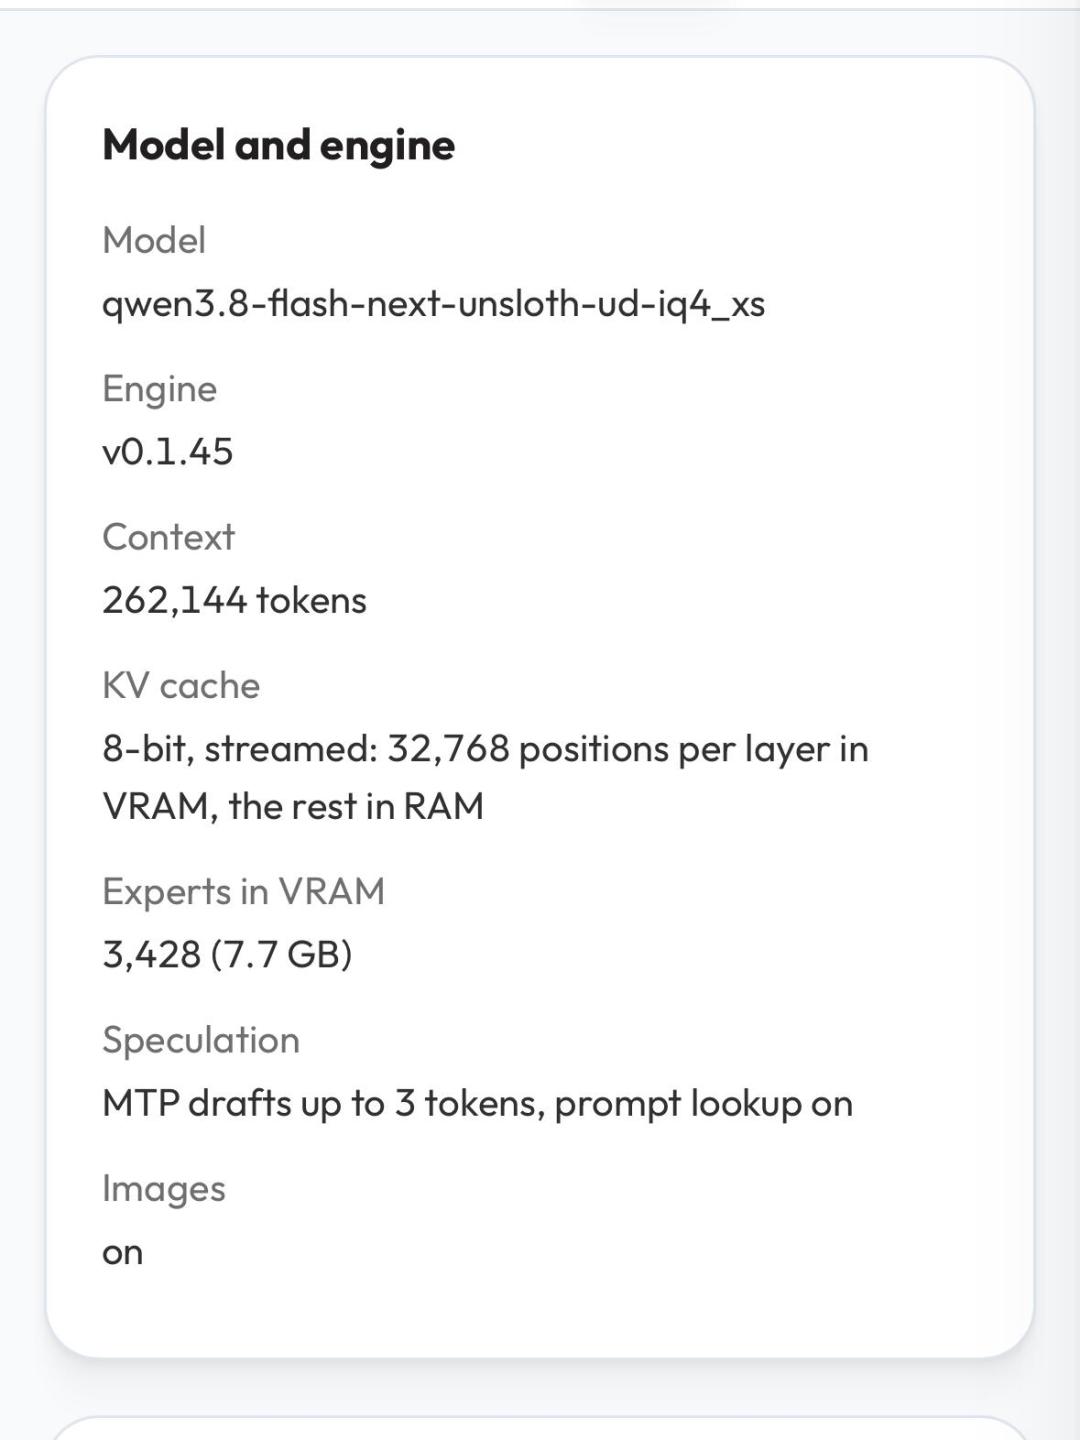
Strata 凭什么快? 一句话:它不把模型全塞进显存。常驻计算部分和热点 experts 放显存,路由 experts 放内存,n-gram embedding 表丢 SSD 靠系统页缓存提前预读。CPU、GPU 一边搬数据一边算,还给 Q2_0 量化专门写了 AVX-512 内核。效果有多直观:tombkeeper 转发的社区实测里,RTX 3090 跑短问答能到 67 tok/s,同硬件的 llama.cpp 只有 20 tok/s。上线不到一个月,GitHub 已经 2.9 万+ Star。微博
更狠的是极限压榨:RTX 3060 笔记本(6G 显存)+ 64G 内存,跑 125B 大模型,B 站"KUN技术志"实测聊天 28–34 tok/s,llama.cpp 约 12;4K 文档首字响应 14–15 秒对 26–28 秒,快出一倍。哔哩哔哩KUN技术志博客
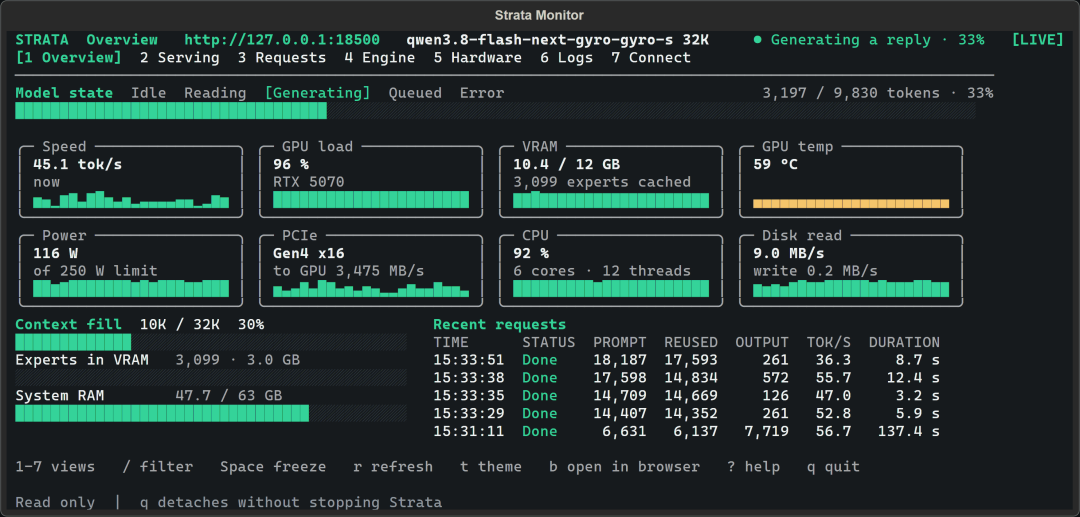
0.2.0 值得装的理由也直白:以前它是命令行极客玩具,现在加了图形界面、中文界面和模型推荐,Windows 一键安装,内存与显存合计最低约 27.6GB 就能上桌。哔哩哔哩GitHub
但动手前,先把坑看清。
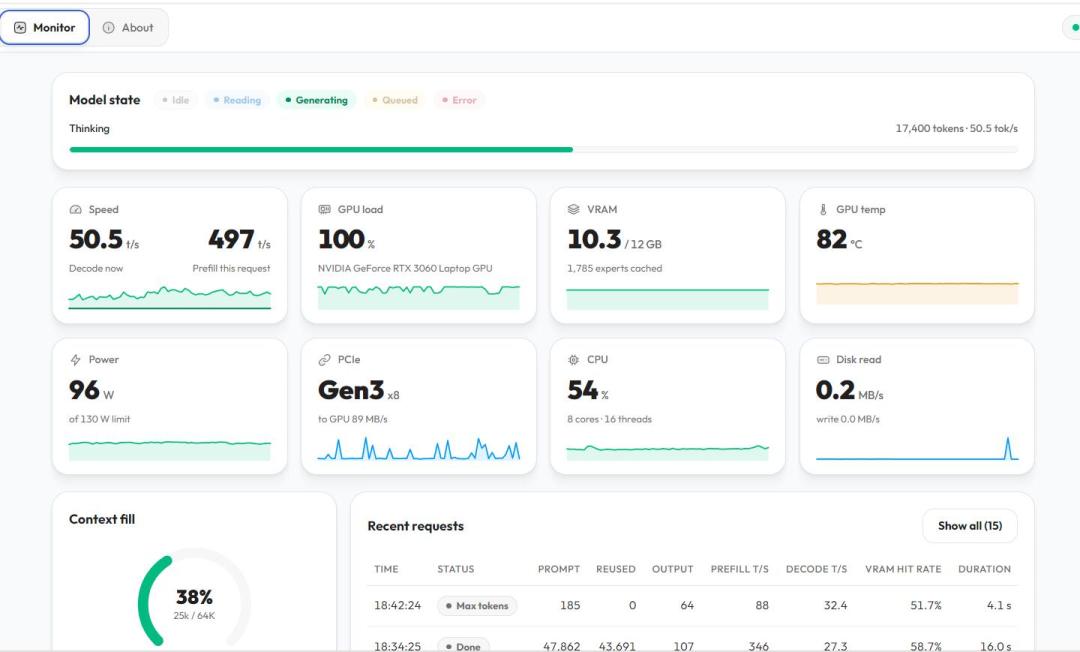
小显存不是开箱即跑:官方起步要求 12G 显存,6G 卡从 0.1.38 起才能启动。实测默认配置差 383MiB 显存起不来,降到 8K 上下文还差 208MiB,最后砍掉草稿层才跑通。同机器 llama.cpp 能开 32K,Strata 只有 8K,长文档党接不住。哔哩哔哩
早期版本有磨合期:首版加载自己下的 GGUF 会报 unrecognized,0.2.1.3 才修好。模型下载巨慢是评论区吐槽重灾区。GitHub哔哩哔哩
质量基本打平但有细节:10 道题两边答案基本一致,但同参数下两个引擎的输出不会逐字相同;低比特模型算数不稳,1234×5678 还错过一位、复测才对。KUN技术志博客
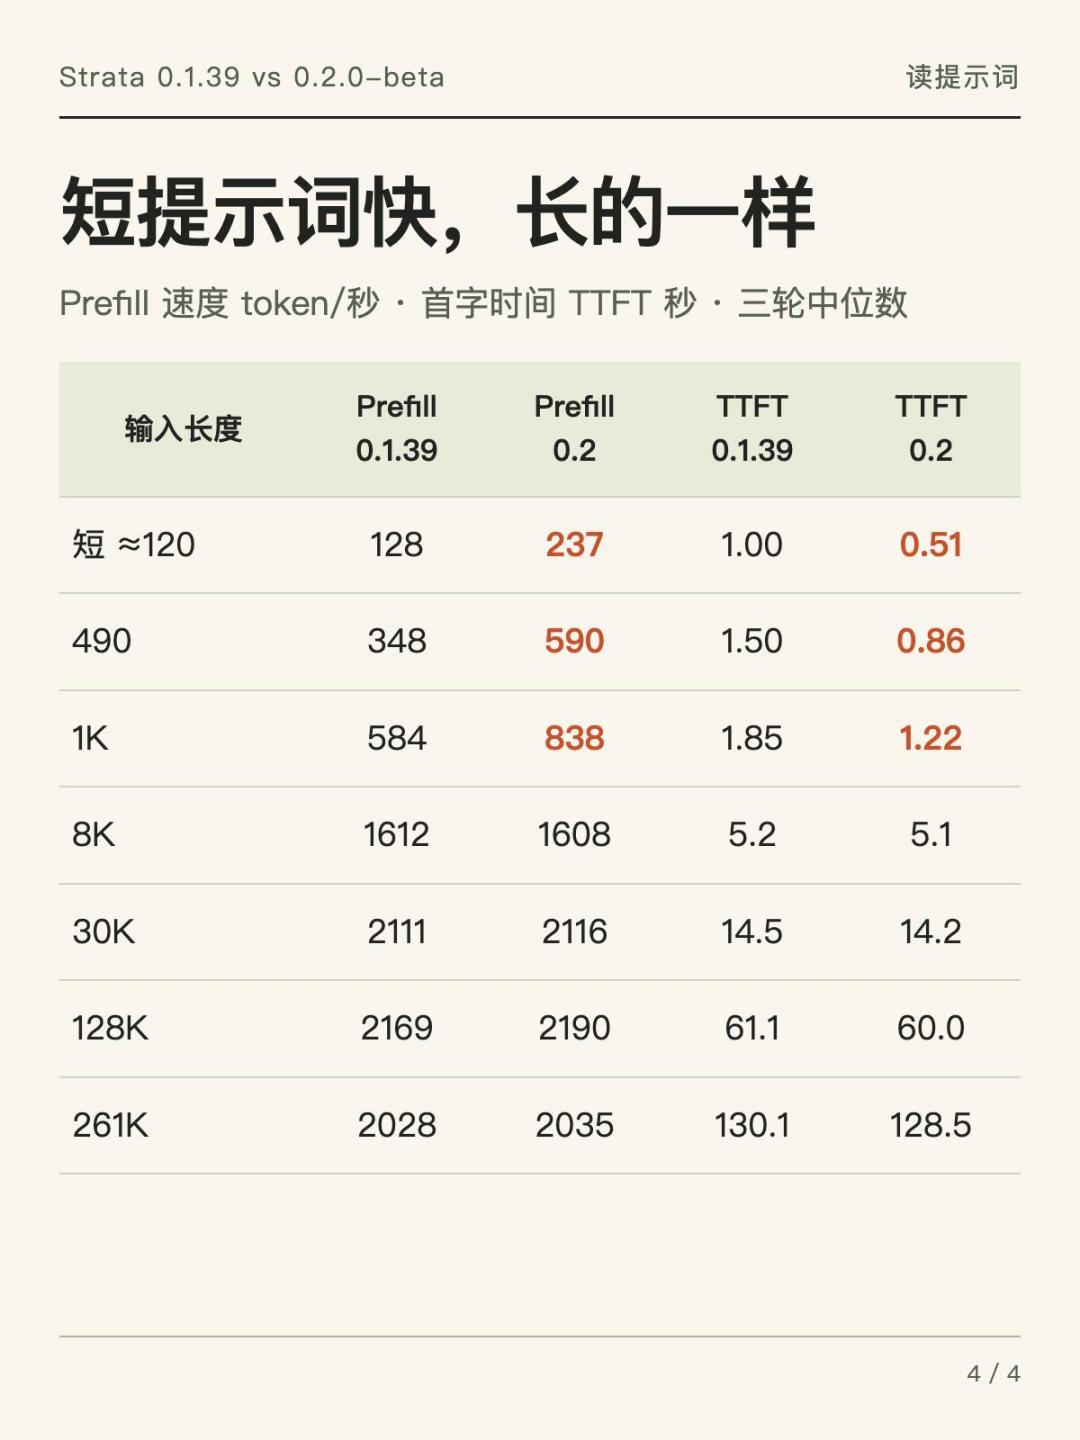
发版节奏也猛:10 月 19 日到 21 日三天连发 0.2.0、0.2.1、0.2.2,每张显卡可设 Main/Helper/Off 三档分工,Intel Arc 和 Mac 的支持也补上了。提速更不是噱头:同一张 12G 5070 上,把 CPU worker 数对齐再对跑 0.2.0-beta 和老版 0.1.39,0.2 仍快 1.56–1.66 倍,7 种输入长度、每组 3 对全是 0.2 赢。GitHub小红书
谁该切,谁再等? 小显存 + 大内存、日常主要是聊天和代码补全的,现在就能装一版试试;靠长文档吃饭的,继续用 llama.cpp,等它把 8K 短板补齐再说。
本地推理的竞争,已经从"能不能跑"卷到了"跑多快"。对不打算花钱换电脑的人来说,这就是实打实的红利。