7月底发布、8月初开源权重的 MiniMax H3,最近把"本地生视频"这把火又点燃了一波:小红书上一条部署教程一周拿到 4400+ 赞、6800+ 收藏。B 站十月底还在冒实测教程。原因简单粗暴——权重开源,本地生成不限量,你付出的成本基本只剩电费。云端按秒计费的视频 API,用久了谁不肉疼?小红书
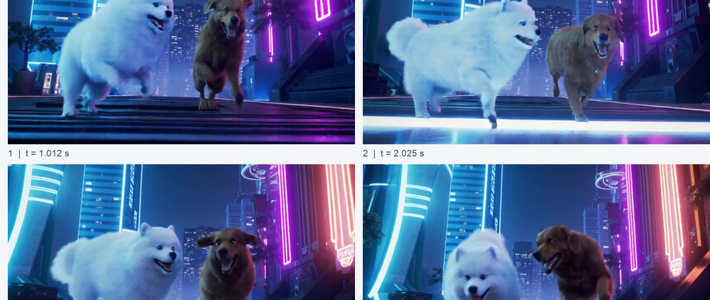
先说清楚 H3 是什么:MiniMax 的多模态音视频生成模型,文生视频、图生视频、首尾帧都能做,输出自带原生音频,官方规格最高 2K、单段最长 15 秒。权重发布当天它就进了 ComfyUI,768P 加原生立体声,在 3060 这类显卡上就能本地跑。社区教程也一路卷向了低显存方向。知乎知乎微博
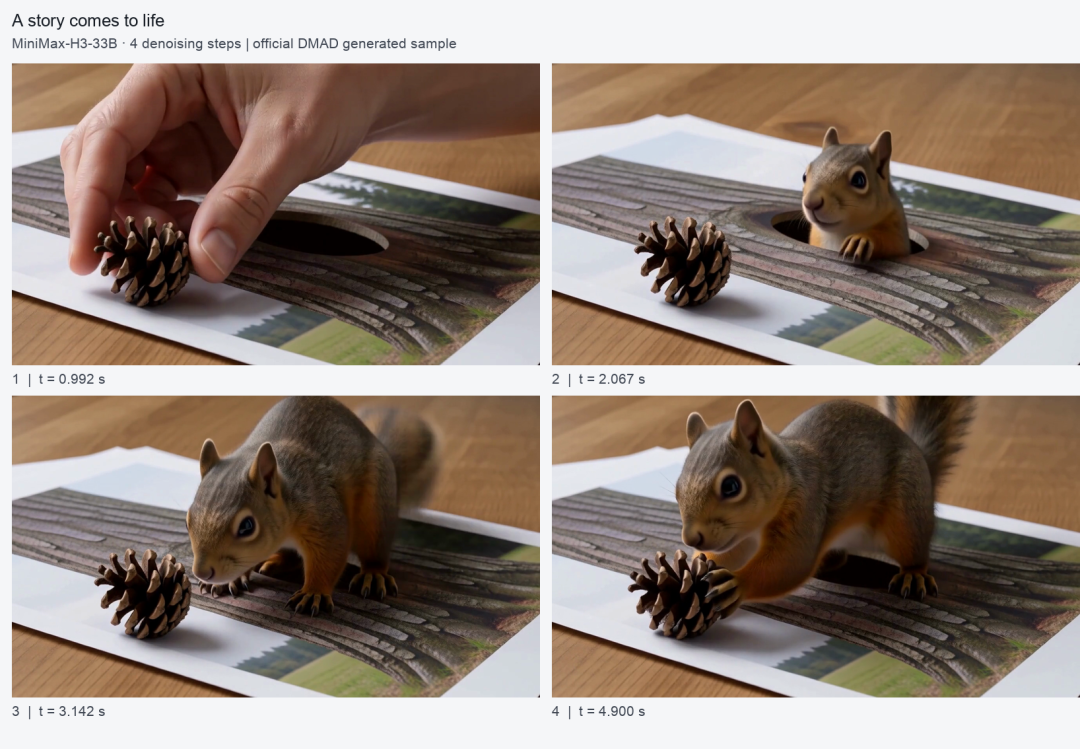
但"能不能搬回家",完全取决于你的显卡档位,我对着几篇实测帖把账拼出来了:
4080S 这一档:跑得最体面。 官方默认工作流全套模型 39.5GB,一条 5 秒、0.4 百万像素的片子,裸跑 149 秒;挂上 8 步加速 LoRA 缩到 71 秒;再叠 ComfyUI 推荐的 SageAttention,50 秒出片。1080P 提升更狠:3186 秒砍到 465 秒,作者原话是质量看不出差距。知乎
16G 显存:能跑,但别急。 5060Ti 16G+32G 内存实测:2K 5 秒要 10 分钟,1K 15 秒要 18 分钟。拉满到 2K 15 秒直接爆显存,属于"挂着机等,摸鱼刚好"的水平。哔哩哔哩
12G 显存:卡你的不是扩散模型。 有博主拿 3060 12G 连崩四次后量了个明白:文本编码器 14.62GB,比 11.68GB 的扩散模型还大——瓶颈在编码器,不在模型本身。官方低显存配方可以抄:扩散模型换 GGUF Q4_K_M(10.64GB)、编码器换 Q2_K(7.91GB)、步数压到 8 步,或者干脆把编码器整个丢内存里跑。知乎
8G 显存:走 DMAD 这条捷径。 10 月中旬开源的 DMAD 把 H3-33B 蒸馏成 4 步学生模型,8GB 消费级显卡给了可用的 1344×768 带立体声工作流。6G?别硬试了,评论区问 1660 的,基本没人接茬。知乎小红书
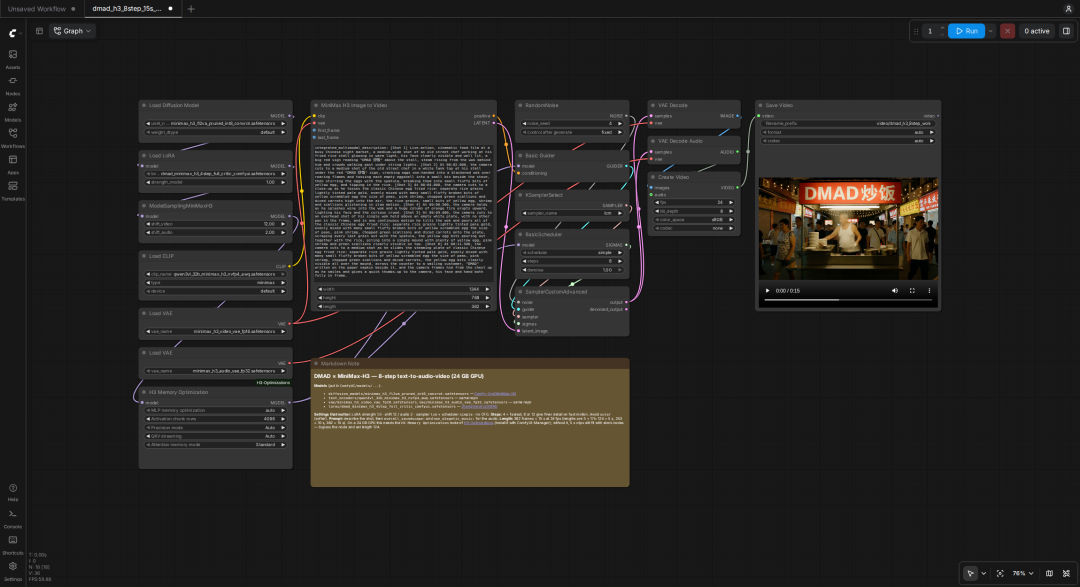
再泼冷水,都是实测帖里踩过的。①别迷信"量化=提速"——int8 版模型比 4bit 大一倍,那是翻倍吃显存;NVFP4 在 30/40 系上是软件模拟,装了是负优化;Sol-Attn 只认 50 系。知乎
②整合包水很深——B 站的"一键包"把功能分成免费和 VIP 服务,VIP 部分还单独出了教程视频。更要注意有人给社区加速节点打包了没有许可证声明的二进制文件,商用有风险。想拿本地生成的片子接商单,H3 需要单独走 Comfy 拿商用授权。③环境是隐形门槛——ComfyUI 太老会踩低显存卸载崩溃的坑,0.38.0 之后才修;模型路径别放中文名,容易爆 C 盘。哔哩哔哩知乎微博知乎
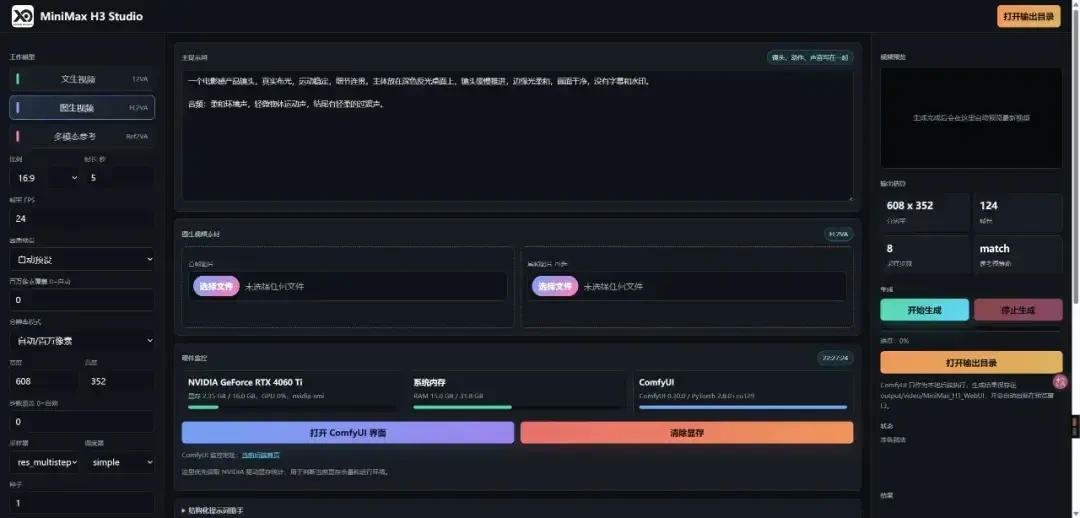
没显卡也别遗憾:AMD 社区做的 ComfyUI 自定义节点,不用下模型、不用配环境,填个免费 key 直连 H3 云端 API 就能出片。从装节点到出片十来分钟搞定。知乎
一句话总结:30 系以上 8G 显存,值得一装;低于这条线,先借云端过过瘾。 省下的 token 钱是真的,5 秒等 10 分钟的电费和时间,也是真的。