8月中旬,B站的一期首发实测视频给零刻SEi14 AI挂上了这样的标题"独立NPU算力卡性能炸裂,CPU内存全解放,仅次AI MAX 395"。同一期的评论区里,有人拿153.6GB/s的内存带宽给27B稠密模型算了另一笔账:“跑27B Q4量化,理论TPS约11.3 token/s,有点慢”。哔哩哔哩哔哩哔哩
两句都是真的,而且说的还是同一类机器。这就是零刻7月底上市的SEi13 AI/SEi14 AI的完整处境:它给小主机接上了继OCuLink显卡坞、统一内存大机之后的第三条AI算力路线,但只接其中一部分活。真正需要现在做判断的,不是"想跑大模型"的人,而是那批预算卡在中段、想在干活机上悄悄挂一个本地AI工位、又不肯掏三万上495的折腾党。下面三本账,一笔一笔对。
先搞清楚这张卡是什么:不是加强版核显NPU,是一颗"外置大脑"
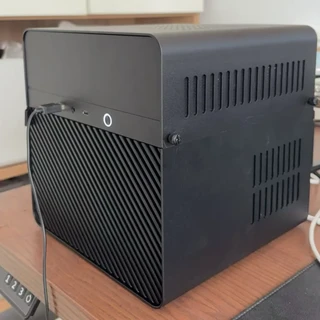
官方口径(零刻7月29日上市公告):x86+独立NPU双计算架构,独立NPU最高160TOPS算力,搭配24GB推理专用内存,兼容Windows/Linux生态。小红书
拆开看,核心是一张M.2接口的存算一体算力卡。首发视频评论区里有做过这张卡开发的工程师,一听到"160TOPS+24G内存"就直接点名这是后摩m50加速卡,顺手报了这个价:“京东上卖8000”。哔哩哔哩
参数层面,评论区多路口径互相印证:192bit位宽、约153.6GB/s带宽、单芯片最大48GB内存、存算一体架构。它和"CPU里集成的NPU"是两码事,和"统一内存大机"也是两码事。算力卡解决的核心问题是算、算分离:通用计算归CPU,模型推理归NPU,两边不抢资源——这也是它和395/495那类统一内存机器最大的架构差异。哔哩哔哩
知乎的首发实测给了很干净的证据:哪怕NPU长时间满载,这台i7-13620H机器的CPU占用依旧能维持在很低的水平,浏览网页、看视频、办公照常,不需要像统一内存方案那样"一跑模型整机陪着等资源"。知乎
对照着看更清楚:9月29日另一期零刻SER9新U开箱的结论,是给集成NPU泼冷水的——“NPU部署本地模型不是它的主业,配合各种软件功能实现本地AI协作才是正途”。集成NPU继续干它的后台调度,而独立算力卡把"持续推理"这一整块从主系统里搬了出去。哔哩哔哩
第一本账:速度——23t/s和6t/s,是同一类机器
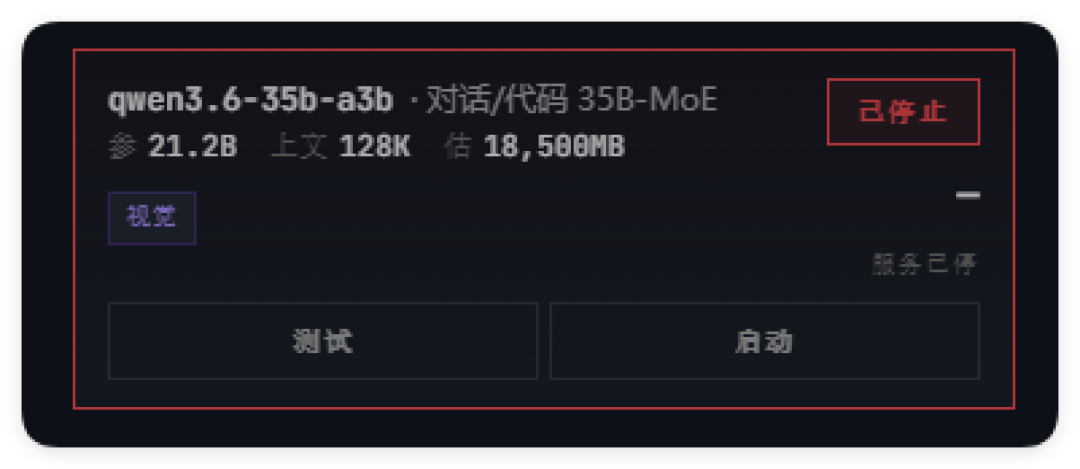
先放量产机实测(知乎作者单人样本、非双盲,结论边界先说清)。官方宣称"本地跑9b稠密、35b MoE架构,输出23 tok/s往上",这台被实测的SEi13 AI是i7-13620H、32GB内存加24G NPU的组合。具体跑起来:知乎
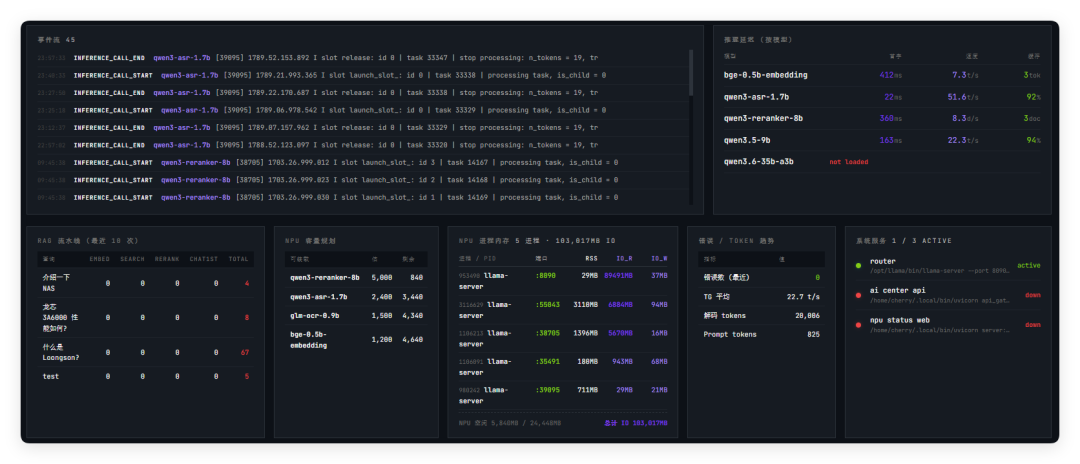
qwen3.5-9B(128K上下文)常驻,实测平均TG 22.7 tok/s;更大的qwen3.6-35B-A3B(MoE)塞得进24GB体量,输出比9B还快;
现场用Agent写一个贪吃蛇小游戏的编码任务:首字TTFT延迟154.92ms,生成TG 16.46 toks/s,全程4分21秒,产物无BUG。知乎

再放另一派的声音。SEi14首发视频评论区有人按带宽推理论值:27B稠密Q4量化在这台机器上"最多就是6t/s,约等于没用"。哔哩哔哩
还有一个更扎心的结构性问题:160TOPS是decode侧的话术担当,但宣传逻辑里该漂亮的prefill表现,首发实测就没拿出来。两种说法都成立,原因不神秘:MoE小激活量吃带宽少,稠密大模型吃带宽,153.6GB/s就是这张卡的速度天花板。所以速度这页的答案很具体:你要跑9B级稠密或者35B-A3B这类MoE当日常工位,够用;要27B+稠密当生产力,或者coding agent等不了十几秒一个回答——"可玩和可当生产力是两码事"这句评论区原话,目前没人反驳得了。哔哩哔哩
第二本账:钱——卡占整机大头,买法决定它贵不贵
首发上手口径:整机售价约1.2万,其中这张M.2算力卡占了一多半。八成预算为一张卡打工,这是劝退火力最集中的地方,也是他们给出替代方案的由头:哔哩哔哩
两千元一张2080Ti 22G改卡。评论区判断得很直接:这是低功耗边缘计算的推理小卡,优点是功耗极低,纯算力比不过两千元改卡——前提是你接受机箱、电源、噪音和改卡的稳定性风险。哔哩哔哩
“一万出头不如买64G的395”。统一内存带宽高一个量级,速度天花板完全不同;再往上,同门大哥GTR9 Pro 495旗舰版直接报到128GB内存+2TB硬盘、首发29998元。去年395发布时,一万露头的售价还嫌贵;今年AI涨价潮之下,那个首发价反倒成了历史低价——同一个涨价周期,把三条路线的价格全搅了一遍。哔哩哔哩小红书
“这钱拿去充API能用好多年”——今年被反复抬出来的第三张反对票。
但这笔账有个2026年特有的反向变量:内存涨价潮。9月底,"自带16G DDR5内存的迷你主机,内存贵过整机"已经在专栏里成了标题——SSD、内存涨疯之后,"板载配置"第一次从减分项变成加分项。SEi13 AI的32GB系统内存+24GB推理内存+1TB固态全部内置,你没法按老攻略"买准系统自插低价条子"去薅羊毛,但也天然躲开了DIMM市场这轮疯涨——对冲涨价这件事,今年第一次是"焊死党"占便宜。知乎
还有一条被忽略的买法:这张卡是标准M.2接口。评论区已有人提出"单独买一张插到自己PC的闲置M2位上,理论上也能用"——单卡7999起,整机多出来的是体积、功耗和预装系统。如果你手头正好有台M.2位富余的机器,这是评估它值不值的另一条路径(单卡能否脱离零刻整机完整落地,官方未单独说明,先当线索不当结论)。
第三本账:生态——趟水的坑和到手的工位
先说坑。老问题还是那句:“行业迭代这么快,新模型得靠厂家一个个适配”。Windows这边限制不少——官方口径是双生态兼容,评论区向厂家确认的结果是Windows支持、要用LLaMA for Win版,但"最新版都是for Ubuntu的",LLM Studio这类工具目前不支持。有人拿树莓派、Radxa、某华为NPU加速卡的老生态经历对照,担心"厂商定制生态"重演。哔哩哔哩

但到手即用这半面,确实做得少见:Ubuntu 24预装llama.cpp,默认qwen3.5-9B(带mmproj支持视觉);官方模型库直接内置100个模型,涵盖LLM、Whisper、OCR、嵌入、重排序、ASR。实测作者甚至直接搭了多模型Router给局域网内Agent供API,虽然M50多模型动态切换仍有稳定性问题。知乎
海外路线也是同样的定位。Edward Donner的SEi14 AI实测:Ubuntu主机+NPU跑大模型+编码代理任务,与M1 Mac做速度对比,测的是"工位"不是"旗舰"。小天fotos那期测评给过一句公允的定性。把它叫"AI PC"容易有误解,但端侧AI确实有大把机会和场景——前提是你承认它的场景是"低功耗、长期、单一数据流",而不是"高速对话"。哔哩哔哩哔哩哔哩
三类人对上号,三类人先别动
可以考虑的:
"干活机+AI"双任务党:需要7×24挂着embedding、ASR、定时摘要、旁路预处理,本机照常办公不卡——算算分离就是为这个设计的;
部署苦手:不想装环境配驱动,接受出厂预装的模型库和Agent应用,开箱用;
已有M.2空位、只想单卡试水端侧推理的折腾党(驱动限制先自查)。
先别动的:
要27B+稠密当生产力的。双芯版M50已经在评论区被扒出参数:带宽能到307G、320T INT8,但"价格能上一个4090"。哔哩哔哩
追新模型的:llama.cpp的支持还没进主线,后续新模型得靠NPU厂家一点点适配,首发的100模型库既是护城河也是围墙。新模型能不能及时吃到你说了不算;哔哩哔哩
桌面有位置、愿意折腾改卡或显卡坞的:2000元级22G显存的纯算力性价比,正面打不过。
接下来盯四个信号
双11价格战里这台"卡占大头"的机器有没有松动、M50单卡(当前口径7999-8000元)是否降价——它的定价锚是卡,不是零刻整机;
Windows侧驱动与模型库的更新频率:"最新版for Ubuntu"维持多久,决定"双生态兼容"是真承诺还是话术;
Router多模型切换的稳定性修复进度,和9B/35B-A3B之外的新模型进入官方库的速度;
第二个、第三个存算一体供应商跟进"主机内置算力卡"形态——同行进场,才说明这条第三路线真立住了。
一句话收口:零刻这台机器没有推翻"6t/s"的质疑,也没有兑现"性能炸裂"的标题——它的真实位置,是在显卡坞和3万档统一内存大机之间,给9B/35B-A3B这一档端侧模型补了一个低功耗、不打扰主机的常驻工位。你的模型和任务对得上这个工位,它就不是智商税;对不上,评论区替你省下的钱是真的。