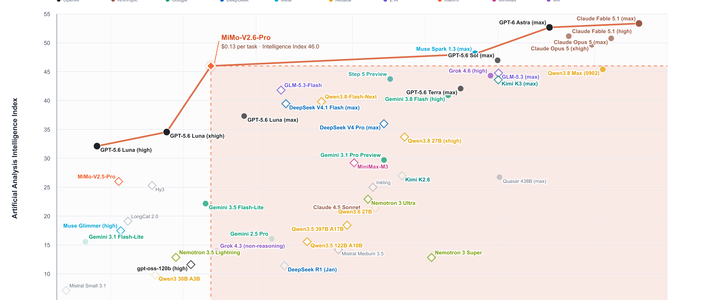
9月22日凌晨,小米正式发布并开源MiMo-V2.6系列:Pro和Flash原生全模态,MIT许可证、无需申请。发布当天,Pro就在ArtificialAnalysis的评测口径里被标为开源模型得分第一,群里开始刷屏"国产开源新王",B站的实测视频已经把它拿去和闭源顶流对打。哔哩哔哩微博
但如果你是那种跟着Qwen3.8-27B把显存账算了一个月、刚把27B跑起来的人,你可能已经发现一个不对劲的地方:权重放出三天了,本地部署的截图几乎没出现。
不是没人动手。是这把榜一交椅,压根没给你的机箱留位置。
先盘清楚:这次到底开源了什么
9月21日至22日,小米放出三个模型仓库外加一批训练物料:
MiMo-V2.6-Pro:总参数约1.02T的稀疏MoE,每token激活约42B,原生全模态(文本、图像、视频、音频),1M上下文;
MiMo-V2.6-Flash:总参数309B、激活15B,同为全模态+1M上下文,官方定位"速度兼顾成本"。哔哩哔哩
MiMo-V2.6-Distill-Qwen-9B:9B蒸馏小模型——全系里唯一落在消费级硬件区间的;
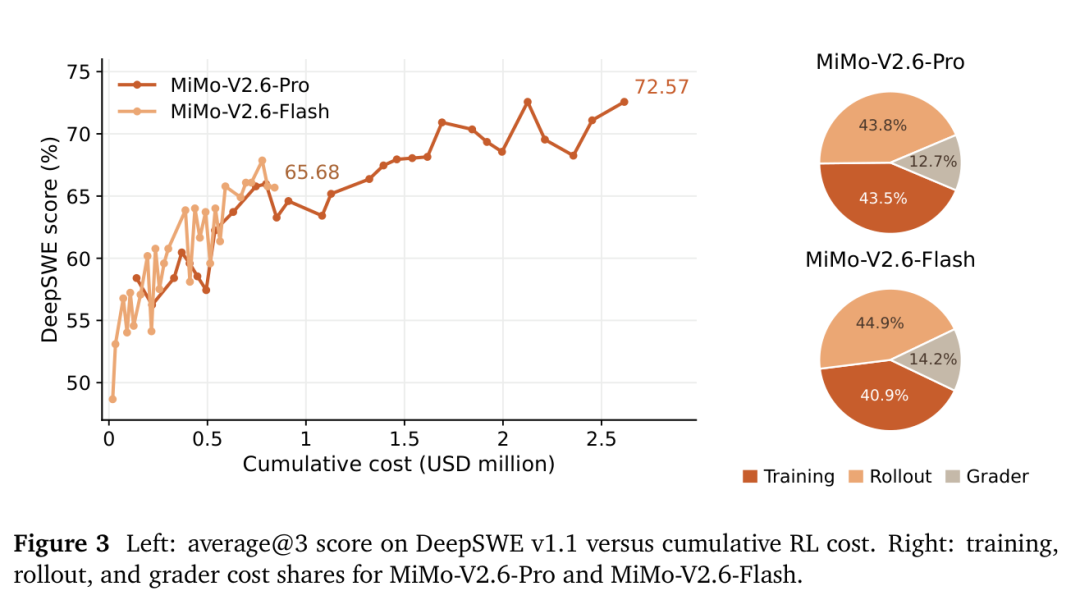
附赠物料:7000多个RL任务环境、训练用的端到端强化学习框架、技术报告。负责人罗福莉的说法是"开源模型迄今最大规模的单次RL训练":一次参数更新,要让模型在真实环境里完成约2.5万次长程任务。公开直播的数据显示,Pro的RL训练烧了约260万美元,Flash约90万,这场直播当时还被质疑是"真实训练还是过程回放"。知乎
全部MIT,可商用,权重直接下。看起来是本地党盛宴——直到你看参数这一列。
「激活15B」是这周最容易看错的数字
三天里我看到群里新手问得最多的一句话是:“Flash总共309B但激活15B,那不就是跑个15B吗?我16G的卡应该够吧?”
不够。MoE的激活参数决定的是每个token的计算量,不是权重占多大地方。309B个参数、整个专家池,必须全部驻留在显存或统一内存里,推理只是每个token"路过"其中15B。跑它就像开图书馆:一万本书全得摆在架上,你每天只翻几本——但书架不能摆在别人家。
按Q4级量化每参数约0.55~0.6字节粗算权重体积(不含KV cache,估算口径,非官方数据):
模型 | 总参数 | Q4权重大约需要 | 典型本地机位判定 |
|---|---|---|---|
Pro | 1.02T | 约560~620GB | 服务器集群的事,单机想都别想 |
Flash | 309B | 约170~190GB | 128GB统一内存的Mac都放不下,48G显存以下无望 |
Distill-Qwen-9B | 9B | 约5~5.5GB | 12G显存从容,FP8约9~10GB |
翻译成人话:你为Qwen3.8-27B配的那台16G/24G/32G机器,面对这代"榜一",全员出局。全系今天能进你机箱的,只有那颗9B。
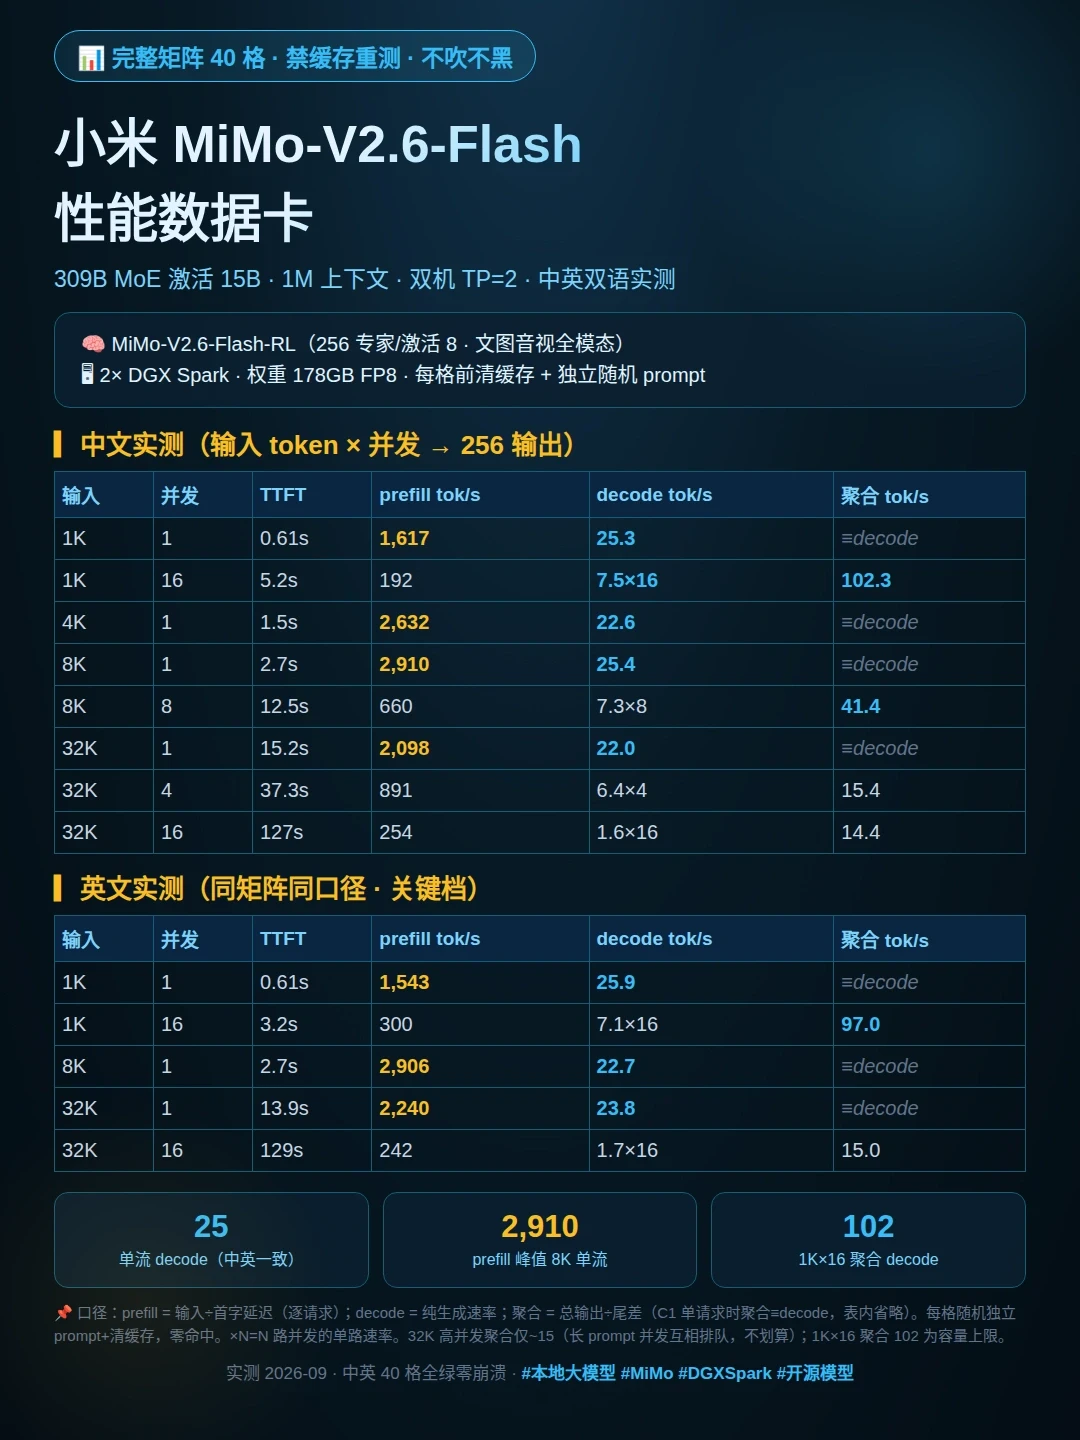
别忘了还有第二张账单:KV cache。官方标的1M上下文是理论上限,长上下文实际吃掉的缓存,以9B在12G卡上跑中等上下文的余量来看,量级就不用惦记了。
那颗9B:跑它,也要跟它对
这里有个微妙的点。这颗9B不是"MiMo自己造的9B"——社区高赞拆解的说法是:它等于把MiMo-V2.6的能力蒸馏进了Qwen3.5-9B的底座,蒸馏后又做了一轮RL,同尺寸对比下生成网页的设计与布局能力有明显改善。知乎
所以它是两个决策:
跟谁比?对手不是榜单上那个1.02T,而是你硬盘里现有的Qwen3.5-9B/14B档模型。如果你的9B平时在干抽取、改写、补全这类日常活,这个"嫁接版"值得换下来实测一次——同样的显存预算,白捡一截后训练红利,这才是这波事件里本地党唯一的实际收益。
它的上限在哪?它是抄作业的学生,不是出题人。技术报告阅读笔记的确认:9B的SFT蒸馏数据并未开源,只有那7000多个RL环境经mimoagent适配器和内置grader交付。Pro/Flash的原生全模态,这颗9B底座未必吃得下;复杂agent长程任务也别指望它复现Flash的水位。知乎
顺带一个可以验证的事实:截至9月24日上午,B站搜"MiMo 量化 GGUF"结果是零。上一代V2.5在5月被玩家塞进128GB统一内存机时,踩过的坑就是"GGUF版本有问题"。你已经习惯"开源周、Q4、单卡27B"这种无缝衔接的节奏,MiMo的第一波可用量化注定慢——因为309B/1.02T这两档,压根没有消费级需求去催生量化。
API那边:价格是真香,慢也是真慢
如果你是"本地党"里那部分诚实承认自己日常走API的人,这次的价格确实激进:Pro官方定价,缓存命中输入0.025元/百万token、缓存未命中3元、输出6元/百万token。Flash档更低,发布当天微博圈子里的通用说法就是"综合价格比DeepSeek V4.1 Flash还便宜"。微博微博
但同一个晒定价的博主实测完只有一句话:慢是真的慢,一个PPT足足做了他37分钟,最终效果倒是还不错。微博
官方给"慢"留了后手:MiMo-V2.6-Pro-UltraSpeed,官方预告逐步开放、同等智力水平下输出速度提高20倍——注意措辞是"将逐步开放",截至发稿还没放出来。所以想马上把工作流整体迁到Flash省钱的人,建议再等一周:等UltraSpeed开放、被全网实测过"20倍"到底剩几倍,再决定。等不到,那"便宜但慢"对交互式工作负载来说,这账算不平。知乎
榜单那边:该信几分
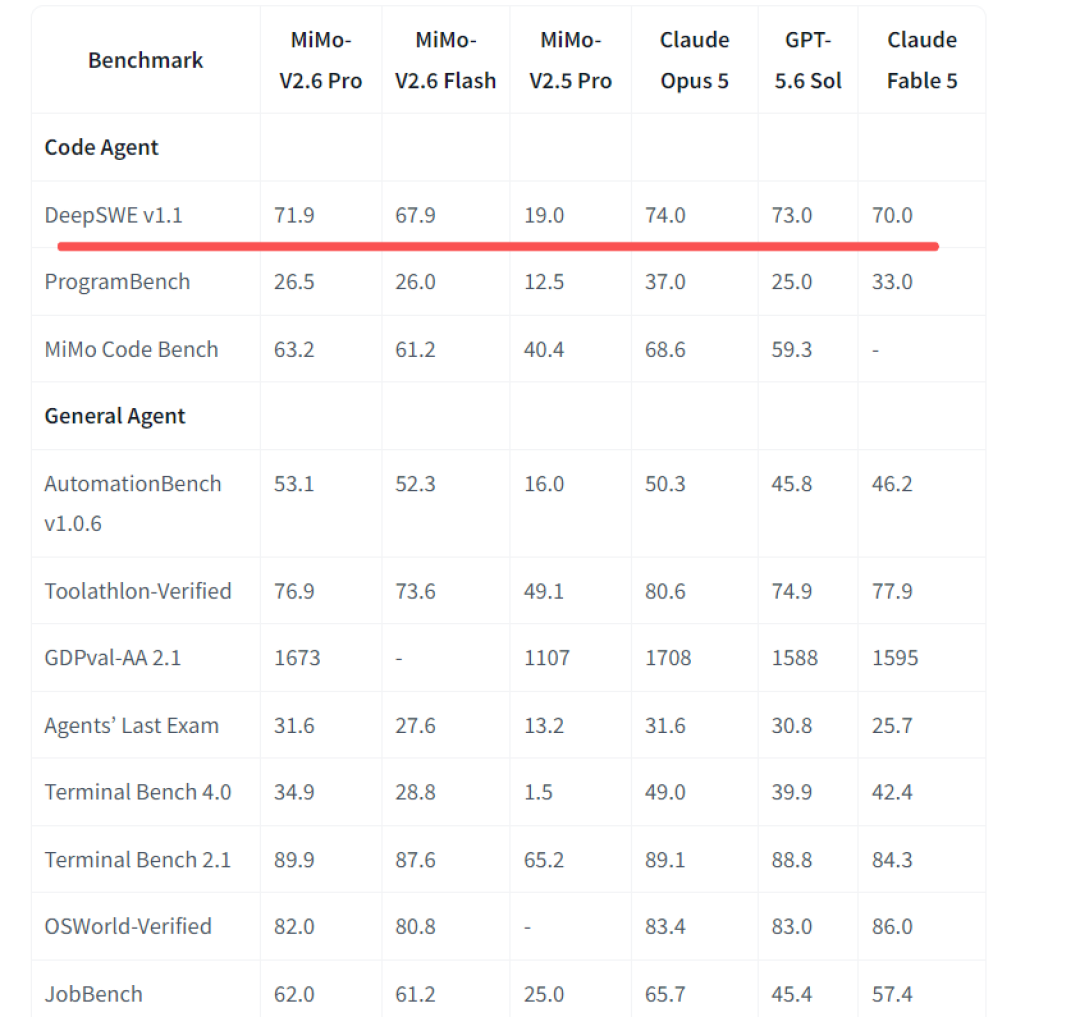
AA开源榜第一、技术报告拆解里DeepSWE 72.6——分数是真的。但要读准限定词:“登顶"说的是开源子集,在含闭源的综合指数口径里,它前面仍有更高分的旗舰。社区的记忆也是真的:上一代V2.5 Pro"实际干活时翻车的惨状”,正是同话题高赞回答的原话。一个102赞的回答,连未来几周nao榜的嘴仗台词都提前写好了。哔哩哔哩知乎知乎
“mimo我用着挺好啊”“mimo跑分真没那么低”“mimo够用就行这性价比要什么自行车”“我用mimo修掉了claude都解决不了的bug”
一个值得记住的中间判断,来自同话题86赞回答:“在它的价位上很强,甚至可能是最强”,但离GLM、DeepSeek、Kimi这三剑客尚有距离,跟Qwen坐一桌问题不大。榜单第一和"能替换你的主力"是两件事。现阶段把它当"开源新选项",别当"必换迁移"。知乎
决策卡:谁装、谁等、谁直接看戏
现在就可以装:主力机型是12G显存以下、日常用9B~14B档打杂的。装Distill-Qwen-9B,跟你硬盘里那颗Qwen3.5-9B跑同一组任务对拍,十分钟出结论。这是全系唯一真实可跑的包,错过它这事件跟你无关。
建议等:想本地跑Flash这个级别的人。等两样东西:一是小米或社区会不会放出30B级的中间蒸馏(参考Qwen3.8把27B做成人人可跑的密度,目前MiMo没有这个动作);二是第三方量化能不能过质量关。千万别提前加卡——170GB级的权重墙不是"再插一张24G"能解决的,为它买硬件等于为幻觉充值。
直接用API:今天就要这能力、预算敏感但对延迟不敏感(批量任务、夜间跑数据)。0.025/3/6的价格就是为这类负载设计的;交互式负载,等UltraSpeed。
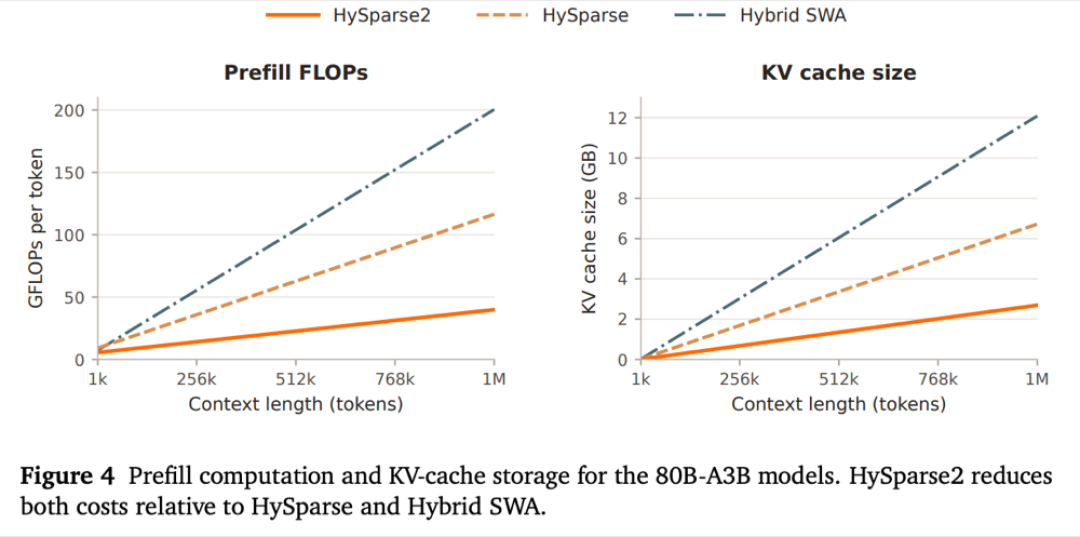
纯看戏:还在"要不要为本地大模型加卡装机"里纠结的观望党。这波事件其实是块有用的路牌:它把"旗舰开源≠旗舰可跑"又往下锤了一格。真正会改变本地党硬件门槛的信号,我认为不在9月22日的权重,而在9月23日深夜罗福莉放出的下一代架构论文HySparse2:100万Token上下文下,预填充计算量相比MiMo-V2.6所用架构降至约1/5,KV Cache占用降至约1/4.5。当注意力架构开始按这个力度砍缓存,"32G机器能跑的上下文"会再翻一档——那才是本地党真正值得盯住的发布周期。知乎
一句话收束:MiMo-V2.6的榜一属于跑分,260万美元属于训练,你的机箱此刻只配领走那颗5GB的9B嫁接版。但别急着划走——这颗9B,值得你今晚花十分钟,跟硬盘里那位老伙计对个拍。