

用AI写码,你一定经历过这种时刻:明明只让它加一个小功能,它悄悄把半个项目都重写了。
11月20日,小红书上一篇《Codex七宗罪》,七条吐槽直球罗列,两天拿下815赞、103条评论。评论区大量共鸣,还有人把矛头从Codex扩展到GPT——它会在你没注意的地方偷偷收紧要求和口径,把大刀阔斧的整改变成屎上雕花的极致走钢丝。严格说这不是Codex的罪,是Coding Agent的共同面相——知乎"为什么刚开始觉得AI编程很厉害,用久了就不行了"的高赞回答,八个字总结体感:抛不开、回不去、不够好、凑合过。也有人自述,Codex的兴奋感差不多只有一到两个月,然后迅速摧毁工作流体感。小红书知乎知乎
七宗罪,逐个拆:
第一宗:自行假设,不告诉你。等发现时已经大事不妙。拆法:在CLAUDE.md或提示词里写死一条——“动手前先列出所有假设,等确认”。知乎"Codex为什么突然胡言乱语"问题下,有人被逼出更笨但更稳的办法:每一次使用,都要在提示词里把约束显性写清楚。这么用久了,bug的形态会从"写错了"变成"藏得深"——改起来两行,找起来三小时。小红书知乎知乎
第二宗:烧额度,活没干完就戛然而止。至今没人说得清额度有没有缩水。别让它一口吞下整个需求,一次只交一个功能、小步跑,随时能停。小红书
第三宗:两行能写完,它上一整支代码部队。不考虑合理性就给你搬上来。xAI的Lauren Tan上个月一个人提交3000次代码、团队被撤回的只有约0.5%,她治这条的规矩是:别往文档里堆话,把每一次纠正变成机器检查。小红书小红书
第四宗:没有架构概念,文件和层次一片混乱。代码和文件层次混乱。代码库是AI最大的学习材料,里面有什么写法它就照抄什么,所以在Lauren Tan的"信任金字塔"里,代码库被排在最底层:AI照着现有代码学,底子干净才不写歪。地基不干净,自动化只会产出更多烂代码。小红书小红书
第五宗:临时产物堆满目录。代码目录下的文件异常臃肿。Claude Code团队把清理测试和规则文件当例行维护:删掉过时冗余的条目,只保留值得继续运行的检查——这些东西不管只会越长越长。文档一臃肿,模型反而更容易漏掉关键约束。小红书知乎
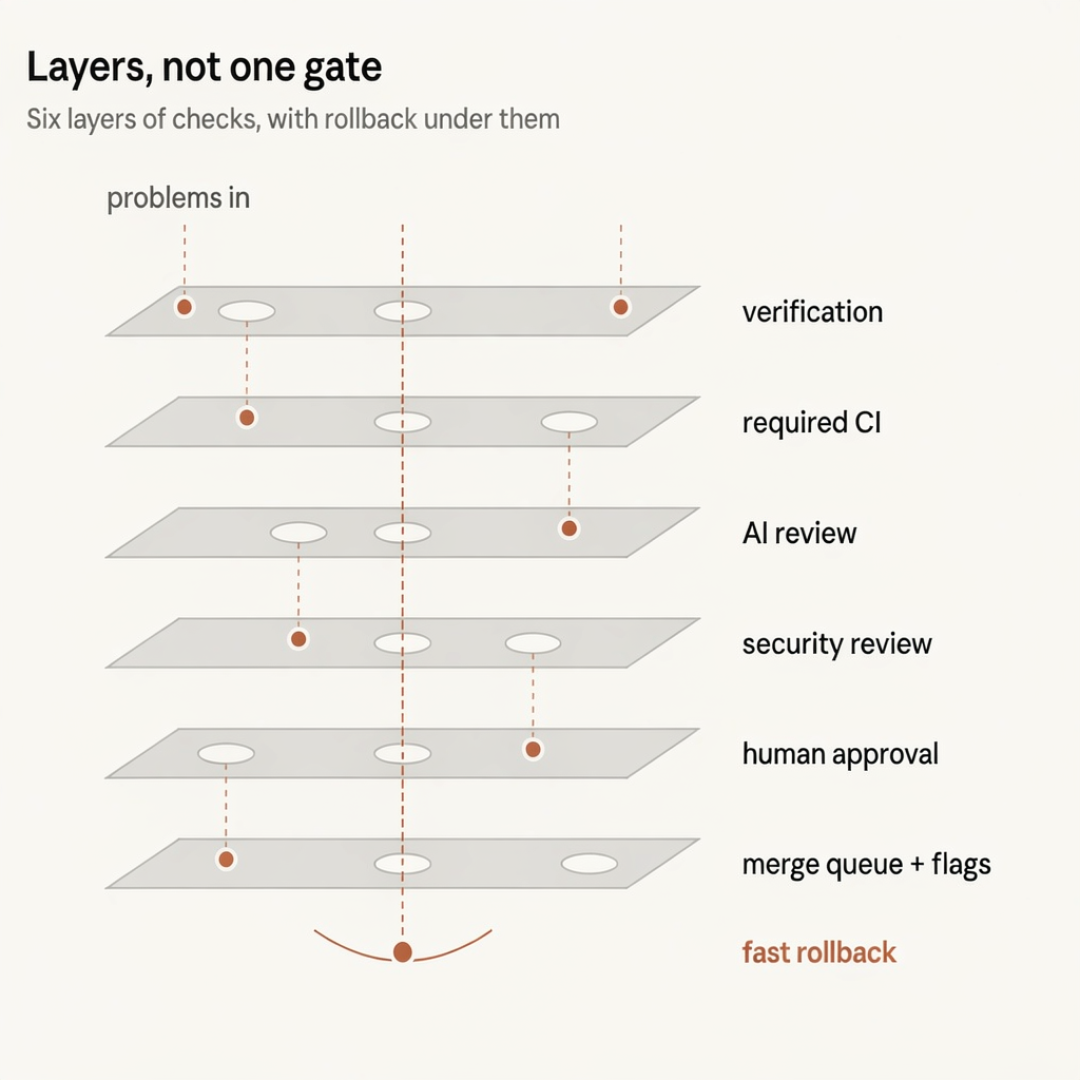
第六宗:不跑真数据,跑通自己写的测试就交付。以为运行他自己写的测试通过就能交差。最麻烦的是代码和测试出自同一个Agent,盲区完全重合。所以端到端验证比单元测试管用:让Agent把改动后的应用实际跑起来,像用户一样点一遍,挂了会给出截图和轨迹,糊弄不过去。小红书知乎小红书
Claude Code团队还加了个独立评分器对照标准检查产出,任务成功率比普通提示词循环最多提高10个百分点,问题越难提升越明显。人的代码评审也跟着缩水,改成只看"验证材料":录屏、截图、执行轨迹。知乎小红书
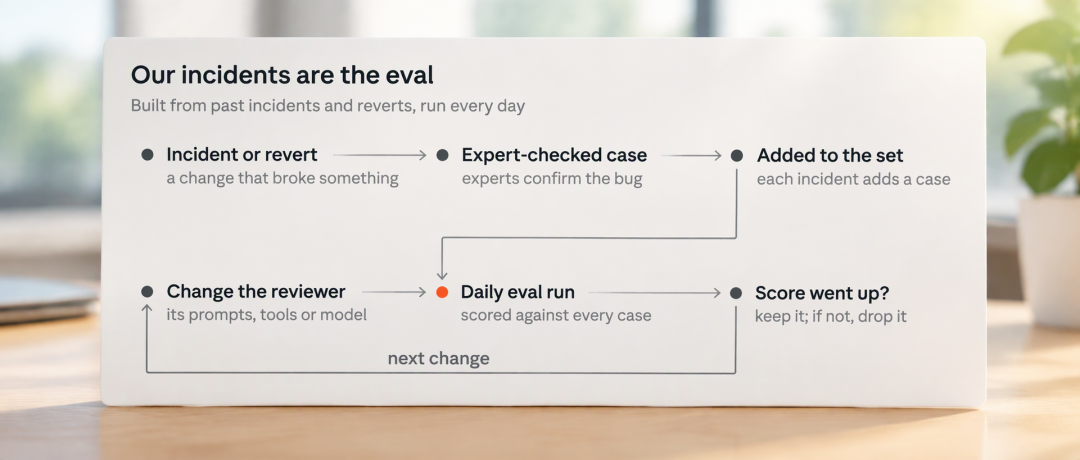
第七宗:被旧文档带偏,将错就错一错到底。容易被先前的文档和代码实现带偏。Claude Code团队的门控很硬:审查规则REVIEW.md只从基础分支读取,绝不读当前PR里改过的版本——不能让改答卷的人顺手改评分标准。小红书知乎
还有一条同样硬:连续修3轮还是挂,立刻停下来拉人介入;对"重跑碰运气"零容忍,找不到根因就删掉测试并写明原因。知乎
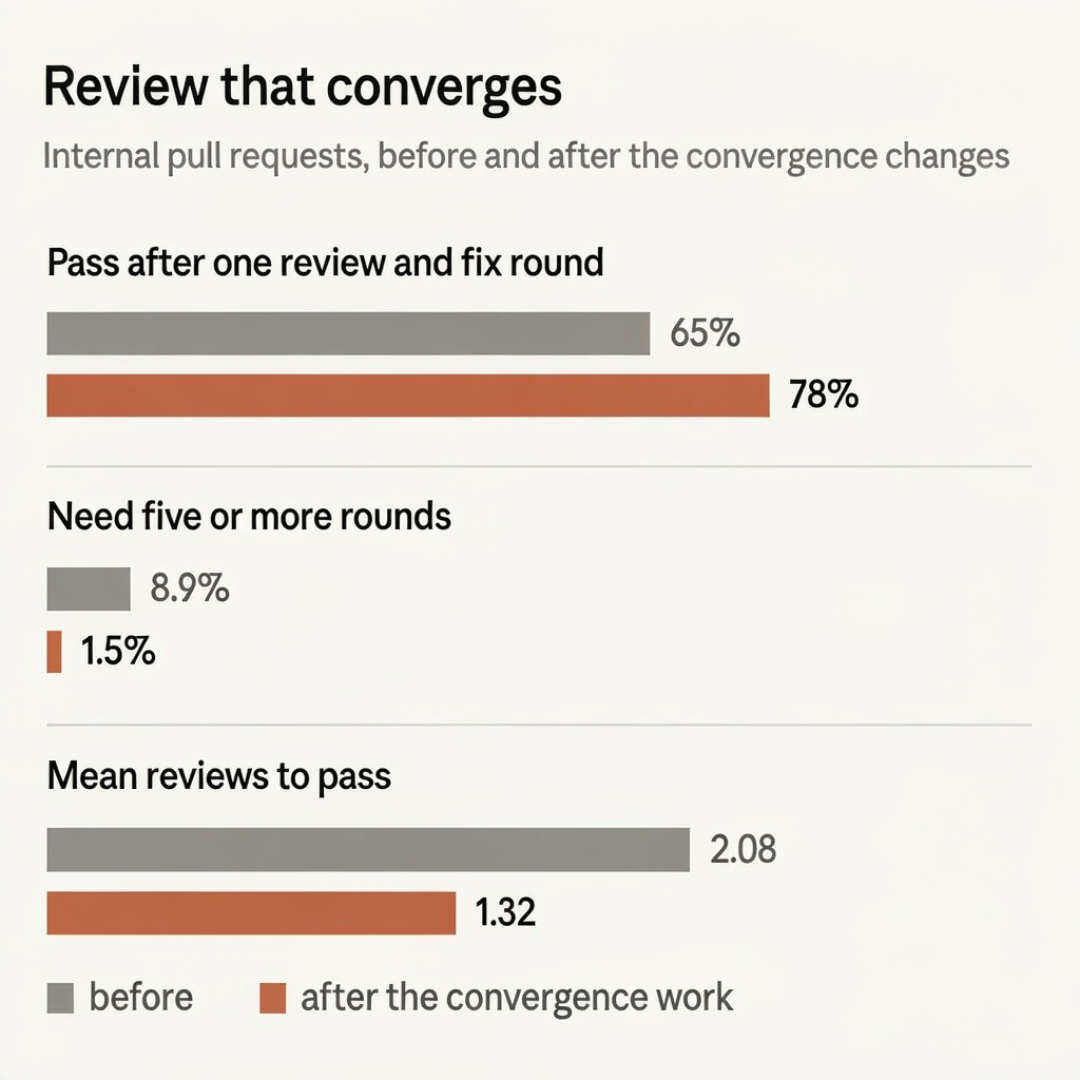
最后给个数:Lauren Tan有70%的Token花在验证上。815个赞不是偶然——你的工作重心正在从逐行读diff,变成定义清楚"什么叫做完",然后审查Agent跑出来的运行证据。至于那七宗罪?拆得动,就接着用。<#&!53#&!>小红书知乎
当前文章无评论,是时候发表评论了