「#Fable5 出来了,我搞了一个月的 harness 直接变成负优化了。」
10 月底小红书上这条评论,点赞不算最高,却戳中了大批 AI 工程化从业者的软肋:prompt 工程、上下文工程才学完,现在又冒出个 Harness 工程。评论区一边是「纯造词工程」(84 赞)。另一边是「熬到 5 点学的会不会白费」。小红书
先把造词这事先掰清楚。一句话定义:Harness = Agent 系统 − 模型本身,「除了权重,其他全算」。 提示词管「话怎么说」,上下文工程管「让模型看到什么」,Harness 管「模型在什么环境里可靠干活」。agent loop、状态持久化、工具权限、结果验证、出错重试——这些东西提示词一个都管不了。「给提示词打补丁」和「给模型造马鞍」,压根是两个工种。知乎

那它为什么偏偏在 10 月底爆火?因为行业正结结实实撞墙:艾瑞咨询数据显示,国内大中型企业 AI 采纳率已达 90.9%,但只有 9.1% 进入体系优化级,83.7% 的项目还挤在通用辅助的「浅水区」,甚至预计未来 18 个月 30%-40% 的企业级智能体项目会因算不过来 ROI 而停滞。光接个大模型,真跑不稳业务。36氪
而「搭外壳」第一次有了硬证据:谷歌 10 月 9 日开源的 Harness²,不动模型权重,让智能体自己改写自己的外壳,GLM-5 在 WorkBuddy-Bench 上从 64.2 分跳到 75.7 分,一步优化反超未优化的头部模型默认配置。36氪
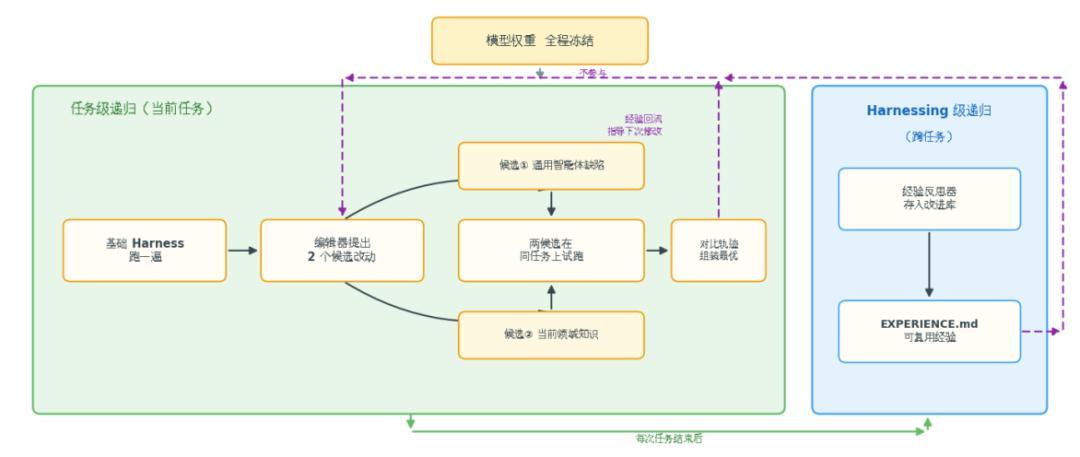
论文里那句话相当扎心:模型能力只是下限,harness 质量决定上限。但说它「刚流行就要淘汰」,也只说对了一半。OpenAI 的原生上下文压缩、微软把审批和状态持久化塞进 Agent Framework——平台厂商确实在把标准件收编,评论区也有人点透:coding 这类标准化高的领域,harness 正在被模型厂商内化。贬值快的恰恰就是那层东西:提示词拼接、手工上下文组装、见任务失败就加的调度规则。36氪知乎小红书
所以问题从来不是「要不要学 harness」,而是「你搭的东西经不经得起下一代模型」。 吵到最后,共识其实很清楚:会被收编的是临时技巧,收不走的,是状态管理、工具调用、权限控制、结果验证、故障恢复这五件运行时资产。具体落到操作就三条防线:知乎
做薄: 先把「改码→测试→反馈→检查」的任务闭环跑通,上下文真成瓶颈了再上压缩和分层记忆,每个机制配可验证指标,别凭感觉堆料;
写进文件: Devin 下线过、Vibe Kanban 停服过,教训是文件活得比编排器久——关键决策写进 git 管理的普通文件,别让它死在某个 agent 的私有存储里。知乎
学会忘: 压缩治不了「上下文惯性」,Drew Breunig 把 200K token 画成警戒线,实操是每个关键阶段结束强制切断、另起新会话,有人实测同等规模任务 token 从 106.9M 降到 72.5M,一把省掉 32%。知乎
从提示词到上下文再到 harness,名词一直在换,下一站大概率叫 Agent 运行时工程。下次再冲一个新词熬夜之前,先问一句:换一代模型,我的系统还能不能稳稳把活干完? 能,你就是攒下了日常;不能,你只是在攒补丁。