当一个工程师可以同时开几个 Codex 会话,每个会话各自拉分支、改代码、推送,Git 服务端看到的是成倍增长的分支和推送。OpenAI 内部先出问题的不是模型,也不是 GPU,是 Git。
OpenAI 在博客《Scaling Git at OpenAI》里承认,从去年底开始,monorepo 里的 fetch 和 push 越来越慢,merge 开始失败,可靠性一度掉到 90% 以下。OpenAI
并行的智能体把分支、推送、合并的数量一起拉高,传统 Git 服务端顶不住了。
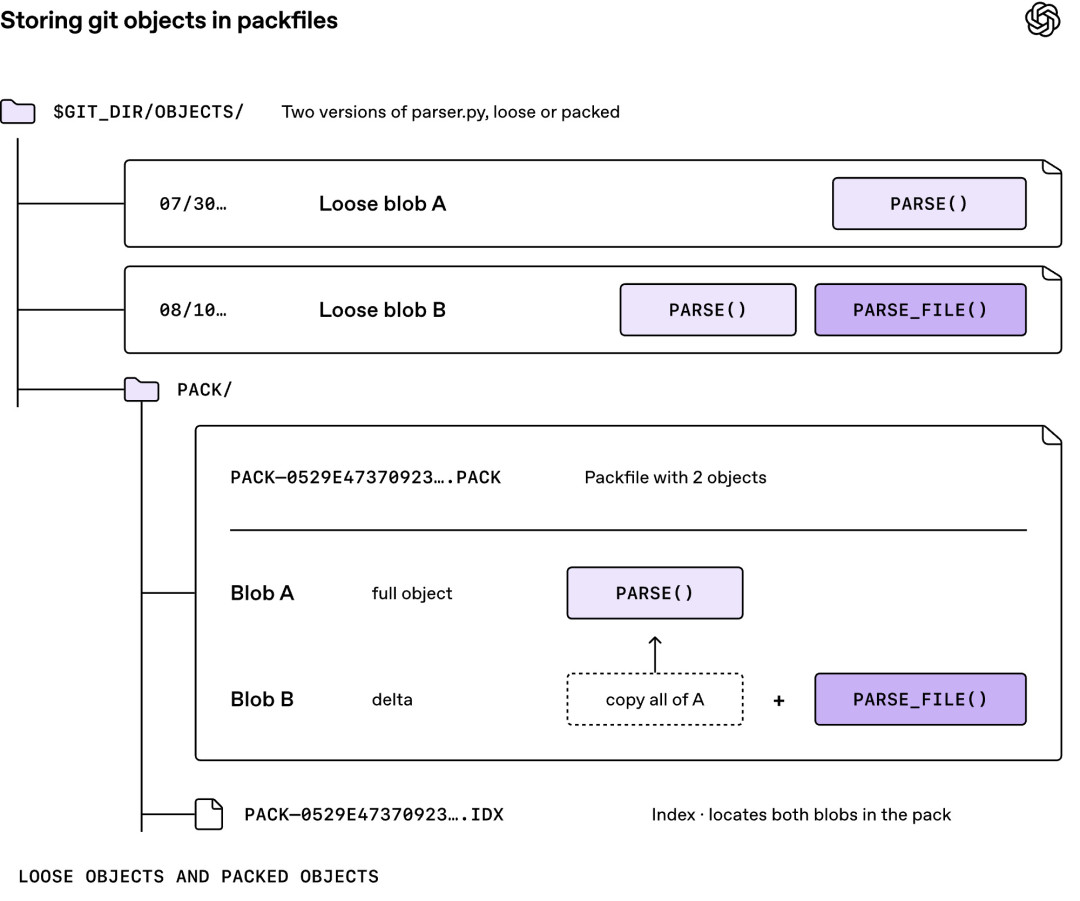
问题出在服务端的做法。每来一个客户端,服务端要现场算出它缺哪些对象,重新打一个 packfile;分支一多,不相关的推送还会在同一个协调点上排队。
OpenAI 评估过三阶段提交和共享 WAL,结论都一样:不同分支的 push 仍然在互相等。
他们最后的选择是保留 Git 协议和客户端,重写服务端。新后端叫 Pando,用 Rust 实现。
写入时,推送上来的 pack 先做流式校验,直接进对象存储,不在服务端解包;分支头、pack 和依赖关系记进元数据存储。每个分支独立协调,只有同时推同一个分支才会冲突。OpenAI
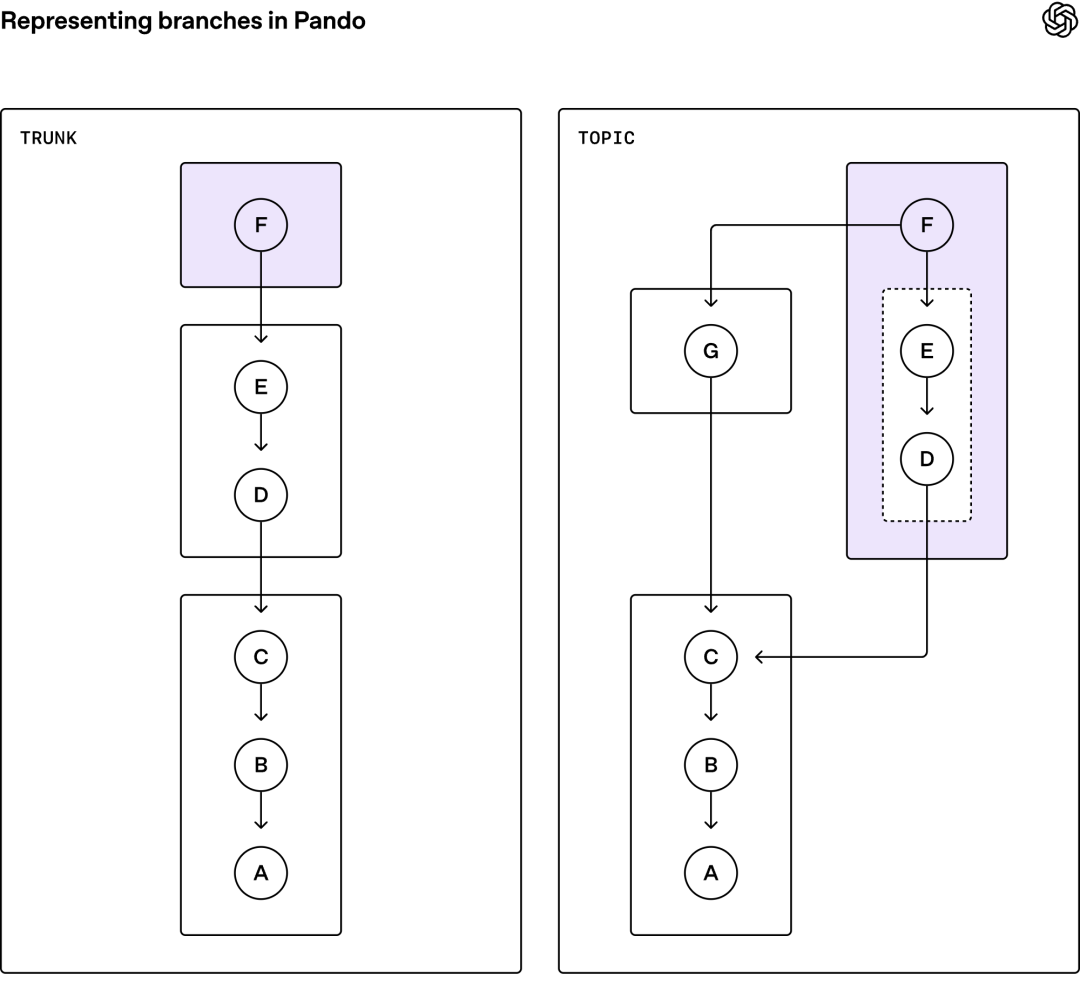
读取时,Pando 只挑出客户端真正缺的 pack,返回 packfile-uri 下载链接,由区域缓存服务 Express 送到本地。OpenAI 说缓存命中率超过 99%,单小时分发的 57TB pack 里,99% 以上来自本地磁盘。小红书
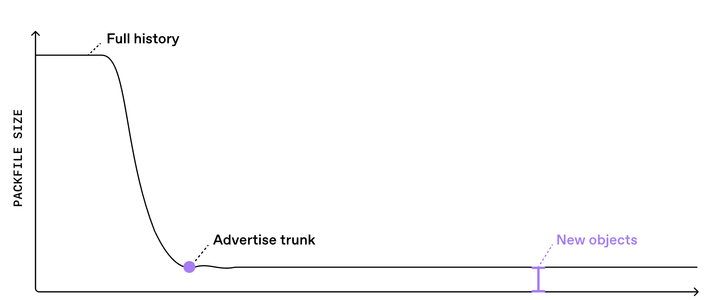
每次 push 会生成一个 L0 pack,后台像 LSM 树那样逐级合并。否则一个落后很久的客户端追上主干,一天要下载数万个 pack。合并之后,选包也能在对数时间内完成。
代价同样明确。默认只公布主干分支——分支到了百万级,光分支列表就可能超过 100MiB。OpenAI
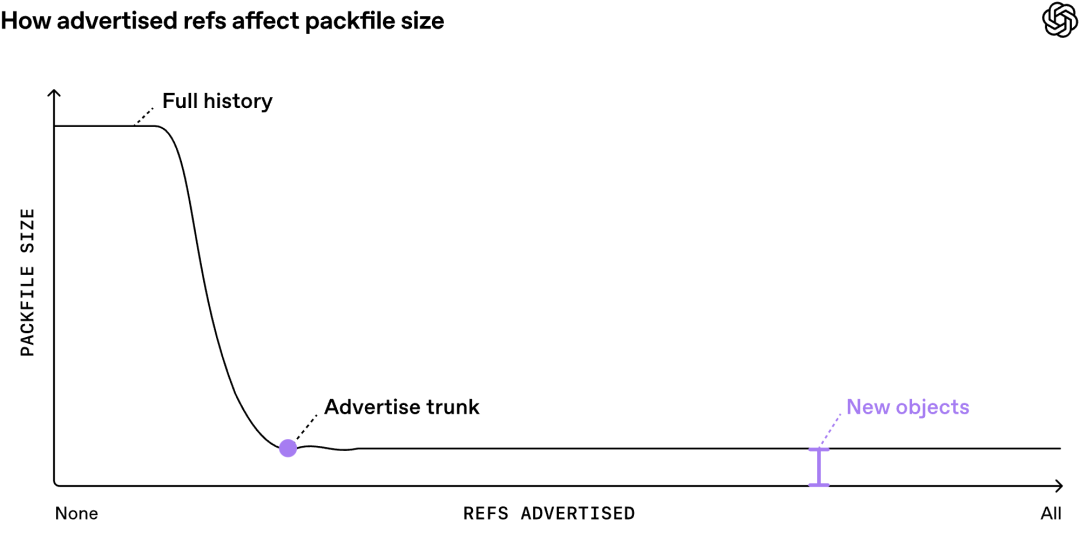
克隆时也不再保证跨分支的全局一致:一个客户端可能看到 foo v1 配 bar v2,另一个看到 foo v2 配 bar v1。
OpenAI 的判断是,用户和智能体依赖的是单个分支内的顺序,不是整个仓库某一瞬间的样子。
按 OpenAI 自报的数据,推送中位延迟降了约 80%,接近 5 倍;每天承载近 1PB Git 数据;4 月起承接生产流量。OpenAI小红书微博
建造方式也值得看一眼:一名工程师设计核心,多组智能体借助 Codex 写实现,10 周从启动到上线。部分修复还回馈给了上游 Git,比如 packfile 下载中断后的清理。Pando 没有开源。小红书
这件事对普通团队的提醒,不是“也去重写 Git”。Agent 把并行度推高以后,瓶颈会从写代码转移到协调:谁在同时改同一个分支,缓存能不能复用,服务端要不要为每个请求重算一遍。
Git 还是那个 Git,变的是用它的人和频率。