10月28日,谷歌把新模型 Gemini 4 Carbon 端上桌,距离上一代 Argon 只隔了15天。微博
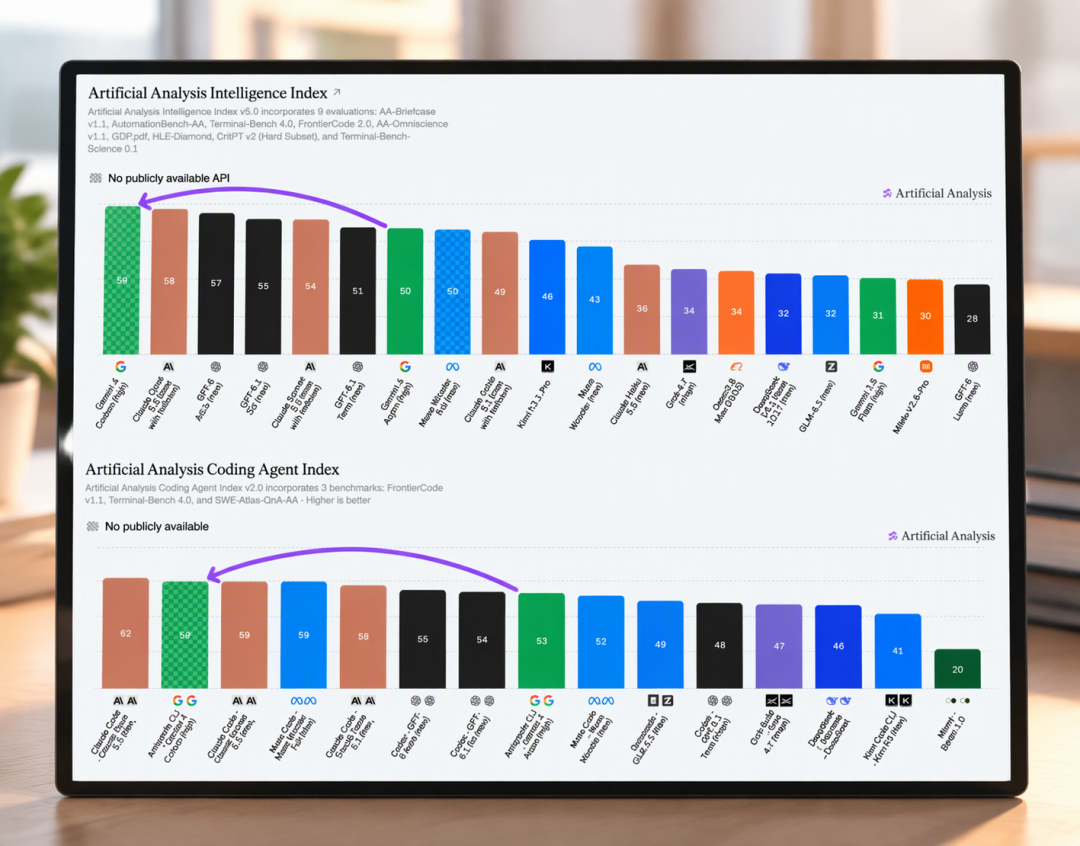
成绩单相当霸道:Artificial Analysis 智能指数 v5 拿下59分,把 Claude Opus 5.5(58分)和 GPT-6 Astra(57分)压在身下登顶第一。找漏洞的 SEC-bench Pro 跑出88.2%,长上下文 GraphWalks 更是96.2%对71.8%的碾压局。官方还说,内部团队见过它在一个任务上连跑好几天,跨大代码库定位、修补隐蔽bug。微博知乎知乎
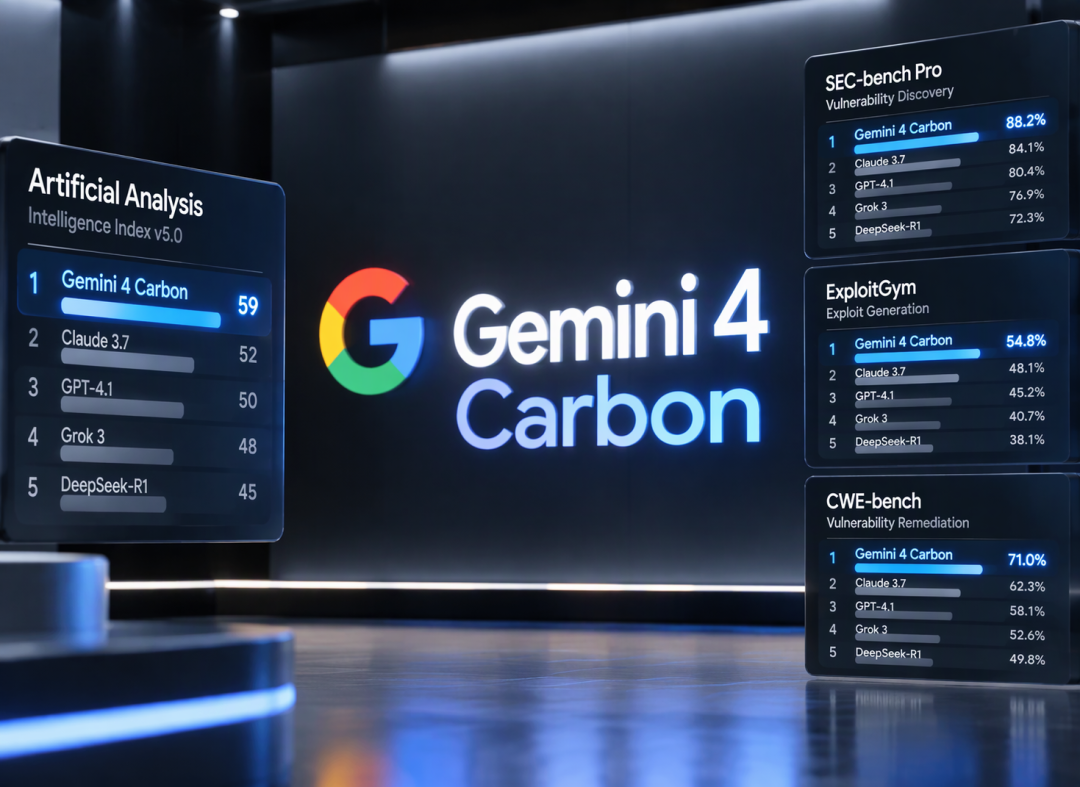
价格更狠:首发价每百万token输入2美元、输出10美元,促销结束回到4美元/20美元,缓存输入再打95折。有媒体算过,这个API定价只要 Claude 和 GPT 同级的一半。跑分反超加半价,是不是该把编码助手的默认模型换了?微博微博
先别急,两盆冷水都是谷歌自己泼的。
第一盆:综合榜第一,不等于写代码第一。同一家的编码 Agent 榜上,Carbon 约59分,仍落后 Opus 5.5 的62分;更贴近真实软件工程的 FrontierSWE 2,它61.2%也输给 GPT-6 Astra 的65.5%。综合榜是全能赛,十项全能第一名,不代表每一项都打得过单项冠军。知乎微博
第二盆更意外:你现在根本用不上。这是头一回,榜首模型不先开放给程序员,而是先给安全防守方——理由很直白:这模型已经能写出漏洞利用代码。本周只开给一小批网络防御团队,再经 Fairwind 计划分阶段扩到政府、关键基础设施和核心科技平台,全球650多家伙伴排队。开发者和普通用户?官方没给时间表。能力越像双刃剑,放量越要分队列。知乎知乎微博
顺带一提,官宣没几天,就有独立架构师压测复现了一处能稳定触发的多模态熔断BUG,常规图文输入直接让推理链路断裂报错。谷歌暂未回应,榜单好看,不等于鲁棒性达标。知乎
那还守着旧模型的程序员该干嘛?三件事今晚就能做。
一,别把官宣日当切换日。默认模型别急着换,真要换,回滚方案先写好。
二,别照公开榜单选型——榜单测的不是你的代码。从自己仓库出题,搭一套私有评测集,跑自己的回归,这才是对你有意义的榜。
三,把token账算细。代码生成的成本趋近于零,审查成本却在涨。AI省下的是敲键盘的时间,多出来的是读代码、判断对错的时间。把模型账单摊进每个项目的毛利表,按季度复盘,半价才真的和你有关。知乎
更大的信号其实是节奏:15天一代前沿模型,最强的那个开始按安全敏感度分级发放。程序员曾经是新技术的第一批尝鲜者,现在可能排到最后一队。
别慌,半价的账单迟早会来,只是队伍已经开始排了。