

显卡又在涨价,24G显存的卡越推越贵。想本地跑个27B稠密模型,以前没张上万块的卡基本免谈。
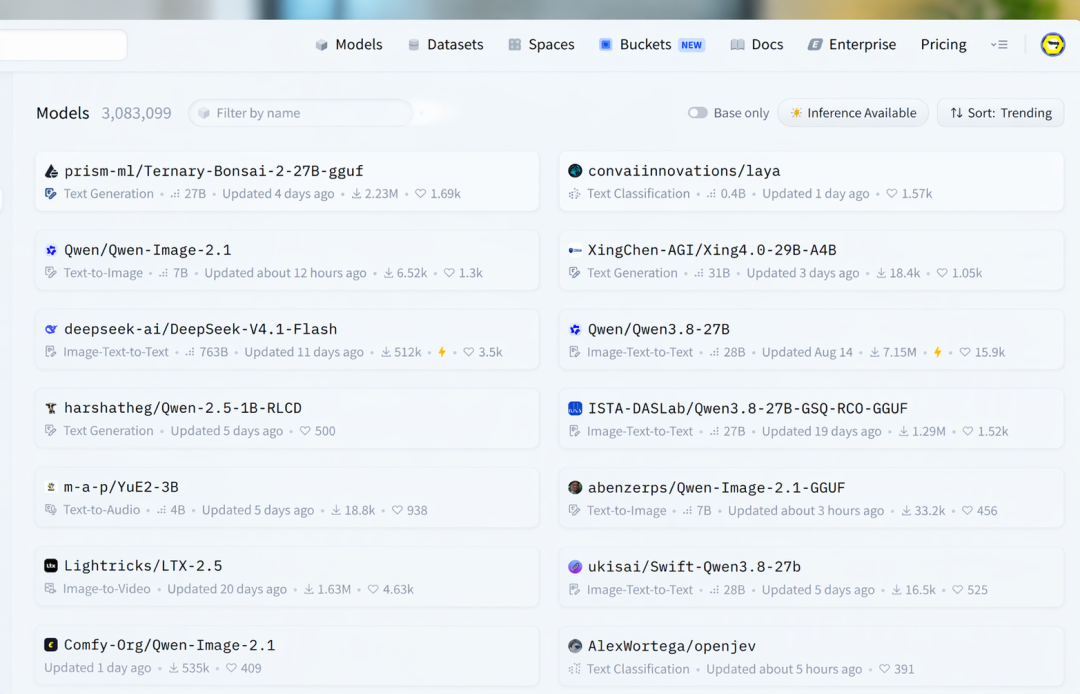
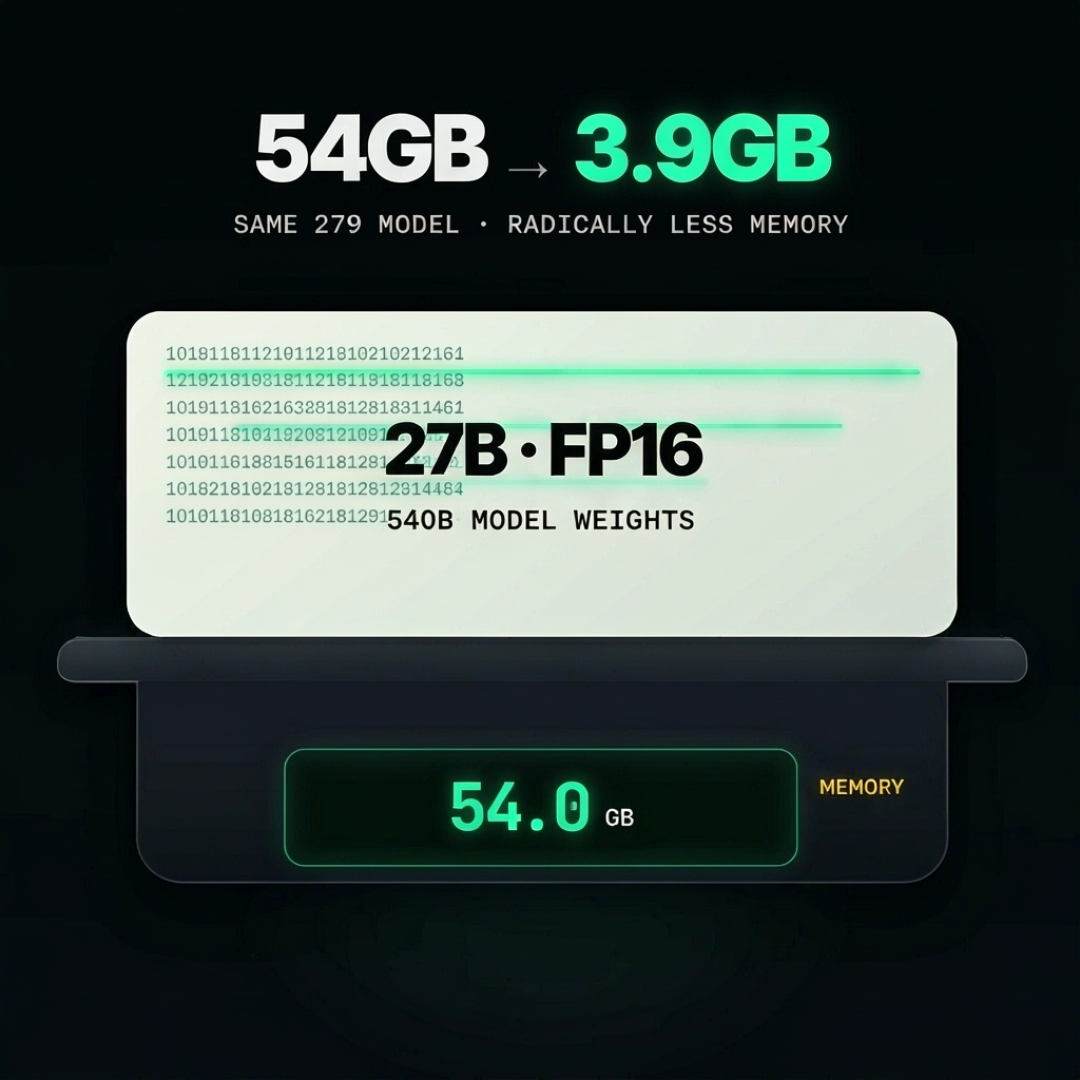
就在这个节骨眼,一个5.9GB的文件在本地圈刷屏了。它不是7B,是27B——PrismML的Ternary-Bonsai-2-27B,把Qwen3.8-27B整个压进5.9GB,只有原版九分之一。原版FP16要54GB,常规Q4也得18GB左右,比很多7B还小,还登顶了HuggingFace趋势榜第一。知乎哔哩哔哩
凭什么这么小还不傻?靠"三值量化"。
传统量化把16位权重往4位、2位压,越压越"失忆",数学、代码、长链路推理掉分尤其狠。三值量化换思路:每个权重只取-1、0、+1三个值,再让每128个权重共用一个FP16缩放系数,平均每个权重才约1.7比特,比传统2-bit还小。多出来的那个"0"是关键,让它比纯二值(只有-1和+1)聪明不少。知乎
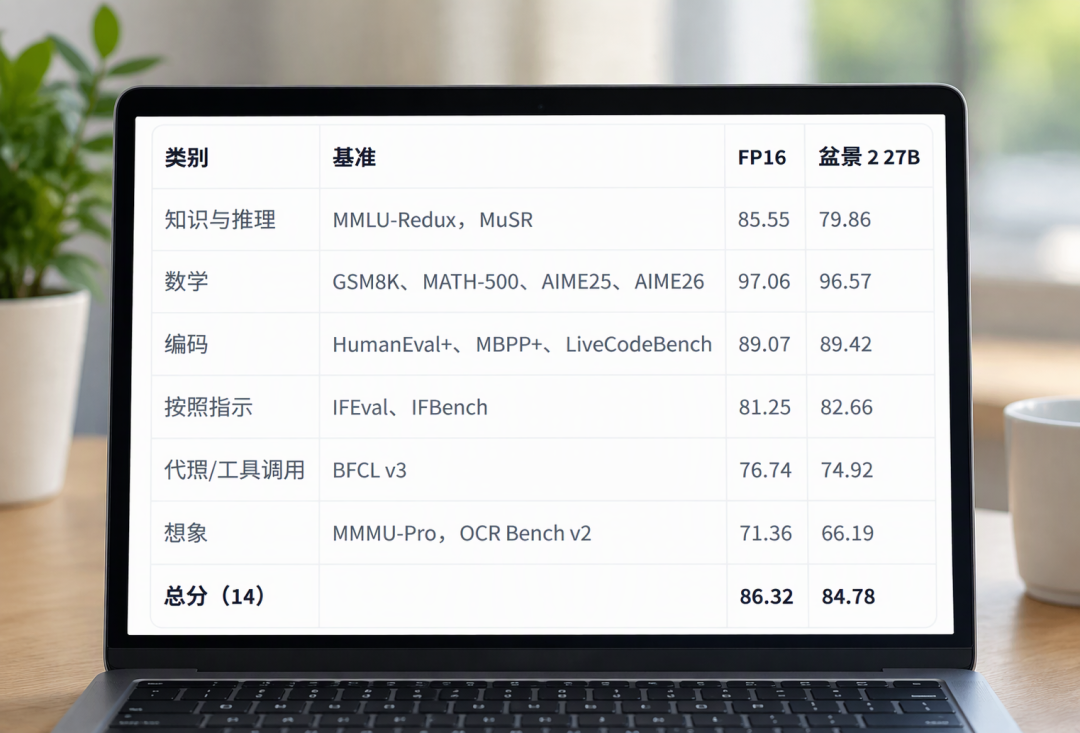
效果多反直觉?传统Q2版9.4GB,综合分才72.59;Bonsai-2更小,反而高出十来分。官方跑分综合83.9对原版85.4,保留98.2%,指令跟随甚至102%反超。它已经脱离"脑残量化",智商损耗接近传统Q4,却把硬件门槛砍到脚踝。哔哩哔哩
门槛砍到多低?8G卡塞PTQ1_0版,模型能进显存,就是上下文很紧;12G卡跑PQ2_0,上下文从容些;16G显存还能装下视觉模块和更长上下文,本地知识库、长文分析、多轮对话都舒服。苹果统一内存24G以上更稳,官方M5 Pro实测约28 token/s。11月8日的一份实测里,4060Ti 16G跑Q2_0版约25.9 token/s、占用约9G,12G卡也能跑。RTX5090更是143 token/s,Apache-2.0开源、262K上下文、图文多模态。哔哩哔哩
先别急着下单。两个坑,踩一个就够折腾半宿。
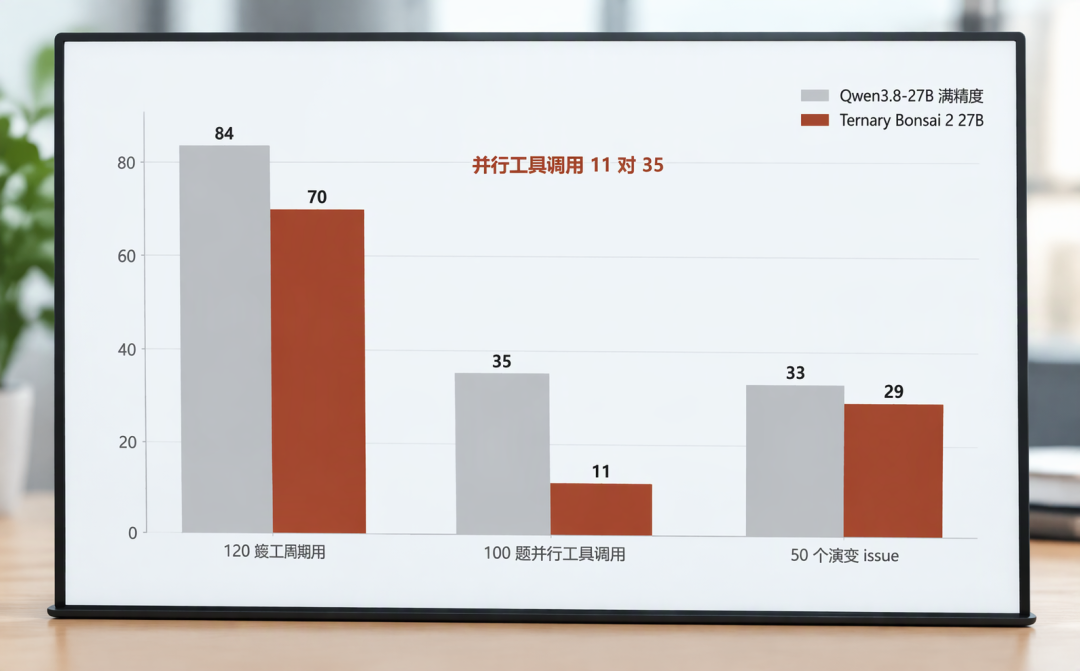
第一坑:98.2%是跑分,不是干活能力。一份同环境对比里,短任务48.6对47.1基本打平;可6个长程构建任务,全精度做出35/60,三值版一个能用的应用都没交出来。选择题接近满分,不代表它能替你把连续几十步的正经活干完。长链路推理和agent,才是低比特量化的照妖镜。哔哩哔哩
第二坑:原版llama.cpp读不了它。Bonsai-2需要的Hadamard激活变换还没合并进主线,必须用PrismML定制fork。普通版跑PTQ1_0/PQ2_0通常直接提示不支持;更阴间的是,仓库那个Q2_0文件可能正常加载,然后输出乱码——你以为跑通了,其实它在胡说。小白别硬啃,让本地agent照着项目GitHub把环境装好。知乎
所以回到最实在的问题:你要它干嘛?
要本地知识库、长文分析、多轮对话、代码文档总结——三值量化把27B门槛从上万压到主流甜品卡,真香,8G卡都能上车。要它替你跑长程agent、交付正经活——先别all in,98.2%的跑分撑不起这期待。
它降的是显存门槛,不是能力天花板。分清这两件事,再决定要不要为它腾出那5.9GB。
当前文章无评论,是时候发表评论了