

屎山1.0时代,塌之前至少还有个建筑师在群里;屎山2.0,连"作者"都不认识——因为它压根没有作者。
最近两周,"AI写的代码会不会变成屎山"成了程序员社区最高频的追问:仅知乎上,“AI代码让项目变屎山”"review跟不上AI生成速度"的相关提问就堆了十几条。这次不是焦虑,有数据:GitClear把2020到2024年的代码变更逐行分析了一遍,合计2.11亿行,结果两个字——堆积:加新功能时没人再顺手理旧账,都是往上糊一层。知乎
Sonar调查1100多名开发者,88%说AI代码有坑,最大的坑还不是跑不通,而是53%的人选了"看起来正确,但不可靠";Stack Overflow三万多人作答的调查里,66%的人吐槽同一个意思:almost right,but not quite。知乎
吓人的不是"烂",是静默。人写的烂代码,编译器当场拦下;AI的"几乎对"代码,review能过、测试能过,上线几个月都不吭声,直到某个没人想到的边界条件把它引爆。Anthropic做了个对照实验:52名开发者学一个新代码库,写完当场考他们对自己刚写的代码的理解——不是隔了一年,是刚写完就不懂了。知乎
连AI辅助开发圈公认玩得最深的Simon Willison都承认,整段整段让AI生成功能之后,“我在自己的项目里迷路了”。业内管这叫理解债:技术债好歹有账本,理解债连账本都没有——代码生下来就是孤儿。知乎
那么问题来了:50万行的老项目,AI到底读不读得懂?今天有实测把Qoder、Claude Code、Codex三条检索路线摆开正面交锋,几个结论相当反常识:
Qoder:定位快、一次收敛,代价是首次索引有启动成本、刚merge的PR可能还没进索引——它提前建好千亿级向量索引,查询先做改写与意图识别,再走向量、关键词、符号、Git提交记录、Wiki五路并发召回,代码图谱在客户端本地构建。知乎
Claude Code:搜索永远实时、LSP做编译级引用查找重构不漏点,但多轮搜索烧token、第一轮关键词猜不准就空转;最狠的是早期版本搭过RAG加本地向量库,几个月后整体移除,创建者Boris Cherny的原话是模型驱动的glob和grep打败一切。
Codex:架构最简、零依赖,但token成本最高、对模型"自律"要求最狠——它从未做过索引,社区的功能请求也被明确拒绝,全押模型推理。
两家互为竞品的模型厂商,独立做出同一个选择,不是巧合——RAG在代码场景被双双证伪了。知乎
更反直觉的是:注释并不是向量检索的必要条件——`MAX_REFUND_LIMIT`拆成max/refund/limit,标识符本身就携带语义,写得规范的无注释代码,命名本身就是给embedding模型的注释。知乎
反过来也成立:命名不知所云、无注释、无文档、Git被squash成一个commit时,千亿级向量引擎和裸grep一样无米下锅。知乎
所以工具的上限由代码库的语义质量决定,面对屎山,第一动作不是换更强的AI工具,而是先把代码库打理好。知乎小红书
想从坑里爬出来,三个明天就能做的动作:
先补信号,别急着换更强的工具:花半天给核心链路补上规范的提交记录、术语表和docstring——实测能把定位轮次从4轮降到2轮。知乎
review分级,人只盯意图:review该保住的不是逐行读代码,是判断这次改动想干什么、影响面在哪,逐行校验交给类型检查、单测和灰度放量;Claude Code团队的PR环节同样在做AI审核加按风险审批。知乎小红书
把踩坑挖出的隐性依赖、命名黑话回写进Agent记忆文件和注释——这是复利,下一个任务启动时就不用重新踩一遍。
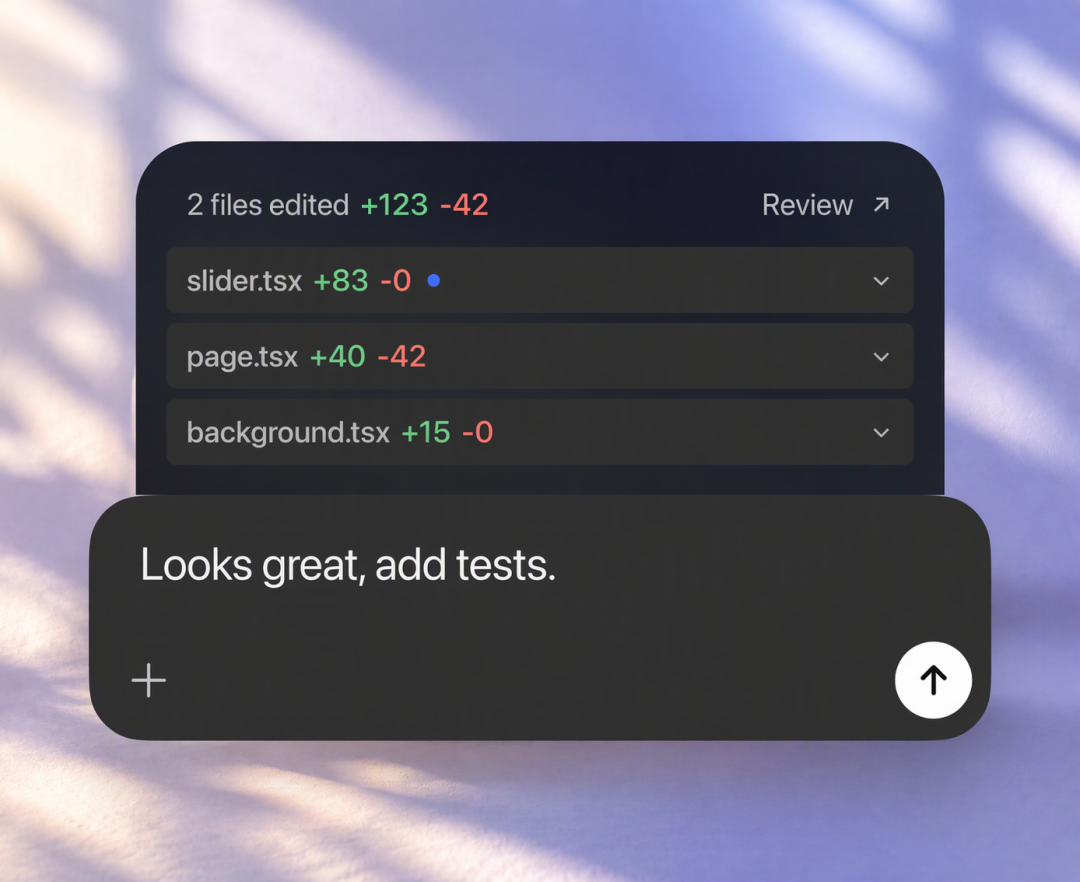
硬币的另一面也有数据:小红书刷屏的那场AI Engineer大会演讲里,Lauren Tan的团队一个月交11000个PR,回滚率0.5%,她们的做法是把审代码从读diff改成看证据——录屏、截图、图表。小红书
CMU分析3100条从业者讨论,结论就一句话:会review、会测试AI代码的团队全在晒收益,跳过review的团队全在讲事故。AI没有让写好软件变难,它只是把摆烂的账单,从几年后寄到了几个月后。知乎
当前文章无评论,是时候发表评论了