

昨日多模态焦点从“看懂图文”继续外扩:原生全模态世界模型开始把视频变成可漫游、可编辑、可持续交互的动态空间。
HiDream-O1-World:从生成视频走向可交互世界
智象未来发布 HiDream-O1-World,主打漫游、编辑与交互三类能力。其价值不只在画质,而在于用空间记忆和在线适配维持长时程时空一致性与物理一致性;目前公开成绩仍主要来自官方披露及 WBench 单一基准,实际开放程度与持续交互稳定性有待更多独立验证。
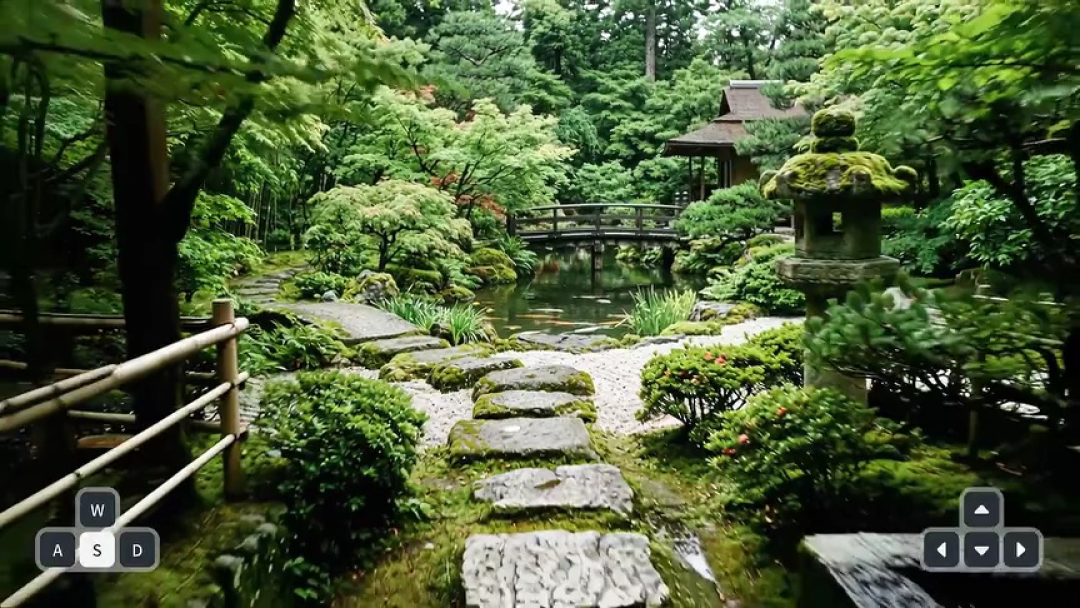
能力、架构与应用价值
统一多模态模型:理解、生成与推理正在合流
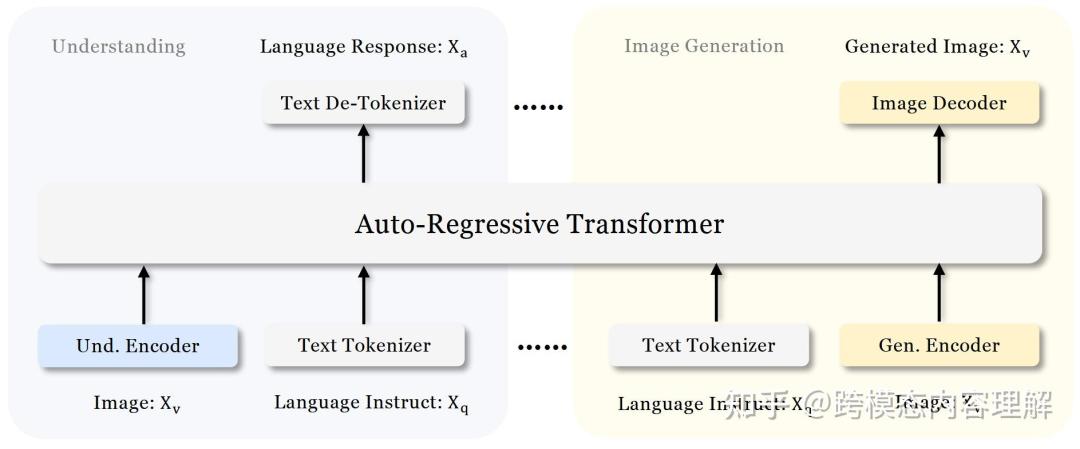
一篇当日社区长文系统梳理 MMaDA、Janus 等代表路线:有的用离散扩散统一文本与图像建模,有的通过解耦视觉编码缓和“理解需要语义、生成需要细节”的冲突。适合用来建立技术谱系,但文中汇总的是既有研究,不应误读为 8 月 17 日的新模型发布。
学习入口:两小时串起经典视觉模型与实战
对希望补齐基础的人,当日更新的长视频覆盖 SAM、CLIP、BLIP、DALL-E 与对比学习,收藏数据明显高于互动评论,适合作为课程地图;不过标题宣传色彩较强,建议按章节挑选并结合论文或官方代码核验细节。

当前文章无评论,是时候发表评论了