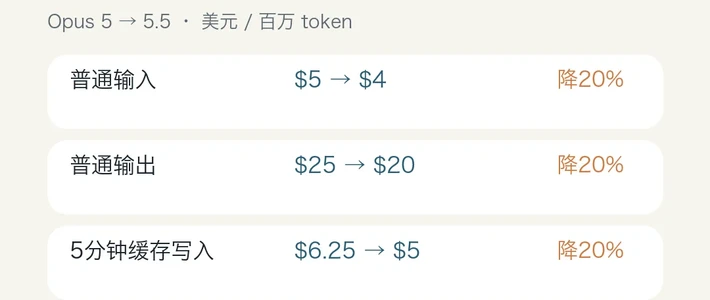
每月额度爆掉、任务跑到一半等 5 小时重置——这是现在 AI 编程社区吐槽最多的两个瞬间。但 9 月 25 日知乎上一篇《AI 编程的 token 都烧在哪了》给出了一个反直觉判断:你的 token 大部分不是花在「写代码」上,是花在「找代码」上。让 AI 改一个函数,它要先定位这个函数、通读一遍、翻调用方、再读几个相关文件,才轮到动手写。真正生成代码的输出,可能只占整次请求的一小部分——剩下的全是输入,而输入 token 一样要钱。知乎
这句话值得较真:如果钱真不是烧在生成上,那我们囤额度、比套餐、纠结要不要升 Pro 的思路,从一开始就问错了问题。我把最近一个月知乎、B站、微博、小红书上的讨论和几项研究摆在一起,替你算了三笔账:钱烧在哪、哪些省钱技巧是玄学、什么时候才值得动套餐。
一、一次请求里,「写代码」到底占几成
把一次 Agent 会话拆开看,成本结构是这样的:定位(grep/读目录)→ 读码(目标函数+调用链)→ 生成(真正打字)→ 再定位验证 → 再改。生成只占一环,前面的环节每轮都要重来——因为模型没有记忆,每一轮请求都要把上下文重新注入一遍。
这不是个别博主的体感。有知乎答主梳理了长上下文编程的研究(OMLCP),结论是 Agentic 工作流的复合低效主要由「非输出开销」驱动,尤其是反复重新注入上下文;按研究的说法,优化策略能把总 token 成本降一到两个数量级,仅结构化裁剪就能无损省 20%–86%。同一篇梳理还引了一个更有画面感的行业信号:Gartner 说 Context Engineering 正在取代 Prompt Engineering;《纽约时报》报道硅谷甚至流行起「Tokenmaxxing」——工程师晒月度 token 账单证明自己在干活。知乎
对用户翻译成人话:你付的钱,大头在「让 AI 重新认识一遍你的仓库」,不在「让它打字」。

二、四个真正的烧钱口
跨平台看下来,吐槽虽多,钱基本只从四个口子漏出去:

上下文重注入。 每次新开会话、整个仓库往 context 里塞、项目跑到后期文档越滚越大——B站上有 UP 主的原话是「项目刚开始消耗不高,上下文文件多了之后 token 消耗明显上涨」。哔哩哔哩
工具回显和「喂图」。 grep 一次性回显几百行、能文字描述的事偏要截屏。省 token 视频里最朴素的建议:一张截图顶几千 token,能自己说清就别喂图。哔哩哔哩
重试循环。 Agent 改不动就反复读、反复试,这是最贵的一种浪费。B站 8 月有个帖子标题就很扎心:《4 个月消耗 300 亿 Token 后,我为什么不再让 AI 独自跑大型项目》——连续跑 3 天 XHigh 推理强度,构建出二十多个包,测试过了,但人回头看不动。哔哩哔哩
档位错配。 事事都上最贵的旗舰模型。不过这条的解法(路由到便宜模型)恰恰是争议最大的,见下一节。

三、先帮你筛掉三种省钱「技巧」
「XX 星开源 Skill 暴降 90%」类,看看机制,别看数字。 B站从 8 月起反复出现同构视频:11.3K 星降 70%、95K 星降 90%、108K 星降 90%……标题的星数一路变、口径全是「暴降」。这类工具(外置记忆、按需索引、上下文压缩)的机制是真实存在的,「降 90%」却都是项目方或搬运视频的宣称,没人在自己的仓库里替你验证过。可以先用它的开源实现自己量一轮,再决定信多少。哔哩哔哩
「简单任务路由给便宜模型」,省不省钱取决于任务切不切得开。 B站有 UP 主的方案是 90% 普通开发交给便宜模型、10% 难题留给旗舰,自称省下九成;但知乎 9 月 22 日一个实测答主泼了冷水:按任务分配不同价位模型,最后可能花更多——强模型倾向于自己干完所有活,很难主动交接;就算强制交接,它还会仔细检查便宜模型的产出,检查本身就是二次消耗。两边都有道理,分歧点其实很具体:你的任务能不能清晰切块、验收成本低不低。切得开(格式转换、批量模板、单文件小修)路由划算;切不开(跨模块重构)别折腾。知乎
晒 token 账单不是生产力。 承接 METR 那个著名的随机对照试验:16 位平均 5 年经验的开源开发者,在自己最熟的仓库干活,用 AI 实测反而更慢;2026 年想重复实验时发现大部分开发者不愿不带 AI 参赛。同期还有研究记录到 AI 代码让代码重复增加约 4 倍、变动率翻倍,甚至有了专门名词「Agentic Debt」(无人监督的仓库级自主修改产生的隐性成本)。Token 烧得多的那部分,可能只是欠债的利息——这句话对「额度焦虑党」和「晒单党」都适用。知乎
四、套餐这笔账:什么时候升级才不冤
先摆近三个月的供给侧变化。7 月 13 日微博上有梳理总结过这轮「额度大战」:Codex 取消 5 小时限制、Claude Code 周额度再涨 50%,竞争从「谁更聪明」打到「谁敢让用户多用」。知乎 9 月 21 日一位用户把各家订阅折成每百万 token 单价算了遍账:Codex Pro 月费 200 美元、周额度实测约 20 亿 token,宣称单价约为 DeepSeek Pro 的 1/2 到 1/4,赶上额度重置活动差距更大;Plus 档 20 美元,走土耳其区折下来约 70 多元人民币,且网页端聊天额度与编码额度分开计。Claude Code 编程口碑最好,但同一篇的结论是性价比不如 Codex、国内支付门槛更高;DeepSeek/GLM/MiniMax 配 Claude Code 的组合便宜,短板在旗舰能力差距。注意:这些都是单一 UGC 的实测宣称,各家随时调价,截图存档前先看当天官网。微博知乎
还要加一个反向样本:知乎 9 月 22 日一位独立开发者晒了半年账单——AI 订阅(Codex/Claude Code/DeepSeek)基本没花什么钱,最大开销是买了上百刀的域名。模型费不是所有人的第一成本,先确认你痛的是哪一种。知乎
所以判断要不要升级,别看月费,看三个数:
你的有效轮次占比:一次任务里,AI 是在改代码,还是在读代码、找文件?找的比例高,先改用法;
你的撞墙位置:额度是卡在 productive 的重试上,还是卡在一次巨型启动(整仓索引)上?后者升级了照样爆;
你的任务切分度:路由省钱的前提是任务切得开(见第三节)。
一句话结论:额度被「找代码」吃掉时,改习惯比换套餐省钱;额度确实顶在有效工作上,这轮额度大战恰恰是升级成本最低的时候。

五、按人群的行动卡
轻度用户(编辑器插件写小工具):免费档+便宜模型够用。先戒「喂图」和整段粘贴,这两刀下去通常就告别额度焦虑。
重度终端用户(Claude Code/Codex 日抛几十个任务):照知乎 9 月 24 日那条被转的方法论来——开工前写四行任务单(现在什么行为、要改成什么、哪些必须不变、怎么验证),先让 AI 只找文件和调用关系,看懂计划再放它改。缩小改动到「能检查、能解释、能撤回」的范围,就是在砍最贵的重试循环。知乎
批量自动化/科研用户:小红书 9 月 25 日那篇《拿大模型做批量判断?钱都在白烧》说中了通病——判断类批处理先上规则和便宜模型,把真模糊的样本留给大模型。批量场景里模型档位每差一级,乘上条数就是月账单。小红书
团队负责人:知乎 9 月 25 日《七层底座》那篇点破的坑是「把买工具当成建能力」——Cursor、Copilot、Claude Code 各买一圈,能力全在几个高手的个人订阅里,人一走归零。省钱的方向不是砍席位,是沉淀共享的规范、模板和任务单。知乎

六、接下来盯什么
各家额度和重置活动节奏:这轮竞争还在加码,重置活动期间的实际单价和标称差异很大,升级前先等一等窗口。
「外置记忆/按需索引」类工具:B站 8 月 24 日讲 codebase-memory-mcp 的视频拿了 829 赞、1907 收藏,机制值得追,宣称数字自己测。哔哩哔哩
计费结构变化:下一批旗舰模型对「输入」怎么定价、缓存命中让利多少,直接决定上面所有账是不是要重算。
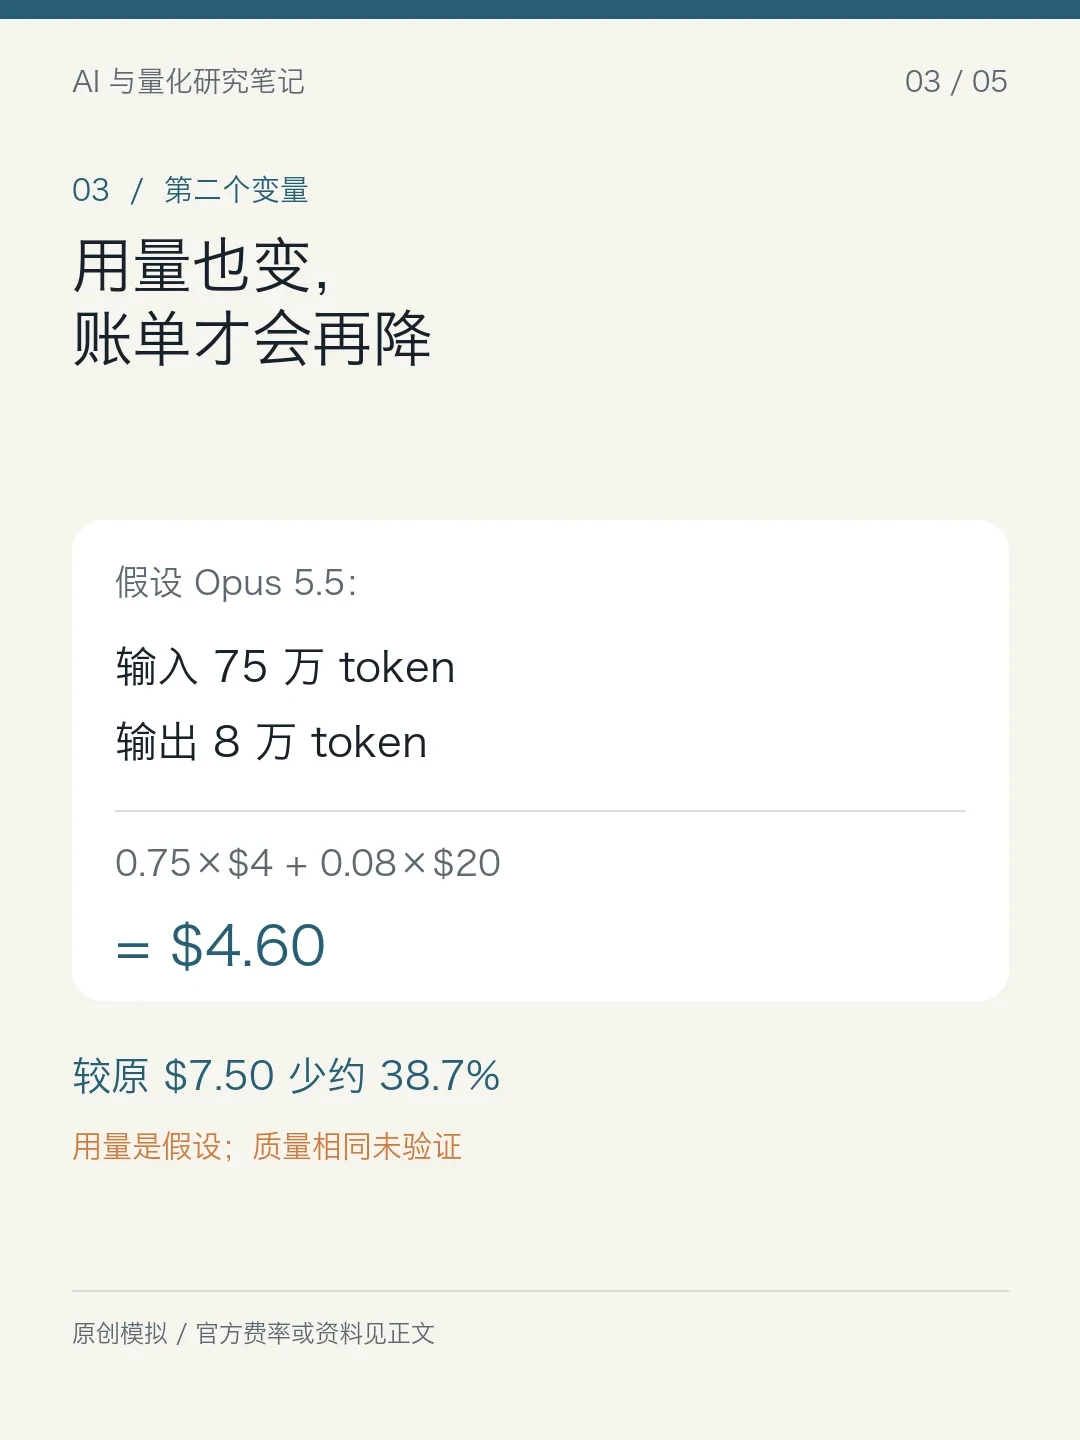
AI 让「打字」变得便宜,这件事所有人都知道;它没让「读懂你的仓库」变便宜,这才是你的额度账单。先花十分钟,把上个月的 token 烧进上面四个口子里看一眼——属于「找代码」的那部分,才是你现在就能省下来的钱。















