这三天,"大模型开始住进SSD"在小红书被大量收藏,那篇帖子的判断是:前沿模型能不能本地跑,问题已经不只是显卡够不够。 B站也有视频把一张4090加64GB内存加2TB SSD跑GLM-5.3、Kimi K3、DeepSeek V4,称作GitHub当天爆火的项目。 而你在DeepSeek V4.1开源那一夜刚被社区提醒过:撞的第一堵墙是权重。一周过去,这堵墙下面开始有人挖地道了。小红书哔哩哔哩
作为持币观望的"等卡党",先别急着给96G魔改5090下单——花两分钟看懂这波SSD流式路线,再决定你的钱该换卡还是该换盘。
先把两个"标题直觉"校准一下
colibri不是一夜爆火。 7月中旬它就以25GB内存跑通744B进了知乎长文,当时已经是1.8万星的项目。 到9月14日的GitHub热榜快照,星数是29,803。 第二波热度的节点,恰好是v1.4.0之后把Kimi K3收进支持列表——"2.8万亿参数塞进你的电脑"的炸裂标题就是这一波产物。知乎知乎知乎
它也不是大厂出品:作者JustVugg一个人写的,引擎本体是一个约2400行的C文件,零依赖、Apache 2.0协议;HN上那个帖子冲到453个赞,最高评论只写了一句"This is the hacker spirit"。 同一周里,它的代码口径还在"核心引擎约2400行"和B站解说里的"1.7万行C代码"(每个模型另配一个适配文件)之间摇摆——不重要,重点是纯C、零依赖。知乎
"2.8T能跑"每个字都真,但账要拆开看。 跑通是真的(README明确支持),可2.8T的Kimi K3快照1.6TB,先得装得下一整块盘;对个人玩家,现实入口其实是GLM-5.2那个约372GB的int4容器。知乎
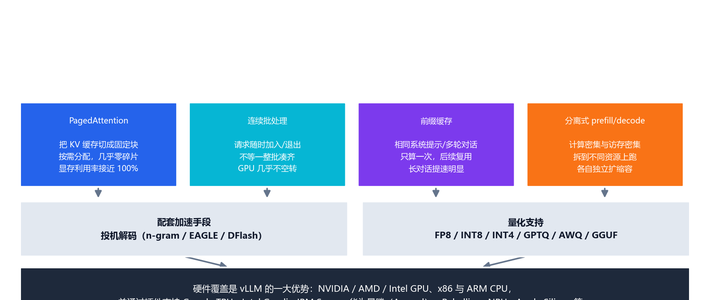
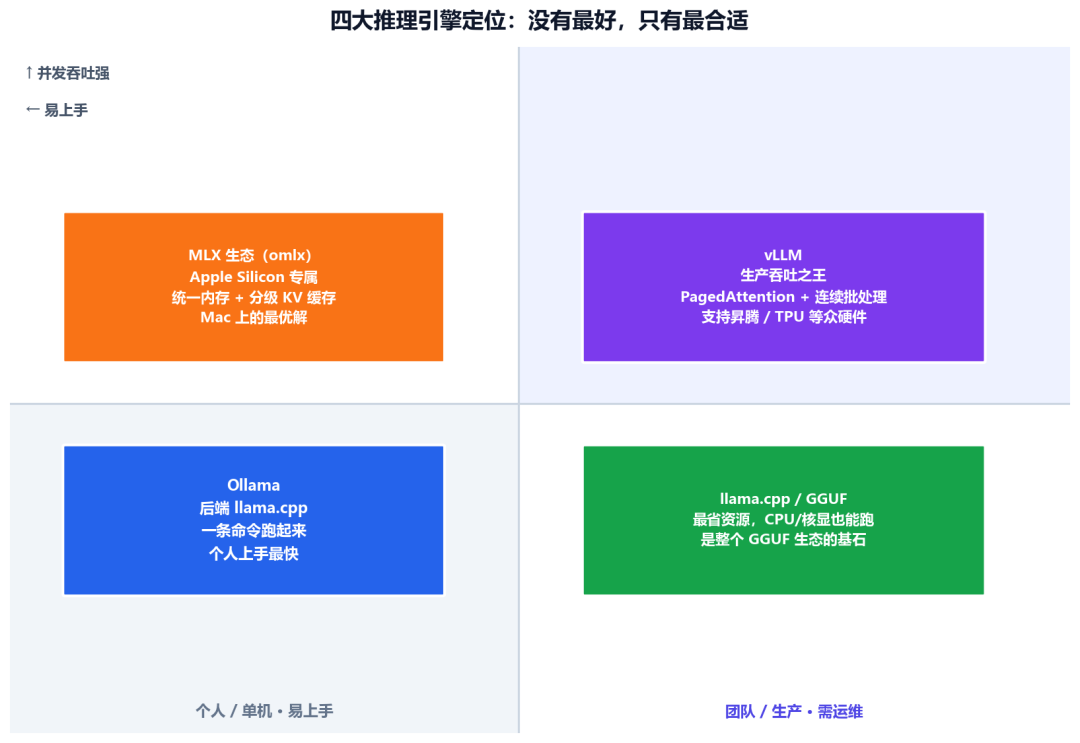
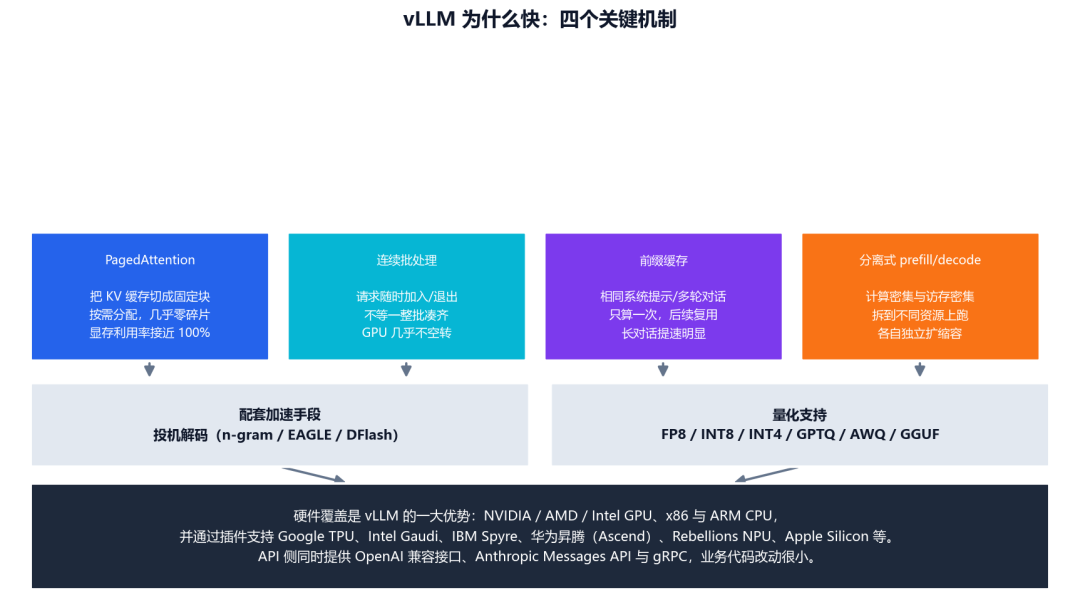
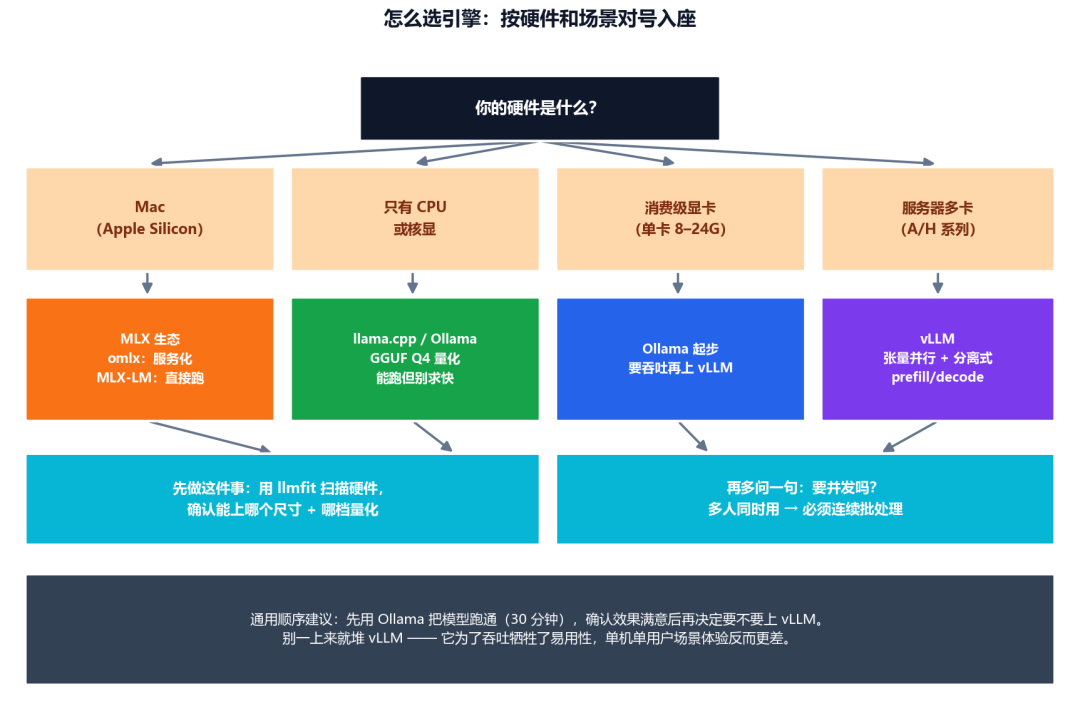
顺带把坐标系摆清楚:本地推理这摊子,入门封装有Ollama(约18万Star)、本地底座是llama.cpp(约12.8万Star)、Mac原生跑MLX、高并发服务交给vLLM。colibri一个不依赖Python、PyTorch、BLAS的新玩家,塞不进这四个象限里的任何一个格子——它要改的不是站位,是坐标轴本身。微博
能跑起来的不是魔法,是算术
MoE的稀疏激活就是那张"地道图":744B的GLM-5.2每个token只激活约40B参数,占总量5%。注意力、共享专家、嵌入这些每个token都要用的Dense部分约17B,int4量化后常驻内存只要9.9GB;剩下的约两万个专家(75层MoE、每层256个、平均每个19MB)全躺在NVMe上,路由选中了才读上来。代价是冷解码每个token要从盘里拉约11GB——所以这条路的性能天花板写在硬盘上,不在显卡上。知乎
作者的工程活是三件:Router-Lookahead预取(相邻层路由路径有71.6%的可预测性,磁盘读取和矩阵计算并行)、学习型缓存(用.coLi_usage记录你实际用到的热专家钉进内存,越用越快)、每层LRU再白捡一层系统page cache。 配套还有MLA把KV压到每token约576个值(约为传统方案的1/57),MTP推测解码把每次前向的产出拉到2.2–2.8个token。README的态度诚实得罕见:内存不够只降速,绝不偷偷降级——语义不打折。知乎知乎
全网实测数字放一起,才知道"跑通"和"能用"差几层
colibri开发者机器(WSL2、12核、25GB内存、虚拟盘):冷启动0.05–0.1 token/s;缓存预热+MTP后能站上1 token/s,M5 Max上测到1.06。知乎
RTX 3060位博主实测:约0.44 token/s,他的结论很诚实。
slotstream(125B的Qwen3.8-Flash-Next流进16GB内存的Mac):48GB机器热解码约12 tok/s,16GB档标称估计约4,基础款Mac mini M2实测量只有1.41 tok/s——瓶颈不是芯片,是硬盘。 293星的小仓库,但README数字给得克制;哔哩哔哩
Edge0-35B-A3B-preview:把35B MoE的完整专家权重放SSD按需流式加载,M4 Max上原版能100+ tok/s,SSD卸载后约15;官方靠Prerouter预路由找回最高+59%解码吞吐,再用Recover-LoRA补量化损失,代价是基准平均还差约3.9分。哔哩哔哩
参照系:今年5月fastllm就有"8G显存+高速盘(读速约7GB/s)跑229B"的帖子,标题就叫"意外地还挺流畅"。 这条老帖站内收藏1538——社区对"慢但自由"的容忍度,比厂商想的高;哔哩哔哩
同一逻辑的高配版:小红书那篇科普帖引的社区实测更狠——约200GB的Engram/哈希表卸载到NVMe,4张RTX Pro上跑出300+ TPS,峰值系统内存压在32GB以下。小红书
引擎侧同题:vLLM也已把DeepSeek-V4的共享专家纳入MegaMoE、支持解码KV卸载。
一句话总结这波:SSD流式改变的是"能不能跑"的答案——门槛从显存容量搬到了存储带宽;它不改变"够不够用"——对话级吞吐,它现在给不了。
你该站哪一派:按用途分,不按硬件分
适合立刻抄作业的:
内网涉密/数据不能出域——纯C零依赖意味着没有Python供应链可以投毒,全程离线攻击面极小,知乎那篇深拆文把这类场景排在colibri"真正合适的格子"第一位。知乎
夜跑批:翻译、回填语料、离线评估、给小模型攒蒸馏数据。慢是真的,但权重是你的,电费也是你的;
"持有智能"派——tombkeeper三月那句老话在这个节点重新成立。 colibri把这份自由的入场价从"十万级GPU池"打到"25GB内存+一块大容量快盘"。微博
别抄的:
想要对话助手、Agent、代码补全——0.44~1.06 tok/s的打字速度,对面屏幕比你先超时。这条路上27B的GGUF照样得看显存表,没有新剧情;
高并发真实流量——vLLM+GPU集群仍是唯一正解,colibri自己的定位里碰都不碰这个格子;CPU+GPU混合想跑大MoE,KTransformers才是成熟方案;
预算三万、想要"前沿模型对话速度"的人——B站那条"96G显存魔改版RTX5090面世?不到3万块?!"的视频,两天里156条评论吵的就是这个选择。 判断很简单:瓶颈是"装不下",SSD已经替你开门;瓶颈是"不够快",这波帮不了你,继续等卡或者老老实实付API钱。哔哩哔哩
把这几条路线画在同一张地图上,就是按你的硬件现状选引擎的那张决策图——而"硬盘当内存用",是这张图外头这周刚开的第五个入口。
避坑四个细节,和接下来值得盯的信号
坑1:模型容器必须用gs64,README警告老版int4镜像质量差约9个百分点,正是早期"思考停不下来"的元凶。 另外,坑2:MTP头必须int8,用int4草稿接受率会崩到0–4%,下载页那个int4-with-int8-mtp的命名就是为这个;坑3:边界都写在README里——Qwen3.8-Flash-Next目前只支持CPU、不支持GPU,DeepSeek V4分支明确写着不支持语法约束、投机解码默认也是关的。 另外,slotstream只跑Apple Silicon且只支持它那一个模型;Edge0还是preview。坑4:磁盘预算别抠——GLM-5.2要372GB起步留余量,Kimi K3是1.6TB级别;站内商品库里1TB级NVMe的到手价在286元到1139元这个区间,和"不到3万"的魔改卡差一个数量级,但放得下只是入场资格,顺序读速才是速度杠杆,colibri甚至留了双SSD镜像模式:两块盘各放一份、读带宽翻倍,中途拔盘只降级不崩溃。知乎知乎
接下来盯四件事:colibri"多机磁盘拼专家池"和WebGPU worker的落地节奏;177B通过SSD卸载51B查找表跑进RTX 3060这条Engram路线会不会扩散到更多模型;Edge0的"+59%对-3.9分"有没有人独立复测;以及——如果这三件事都成了,明年此刻等卡党聊的就不是"要不要买5090",而是"哪块盘的读速配得上我的模型"了。
地道已经挖到墙根。跑不跑得起,从今天起是硬盘的问题;快不快,还是那个老问题。