









28
36
谷歌 Gemini 4 正式发布!对比 GPT-6 和 Claude,谁更强?
2026-10-14 22:08:19
0点赞
0收藏
0评论
AppOS科技快讯:始于 Mac,却远不止于 Mac。点击上方蓝字关注,跟随 AppOS一起探索更广阔的数字生活。
10 月 13 日,Google 正式发布新一代旗舰 AI 模型 Gemini 4 Argon,并宣布向全球用户开放。
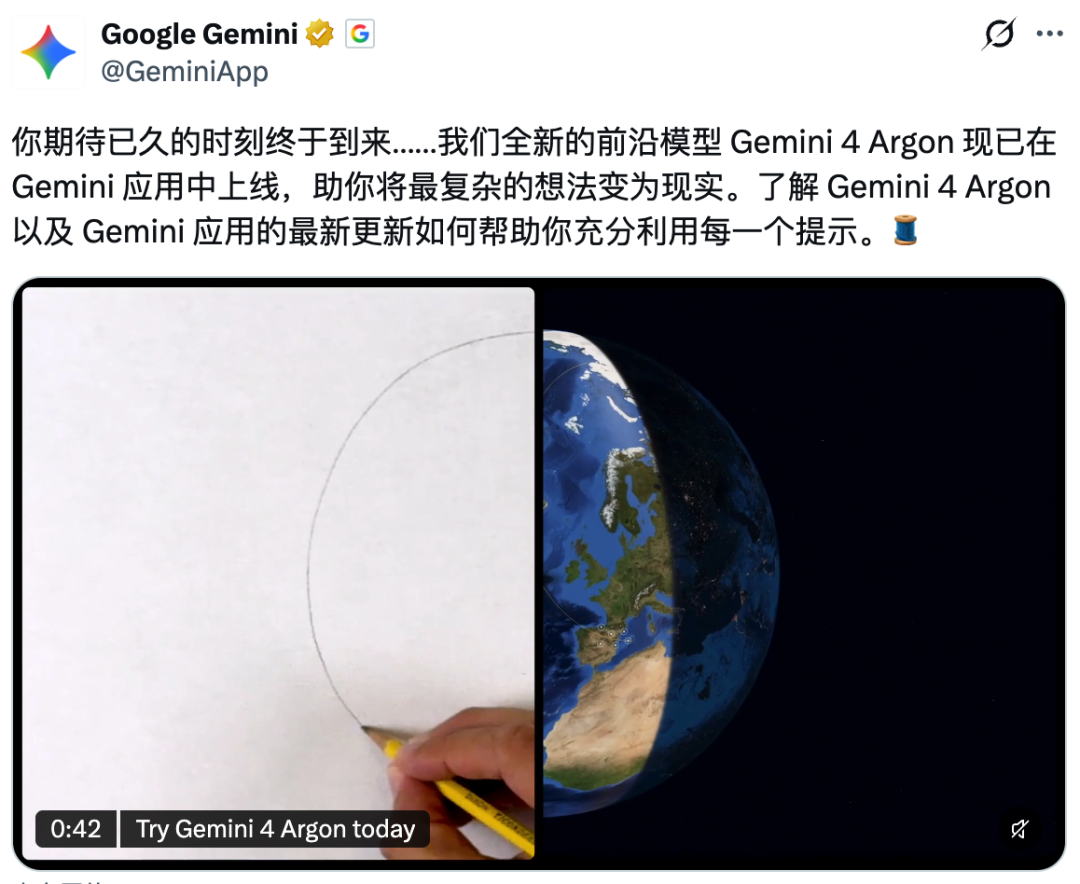
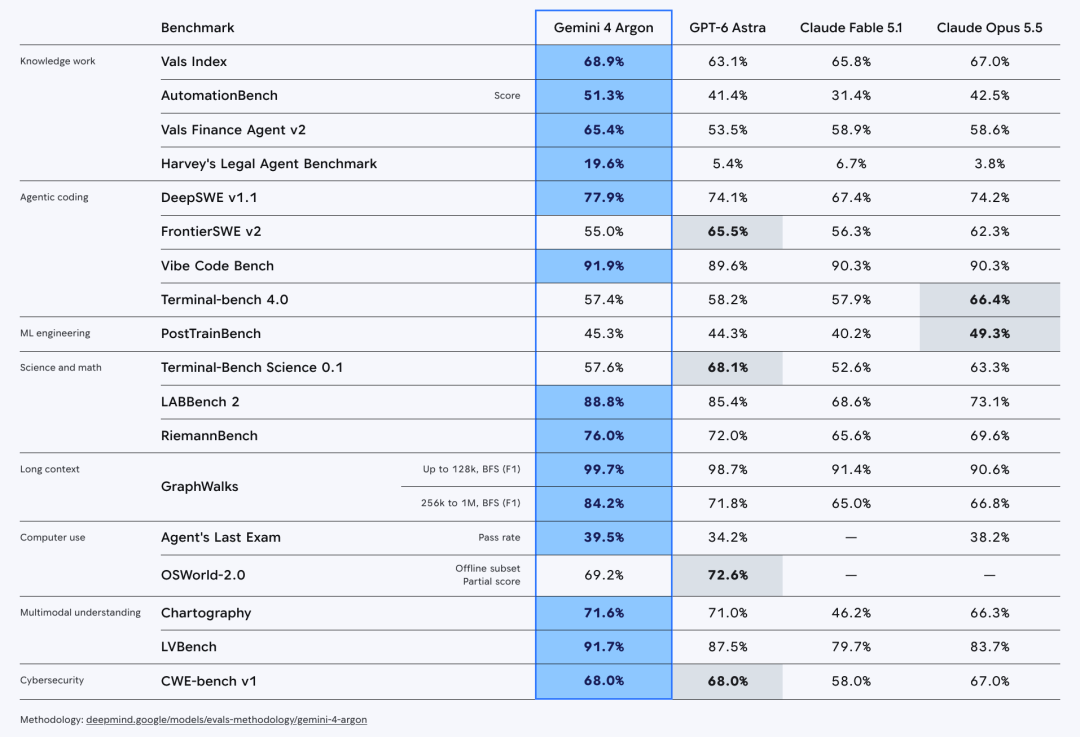
Google 新一代旗舰 AI 模型 Gemini 4 Argon 已经正式上线。按照 Google 公布的成绩,它在 19 项基准测试中拿下了 13 项第一,另外还有一项并列第一,涵盖编程、科学研究、长文本理解以及自动化任务等多个领域。
Gemini 4 的实际表现究竟怎么样?这次我们整理了 Artificial Analysis、Arena、Vals AI 等第三方机构的跑分,以及 X 上多位开发者的实际测试结果,看看 Google 这次交出的成绩单到底有多少含金量。
01 跑分很强,但还不是第一
首先来看大家最关心的模型性能。
知名 AI 模型评测机构 Artificial Analysis 已经公布了 Gemini 4 Argon 的测试成绩。在最新的 Intelligence Index v4.3.2 综合智能指数中,Gemini 4 Argon(High)取得 53 分,与 GPT-6 Astra(Max)持平,高于 GPT-6.1 Sol(Max)的 52 分。
不过,Anthropic 的 Claude Opus 5.5 最高档位取得了 58 分,仍然领先 Gemini 4 Argon。
 Image
这里比较的是各模型对应的高性能推理档位,而非所有模型在相同计算预算下的结果。
另外,在 Arena 发布时公布的榜单中,Gemini 4 Argon 以 1525 分登上 Text Arena 文本榜第一名。
 Image
02 编程能力提升明显
作为此次发布的重点,Google 花了很大篇幅展示 Gemini 4 Argon 的编程能力。
根据官方公布的成绩,它在 DeepSWE v1.1 软件工程测试中取得 77.9%,超过 GPT-6 Astra 的 74.1% 和 Claude Opus 5.5 的 74.2%。
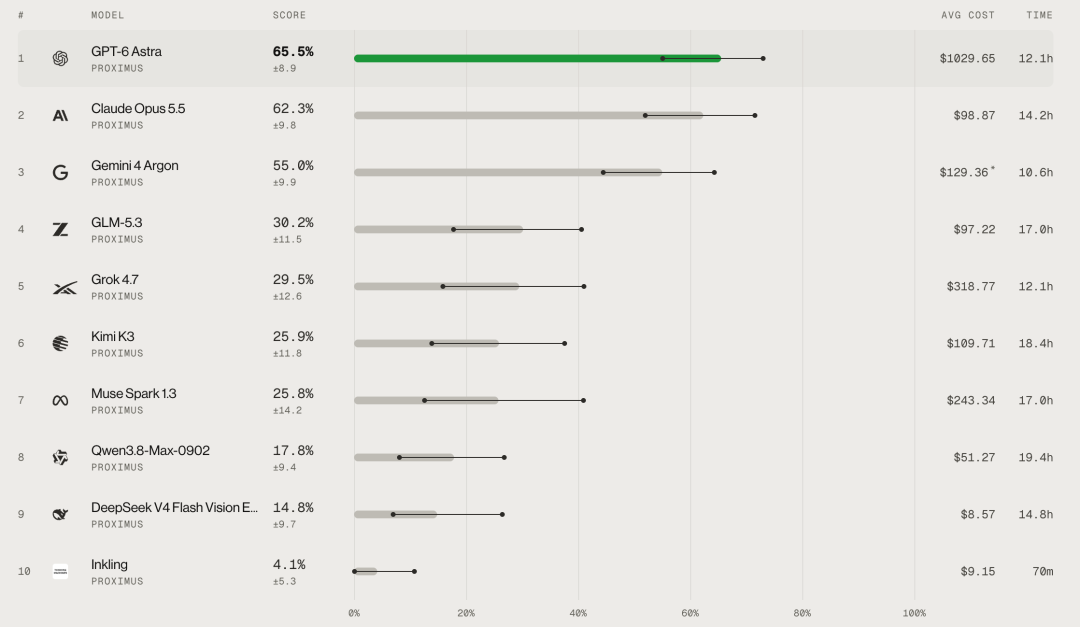
不过,在更加复杂的工程任务中,结果有所不同。独立评测机构 FrontierSWE 的数据显示,Gemini 4 Argon 在 FrontierSWE v2 测试中获得 55.0%,排名第三,落后于 GPT-6 Astra 的 65.5% 和 Claude Opus 5.5 的 62.3%。
在 Vals AI 的 Vibe Code Bench 测试中,Gemini 4 以 91.91% 的成绩位居第二,表现依然出色。

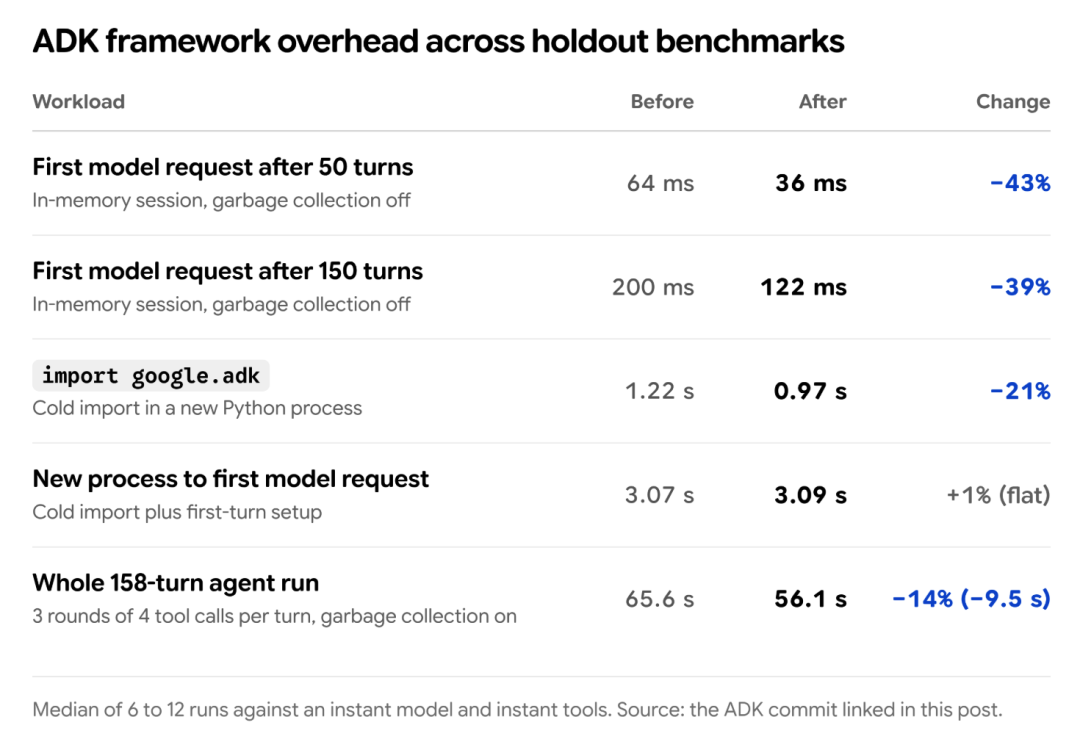
Google 还让 Gemini 4 Argon 优化一个约 20 万行代码的 Python 项目。经过 11 小时的自动化执行,AI 提出了 6 项优化方案,其中 2 项通过人工审查并被采用,使部分长会话处理开销降低约 40%,软件包导入速度提升 21%。
整体来看,Gemini 4 Argon 的编程能力已经进入行业第一梯队,尤其擅长代码生成和应用开发,但在复杂工程任务的稳定性方面,仍有进一步提升的空间。
03 网页设计与 3D 建模,表现令人惊喜
除了编程,Gemini 4 Argon 在网页设计与 3D 建模方面也有明显进步。Google 官方展示了一项相当惊艳的案例:只需提供一张真实桌面的照片,AI 就能借助 Blender、Three.js 等工具,将桌面物品转换成可交互的 3D 赛车游戏。 此外,它还能自动生成复杂的建筑模型、交互动画以及游戏场景。
开发者 Jazii 使用相同提示词,让 Gemini 4 Argon 和 Claude Opus 5.5 制作像素风格的奇幻城市,最终两者生成效果接近,但 Gemini 4 耗时 13 分钟,Claude 则需要 15 分钟。

科技投资人 Justine Moore 分享了一项有意思的测试。她让 Gemini 4 Argon 制作一个展示苹果电脑发展历史的交互式网站,没有提供任何图片或数据素材,AI 便自行搜集了历代 Mac 的照片与产品参数,并制作出具有 3D Cover Flow 效果的交互式展厅。 网站界面还能随着浏览年代的变化自动切换风格,整体完成度相当不错。
而在更具参考价值的 Arena 网页开发排行榜中,Gemini 4 Argon 暂列 第 8 名,仍落后于 Claude Opus 5.5 和 GPT-6 Astra。
 Image
总体来看,Gemini 4 在 3D 场景生成和交互原型开发方面展现了很强的潜力,但在网页设计的整体质量和稳定性上,还谈不上全面领先。
04 幻觉率大幅降低
相比编程,Gemini 4 在另一个方面的提升或许更加实用,那就是减少 AI 胡编乱造的问题。
根据 Artificial Analysis 公布的 AA-Omniscience 测试,Gemini 4 Argon 的幻觉率仅为 15%,而 GPT-6 Astra 为 51%,GPT-6.1 Sol 则为 54%。

05 更便宜,但也更能消耗 Token
除了模型能力,Gemini 4 Argon 的 API 定价也相当有竞争力。
按照 Google 目前公布的价格,每百万输入 Token 为 2 美元,输出 Token 为 10 美元。不过,这属于限时优惠,12 月 1 日起价格将分别上涨至 4 美元和 20 美元。

Artificial Analysis 的测试数据显示,在当前优惠价格下,Gemini 4 Argon 完成一项综合智能指数测试任务的平均成本约为 1.99 美元,而 GPT-6 Astra 约为 3.26 美元。
在取得相同综合指数成绩的情况下,Gemini 4 当前的任务成本只有 GPT-6 Astra 的约 61%。
Gemini 4 在测试过程中消耗的输出 Token 明显更多。Artificial Analysis 测得,它平均每项任务使用约 6.2 万个输出 Token,而 GPT-6 Astra 约为 2.7 万个。
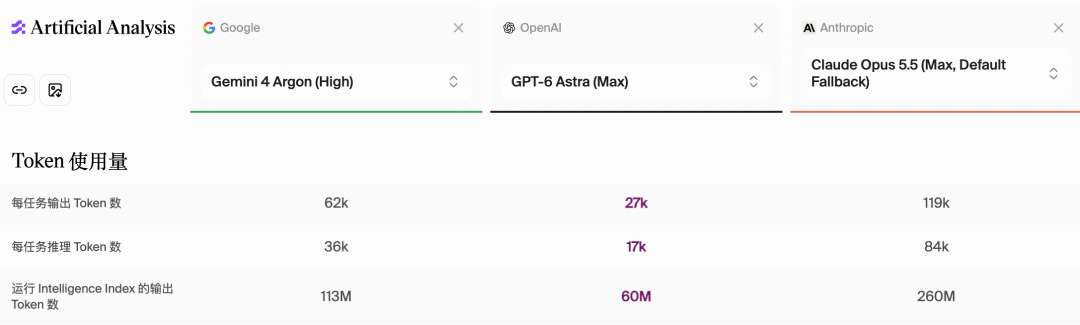
所以,Gemini 4 的成本优势主要来自更低的 Token 单价,而不是模型本身更节省 Token。
一旦优惠结束,按照相同测试消耗估算,Gemini 4 的平均任务成本将上涨至约 3.98 美元,反而高于 GPT-6 Astra。
写在最后
从首批测评来看,Gemini 4 Argon 的整体表现确实不错,尤其是在长文本理解、专业知识工作和降低幻觉方面,展现出了很强的竞争力。不过,跑分领先并不代表实际体验一定更好,在复杂编程、网页开发等任务中,GPT-6 和 Claude 依然有各自的优势。
价格方面,除了 Google 官方订阅,目前部分第三方 AI 聚合平台也提供了相对便宜的会员方案,对于只是想尝鲜的用户来说,体验门槛并不高。当然,选择时仍需注意实际模型版本、使用额度及数据隐私等问题。
对于普通用户而言,其实没必要过分纠结 AI 排行榜上的名次。不同模型都有自己的优势,谁能以更低的成本、更稳定地完成实际工作,谁就更值得选择。
点击**名片 关注 AppOS
更多有趣资讯我们下期见~