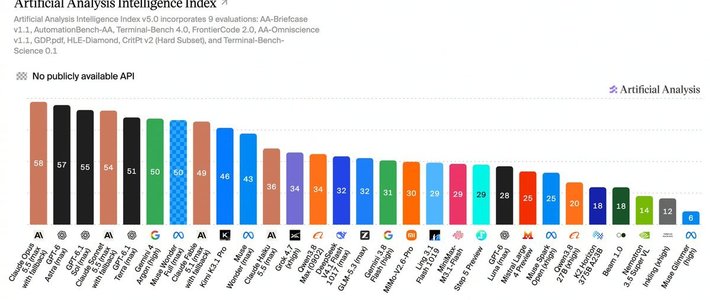
10 月 28 日,第三方评测机构 Artificial Analysis 发布了智能指数新版 v5.0,这是该机构自 2026 年 1 月 v4 上线以来幅度最大的一次基准重构。 上周还在流传“开源追平闭源只差 3 分”:旧版 v4.3 上,Kimi K3.1 Pro 拿了 55 分、全球第 4,只落后 Claude Opus 5.5 三分。 新榜上,开源榜首 Kimi K3.1 Pro 得分 46,与头名的差距从 3 分拉大到 12 分。 差距拉大的原因,主要不是开源退步,而是尺子变了——v5 把更多分量压给了长时程、需要验收的“工程活”,这正是开源模型相对闭源吃亏的地方。IT之家知乎微博
六成权重进了私有题:先变的是尺子
最直接的变化是,60% 的评测权重首次建立在私有测试集或隐藏答案之上,压缩公开题库被训练数据“污染”的空间,同时砍掉了各厂商“为了跑分而跑分”的注水项目。 类别权重也从 Agents 30%、Coding 20%、General 30%、科学推理 20% 调整为四类各占 25%,即使各单项原始分不变,总指数也会因权重重排而变化。IT之家知乎
新加的考题恰好戳中长程执行。Terminal-Bench-Science 的 70 项任务要求模型在终端里完成真实科研工作流,每项任务的全部测试通过才得分——v5 官方结果中,榜首也只有 63%,多数已测开放权重模型低于 10%,而它占了 15% 权重。 AA 这次还把 Cognition 出品的 FrontierCode 2.0 纳入评测,有人注意到“现在 GPT 又杀回来了”。 这项考试看的不是“函数写没写对”,而是修好指定 bug 的同时有没有漏改同类问题、有没有补回归测试,命中关键阻塞项直接计零分;它目前的开源模型最高成绩是 DeepSeek V4.1 Flash 1017。知乎微博IT之家
读这张榜,先分清两个口径
v5 上拿 46 分的 Kimi K3.1 Pro 目前只开放了 API,完整权重承诺在 11 月 4 日前放出。 真正已放出权重、可下载可审计的模型里,v5 最高分只有 32——DeepSeek V4.1 Flash 1017 的 max 档与 GLM-5.3 的 max 档并列。换句话说,按“能调 API”算,开源与头名差 12 分;按“拿到权重自己跑”算,差距还要再大一截。知乎微博
更要紧的是,新科头名根本不在普通人的选项里:59 分登顶的 Gemini 4 Carbon 领先 Claude Opus 5.5(58 分)与 GPT-6 Astra(57 分),但它走的是“防御方先行”发布——先只给一小批网络安全团队,再经谷歌的 Fairwind 计划扩至关键基建机构,需申请、需背景审查,普通人和一般公司暂时进不去。 今天普通人付费用得到的头部,仍是 Opus 5.5 和 GPT-6 Astra。知乎微博
尺子本身也有争议
私有题库是把双刃剑:它堵住了“刷熟人题”的空间,也让外部用户无从复现和核验。v5 上线当天,就有用户在“智能指数更新 v5”的问题下留言,调侃“每次更新都对openai有利”。 更要留心的前提是:量尺整根换过之后,旧榜的 55 分和新榜的 46 分本来就不可直接比——榜单在这个节点只宜当参考,不宜当判决书。知乎
普通用户怎么选:先问自己用模型干什么
日常问答、写作、翻译、整理材料,不必因为换榜改选。 开源 API 价格明显更低,有报道口径约为头部闭源的五分之一左右,还能本地部署、数据不出门;v5 拉开的分差集中在长程执行类考题,单步任务上的实际体验差距远没有总分显得那么大。知乎
如果你的用法是让 agent 连跑几小时流程、改整个代码仓库、做自动化测试,v5 显示的差距是真的。 闭源旗舰的溢价,买的正是“交付物少返工”。想留在这条路线上的开源方案,盯两个信号:一是 11 月 4 日 Kimi 权重放出后社区的本地复测成绩,二是后续榜单里开源模型在 FrontierCode 2.0、Terminal-Bench-Science 上的单项分数——这两项比总分的爬升更有信息量。
最可靠的办法还是老办法:把闭源旗舰和开源候选各接进自己真实的活儿里并跑一两周,统计的不是“回答像不像样”,而是“结果需要人返工的频率”。v5 这把新尺子想量的,其实就是这个。