刷到一个说法:“智谱实现了RSI,AI开始自己训练下一代自己”。先把结论放这:官方报告只认领了一半,而且认领的那一半,比标题党那一半更关系到你的钱包。
我把9月17日Z.ai的技术报告《How GLM Built Its Own Inference Infrastructure》、唐杰随后发的《通往递归自我改进》、9月28日知乎"好评笔记"的逐段核对、Anthropic的测量报告,以及智谱9月13日那份50亿美元融资公告拼完,这篇只讲三件事:循环里到底哪一圈转起来了、哪一圈还空着、以及转起来的部分什么时候能便宜到你手上。
先对数字:这份"战报"到底写了什么
GLM-5.3驱动的InfraAgent(基础设施智能体),参与了GLM-5.3-Flash推理服务的搭建和优化;
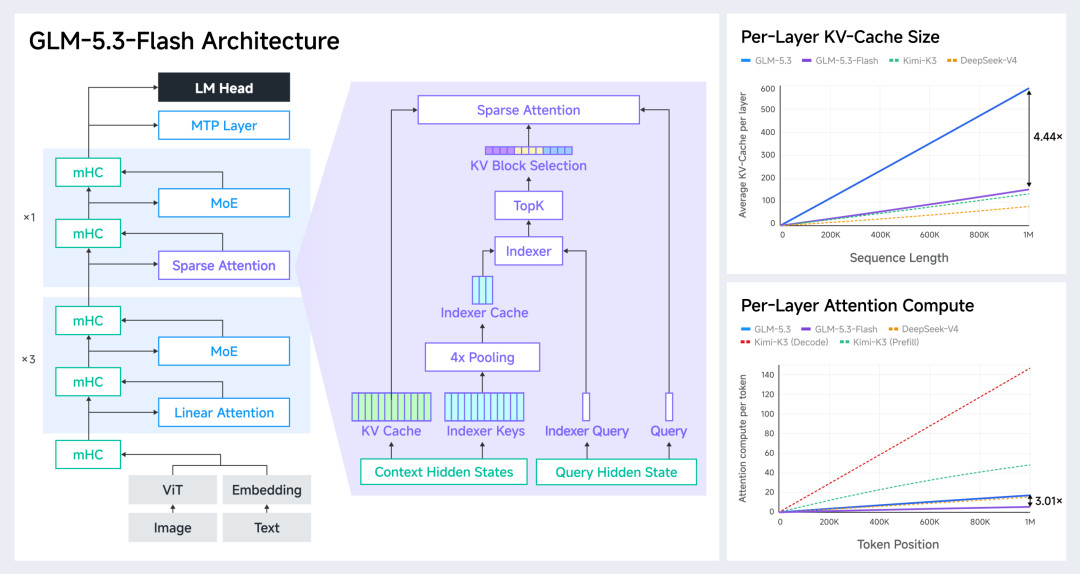
这套服务跑在超过10万张国产AI加速卡上,Z.ai称此前没人把这个规模的国产卡集群跑过同类部署;要在这上面适配新模型架构、支持100万token上下文、还要吃下多模态请求,配套软件不少内核缺支持,很多运行行为只能边做边查;
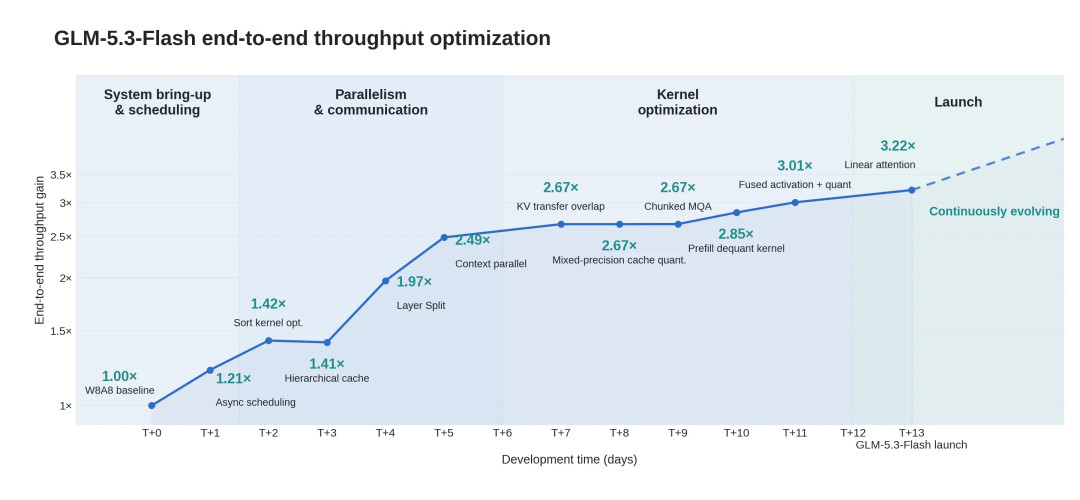
从第一次跑通到承接全部线上流量,用了不到两周;端到端吞吐量做到初始W8A8基线的约3倍。36氪
服务上线时先用匿名模型名"Ox-Alpha"挂在OpenCode和OpenRouter上,一周内成了这两个平台使用量最高的模型,6天处理超过62万亿token。 智谱官方9月18日也认了:Ox-Alpha就是GLM-5.3-Flash。知乎新浪微博
报告称每token成本和硬件利用率达到与主流NVIDIA GPU相当的水平——但注意,逐款卡的对照配置表没有公开。
还有个容易被划过去的小细节:团队自述,GLM-4.7之前用自家模型写代码多少有点"支持自家产品"的意思,到GLM-5.3,自家模型已经是团队的日常编码助手。 内部工具变成日用,这比任何发布会数据都更能说明问题。知乎
唐杰的三块拼图:让循环转起来的不是智能
这是全场最容易读歪的一句话。唐杰(智谱首席科学家)在社交媒体上的原话是,智谱已经实现了最小的闭环:模型优化系统,系统服务模型。 他对递归自我改进的理解恰恰和多数标题相反:凑齐闭环靠的不是模型变聪明,而是"可被改进的对象+一个便宜又硬的裁判+一个能自我供给的回路"这三块拼图。再聪明的模型,没人告诉它上一步对不对,跑几年也在原地打转。36氪
这次真正闭合的是第一块:模型碰不到自己的权重,但能优化服务自己的推理系统——kernel、并行策略、通信、内存、调度。 唐杰的比喻是把咖啡机搬到你工位旁边:活还是那些活,但你不用来回走了。36氪
报告里三个案例,全是一线工程师看了会点头的具体活:
KV传输卡壳:传菜的门只有一把钥匙,师傅炒菜把钥匙揣兜里——底层DeepEP节点内路径没显式释放GIL,负责传输的Python线程抢不到锁,本该和计算重叠的传输被调度堵住。修完,"带传输的Prefill"和"纯Prefill"的差距从超20%压回1%以内。
精度漂移:tf32为了快把小数位砍半,状态矩阵链式合并一路传一路丢,序列越长走样越明显;改成tf32x3后,这个修复还被合回了FlashLinearAttention上游(PR #1180)。
解码kernel:发现FP32归一化和门控被沿V维重复算了四遍,合并进同一线程块、中间结果常驻寄存器,提速1.71倍。
空着的是第二、三块:裁判得便宜、快、能客观裁决,而"吞吐掉了20%"这种端到端信号既贵又说不坏在哪——这就是强化学习里稀疏奖励和信用分配的老问题:往往要端到端全部跑完才拿到一个好坏信号,归因不到具体哪一步。 干过这行的老师傅一小时定位的问题,模型得端到端跑几个小时才知道对不对。智谱的做法是把老师傅"说不清但管用"的直觉拆成分层验证接口:正确性反馈(算对了吗)、系统行为反馈(时间花在哪了)、性能反馈(哪个方案在什么条件下更好)。36氪
这个循环,最终怎么走到你的钱包
链路其实很短:推理更便宜→同样的预算能匀出更多算力给训练→下一代模型站在更稳的台阶上→发布和降价的节奏都变快。
对照着看最近的动作就明白了:9月13日公告的50亿美元融资(约20亿配售+30亿可转债),资金用途白纸黑字写着"下一代GLM模型、完全自训练体系及相关算力基础设施"。 36氪援引公告的口径更具体:约60%的所得款项净额将投入下一代GLM基础模型和"完全自训练"体系的研发。 9月16日的会议纪要里,管理层喊出2026年底ARR 30亿美元的目标(年初是0.67亿)。 股价从2980港元跌到现在的两折,市场那本账我之前已经拆过,这里不重复——但资本和工程这两条线在"自训练"上交汇,这是9月这两周真正的新东西。新浪微博36氪新浪微博
智谱官方给"完全自训练"下的定义,几乎就是这套飞轮的说明书:模型在上一代GLM搭建的环境中递归训练,形成自我改进闭环。36氪
至于用户端:你现在118元档、免费额度、3.5折API用着的GLM-5.3-Flash,本身就是这套自优化闭环的第一件产品。它便宜,不是补贴烧出来的便宜,是这套"模型给自己干活"的infra省出来的。Artificial Analysis 8月底那张被大量转发的智能-成本散点图说得更直白:GLM-5.3-Flash(折后)单任务成本约0.045美元、智能分57,贴着Claude Opus 5、GPT-5.6所在的性能前沿——能力在前沿带里,价格掉了一个数量级。红利也在加速兑现成产品:9月18日智谱官方宣布推出GLM-5.3-FlashX,最高推理速度200 tokens/s,并明确建立在10万张国产芯片的推理算力之上。 速度翻5倍,定价也提升至原版的2.5倍——便宜管饱是一档,花钱买快是另一档,分层定价从此摆上明面。 9月22日界面快报援引的数据:GLM-5.3-Flash调用量增长73%。新浪微博新浪微博界面新闻
Anthropic的三块仪表盘:怎么判断它转到哪一步了
与其吵"是不是奇点",不如看Anthropic《衡量前沿实验室内部AI的发展速度》给的量法,它提出三个维度:AI承担了多少研发(用Epoch AI的AL0到AL5标尺)、Agent受到什么监督、算力在研发和安全之间怎么分配。按它自己披露:截至今年8月,Claude已在人的监督下"主导"了26%的模型研发工作,2月还不到1%。36氪
同一份报告里另两个数:内部平台随时约3万个Agent在干活,2026年8月超过十亿次决策里只有0.002%被拦下。 但Anthropic也承认,这些数据只能自己报自己,跨实验室没有统一口径。所以判断标准可以给所有GLM用户抄下来:下次谁说"AI自训练",别看形容词,看三个数——AI研发主导占比、异常拦截率、安全算力分配比例。Z.ai自己也在报告里写了边界:目标、边界和风险判断仍由工程师负责,完整的递归自我改进尚未实现。36氪知乎
现在各自该干什么
GLM-5.3/Flash日用党:成本红利已经吃到,该用用,不用为"要不要等6.0"焦虑——闭环只转到第一块拼图,下一代不会有玄学跳变。
准备续订阅/囤额度的:盯两个可验证信号再决定——GLM-5.4/5.5会不会从9月25日泄露的站点地图变成正式公告;官方哪天补上逐款GPU的对照数据。新浪微博
做Infra的同学:先被蒸馏的不是"会写代码的人",是"跑实验跑一天的人"。报告替代的是等待和试错,判断和验收还在人手里——这句话有原文背书,不是安慰。
看到"递归爆发"想冲的:现在的"自训练"是工程降本,不是权重进化。谁把这两件事混着讲,谁就是把你当流量。