

多模态模型正从感知与生成走向行动决策、工具协作和专业诊断;世界模型热潮也提醒行业重新审视技术兑现速度。
视觉决策模型进入低延迟行动环
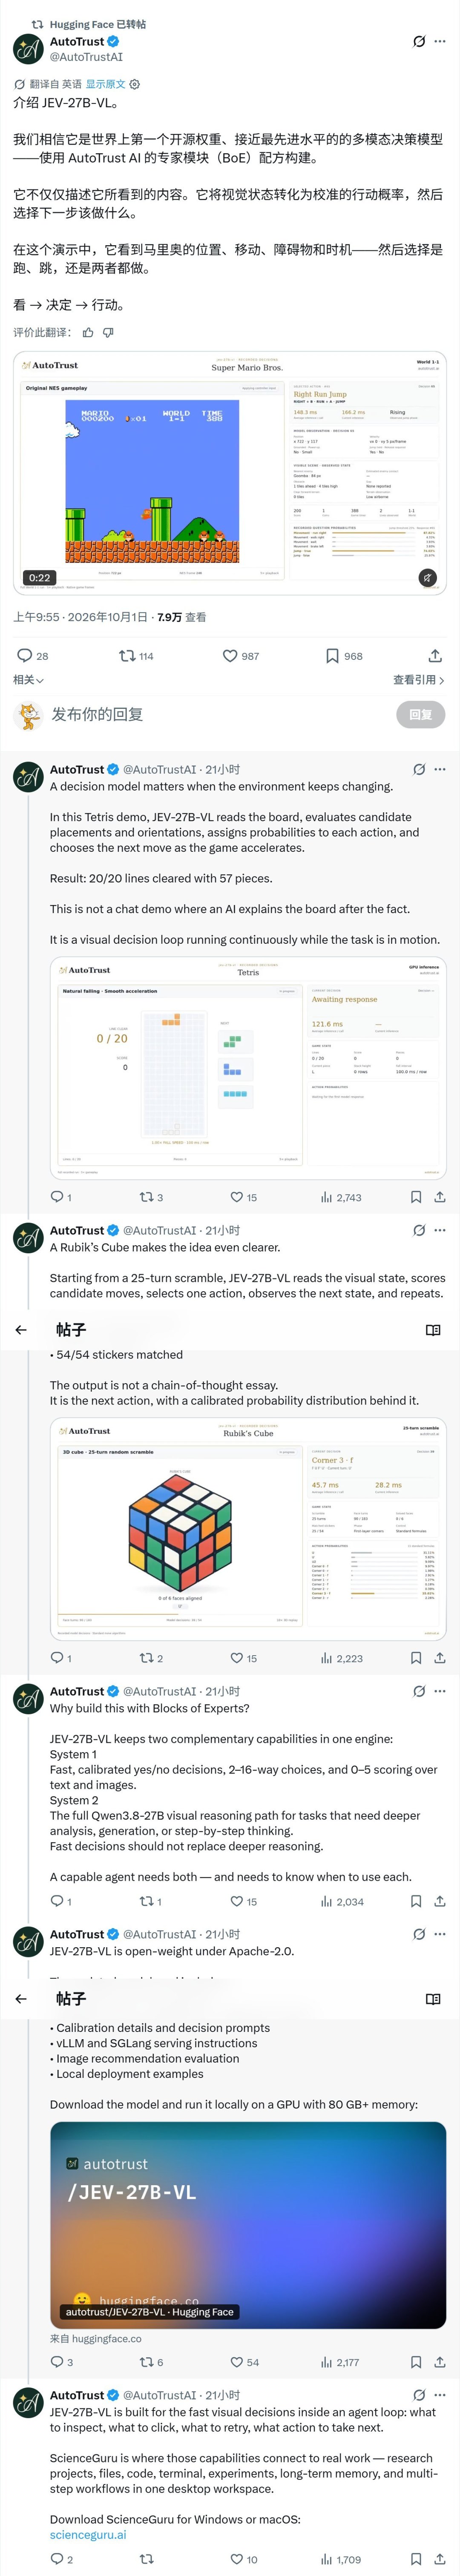
JEV-27B-VL与Cloudflare Clef都把重点从“描述所见”转向为候选行动直接打分,并兼顾视觉输入。它们为游戏操作、威胁分析和工单路由等高频智能体任务提供了新的模型形态,但具体效果仍需结合官方基准与真实部署验证。
视频生成Agent学会调用工具自我校验
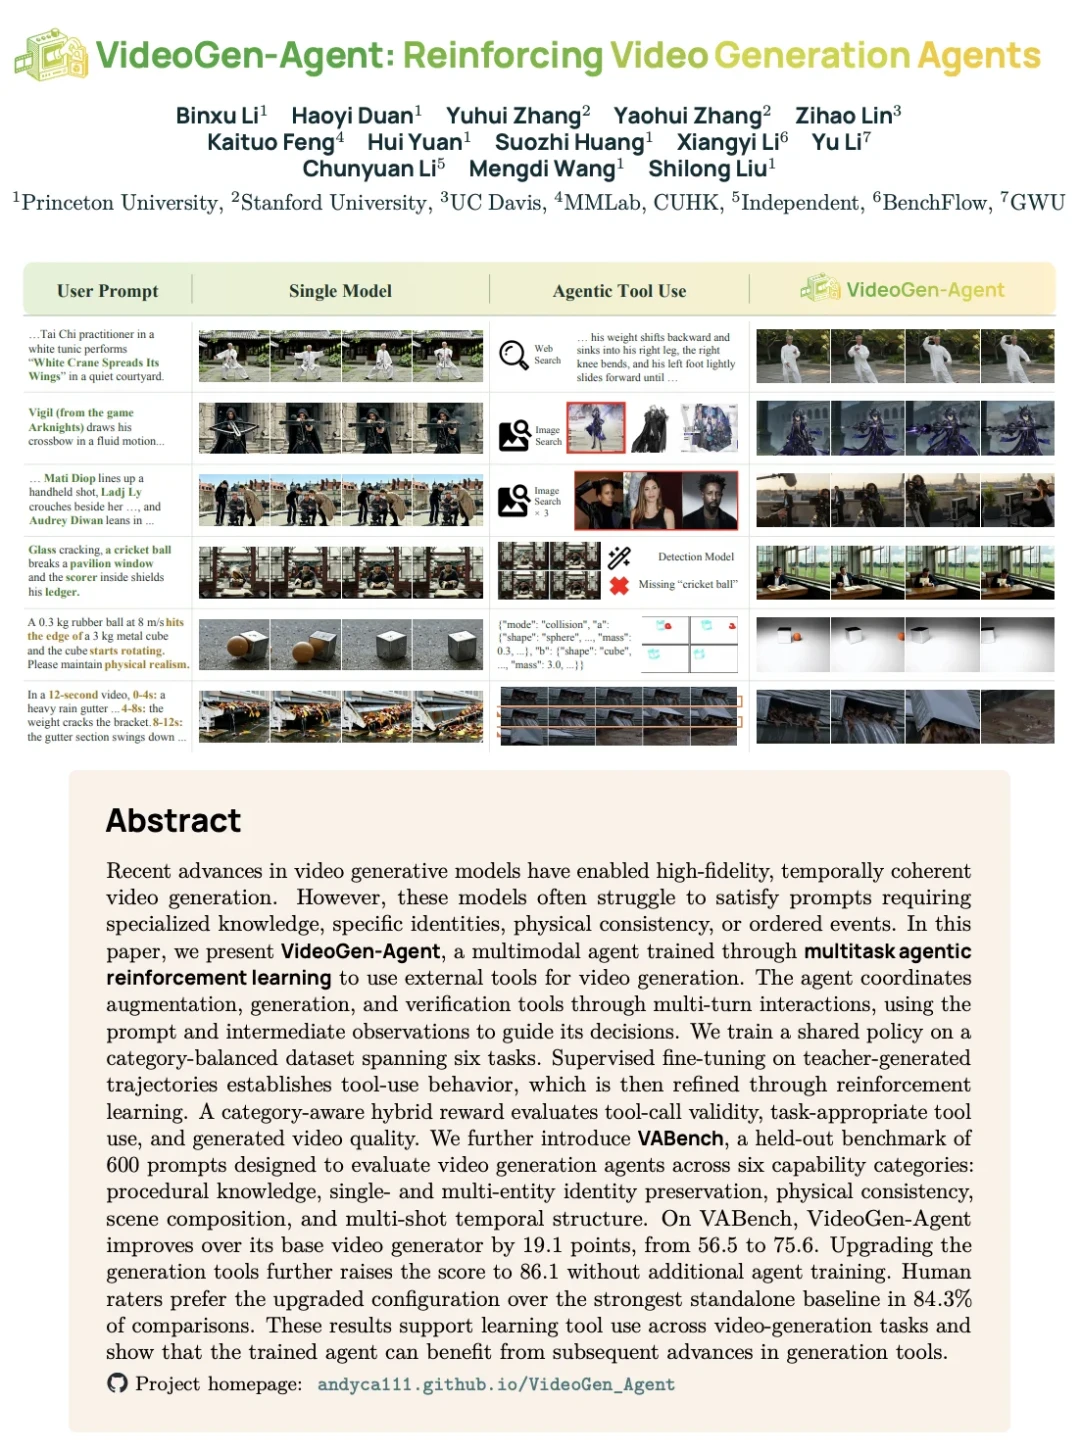
VideoGen-Agent通过多任务智能体强化学习协调提示增强、视频生成与验证工具,并用VABench评估身份保持、物理一致性和多镜头结构。它适合关注视频模型如何从单次生成转向迭代工作流的研究者与创作者。
多模态医疗Agent强调专科工具与证据链
AgentEYE把影像分流、眼底与B超专科模型、证据检索和大模型推理串成可审计流程。研究结果显示专科影像工具是主要增益来源,为医疗多模态系统的工程分工与可信验证提供了参考。
视频模型加速转向世界模型叙事
国内AI视频公司正更多使用“通用世界模型”定位,资本与产业动作同步升温。对行业观察者而言,关键不只是生成画质,而是模型能否稳定理解物理规律、支持实时交互并形成可持续产品。


当前文章无评论,是时候发表评论了