

你现在家里照片管理如果是这个状态:
- 手机里一份
- 微信聊天里一堆压缩图
- iCloud(或其他云盘)又一份
- NAS 里还有“最终版”
那你遇到的问题不是“容量不够”,而是操作不变功能不全。真正难受的是:
1) 找图慢;
2) 备份链条不闭环;
3) 换平台迁移成本高。
这篇直接给你一套可落地方案:Immich + Docker Compose,并且把你关心的重点讲透:
- 如何启用机器学习识别人脸与场景;
- 展示参考配置: i3-10100 / 16G / 1TB SSD 上怎么配更稳;
- 哪些参数可以照抄,哪些不要乱改。
展示适用环境:Ubuntu 22.04 LTS、Intel i3-10100、16GB DDR4、1TB SSD、Docker Compose。
一、先说结论:Immich 的“识别能力”怎么来的?
很多人会问:要不要接 OpenAI / GPT 才能识别人脸和场景?
答案:不需要。
Immich 的识别能力来自它自己的 immich-machine-learning 服务(本地视觉模型),不是把你的照片丢给外部对话大模型。
你要的两个能力分别是:
- 人脸识别:按人物聚合相册;
- 智能场景检索(Smart Search):比如搜“海边、狗、日落、草地”等语义关键词。
对家庭私有相册来说,这种本地模型路线有三个好处:
1) 隐私边界更清晰;
2) 长期成本更可控;
3) 不依赖公网 API 稳定性。
为什么采用视觉模型而不是通用大模型?
视觉模型是“专用工具”,大模型是“通用工具”。在 Immich 这种高频图像索引场景,专用工具更快、更省、更稳、更安全,更易于后期维护,私密性更高。
二、你的硬件能不能跑?
这套参考配置(i3-10100 + 16G + SSD)可以跑通并长期使用,但要注意一个现实:
- 首次全量识别(尤其是历史照片很多时)会比较吃 CPU;
- 机器学习任务建议放到低峰(夜间)跑;
- 先跑“稳定可用”,再追“极限性能”。
别上来就卷高并发,不然风扇和噪音会先教育你。
CPU可用性说明:
最低可用:2C/4T(能跑,但慢,可用)
实用起步1:4C/4T(能跑,好多了,可用)
实用起步2:4C/8T(推荐,快速,可用)
舒适档:6C/12T 以上(首次全量建索引快很多)
高图库建议:8C/16T 或加 GPU(几十万图时明显更稳)
三、推荐目录规划(后续维护不乱)
shell命令
sudo mkdir -p /opt/immich
sudo mkdir -p /data/immich/library
sudo mkdir -p /data/immich/postgres
sudo mkdir -p /data/immich/model-cache
sudo mkdir -p /data/immich/backups
sudo chown -R $USER:$USER /opt/immich /data/immich
说明:
- /opt/immich:放 compose 与 .env
- /data/immich/library:照片视频主库
- /data/immich/postgres:数据库数据
- /data/immich/model-cache:机器学习模型缓存
- /data/immich/backups:备份文件
四、可直接用的 Docker Compose(含 ML)
下面是家庭场景“先跑通”的稳定模板。
记得更改其中的用户名和密码!!!
yaml
version: "3.8"
services:
immich-server:
image: ghcr.io/immich-app/immich-server:release
container_name: immich_server
depends_on:
- immich-postgres
- redis
- immich-machine-learning
ports:
- "2283:2283"
environment:
TZ: Asia/Shanghai
DB_HOSTNAME: immich-postgres
DB_USERNAME: postgres
DB_PASSWORD: immichpass
DB_DATABASE_NAME: immich
REDIS_HOSTNAME: redis
IMMICH_MACHINE_LEARNING_URL: http://immich-machine-learning:3003
volumes:
- /data/immich/library:/usr/src/app/upload
restart: always
immich-machine-learning:
image: ghcr.io/immich-app/immich-machine-learning:release
container_name: immich_machine_learning
environment:
TZ: Asia/Shanghai
MACHINE_LEARNING_WORKERS: 1
MACHINE_LEARNING_REQUEST_THREADS: 2
MACHINE_LEARNING_MODEL_INTER_OP_THREADS: 1
MACHINE_LEARNING_MODEL_INTRA_OP_THREADS: 2
MACHINE_LEARNING_MODEL_TTL: 300
volumes:
- /data/immich/model-cache:/cache
restart: always
immich-postgres:
image: postgres:16
container_name: immich_postgres
environment:
POSTGRES_USER: postgres
POSTGRES_PASSWORD: immichpass
POSTGRES_DB: immich
volumes:
- /data/immich/postgres:/var/lib/postgresql/data
restart: always
redis:
image: redis:7
container_name: immich_redis
restart: always
启动:
shell命令
cd /opt/immich
docker compose up -d
访问:
在浏览器输入以下网址,记得替换你的服务器IP地址为你的实际IP地址。
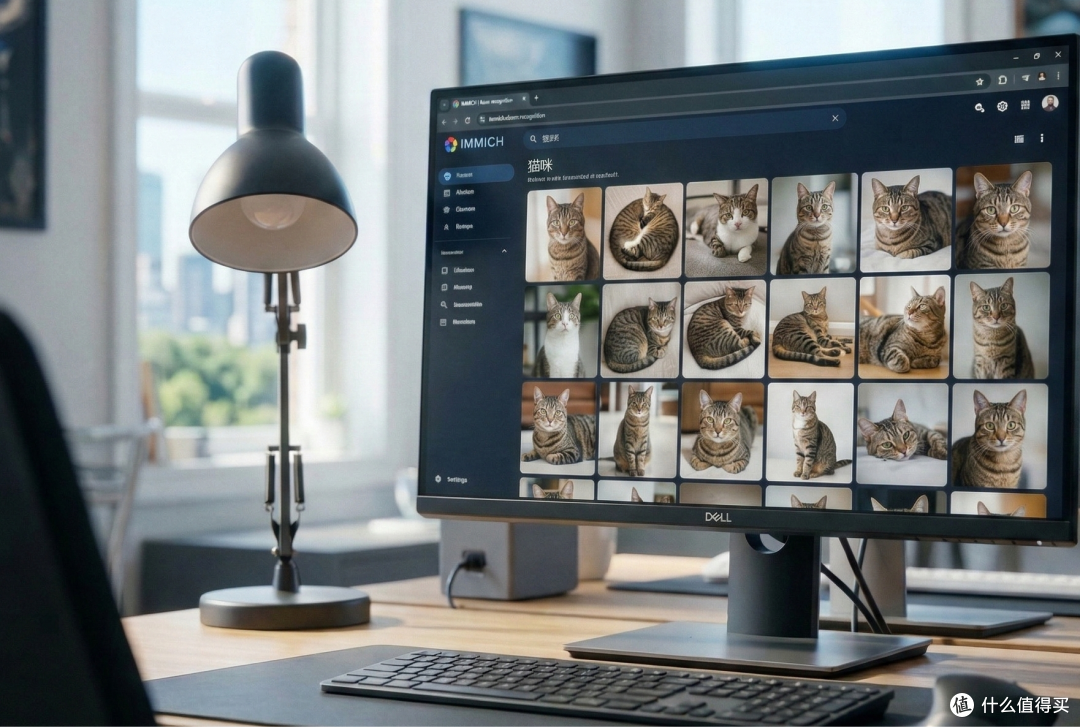
五、你关心的“具体模型”推荐(直接给结论)
先用这一套,稳定优先:
- 人脸识别模型:`buffalo_l`
- 场景语义检索模型(CLIP):`ViT-B-32__openai`
如果后续你觉得场景识别不够准,再升级:
- ViT-L-14__openai(更准,但更吃资源)
经验建议:先把默认中档跑通,别上来就拉满大模型。
文本语义搜索/场景搜索模型列表
ViT-SO400M-16-SigLIP2-384__webli
ViT-SO400M-14-SigLIP2-378__webli
ViT-gopt-16-SigLIP2-384__webli
ViT-SO400M-16-SigLIP2-512__webli
ViT-H-14-378-quickgelu__dfn5b
ViT-L-16-SigLIP2-512__webli
ViT-SO400M-16-SigLIP2-256__webli
ViT-SO400M-14-SigLIP2__webli
ViT-gopt-16-SigLIP2-256__webli
ViT-L-16-SigLIP2-384__webli
ViT-H-14-quickgelu__dfn5b
ViT-L-16-SigLIP2-256__webli
ViT-B-16-SigLIP2__webli
ViT-SO400M-14-SigLIP-384__webli
ViT-L-16-SigLIP-384__webli
ViT-L-16-SigLIP-256__webli
ViT-B-16-SigLIP-512__webli
nllb-clip-large-siglip__v1
nllb-clip-large-siglip__mrl
ViT-B-16-SigLIP-384__webli
ViT-L-14-quickgelu__dfn2b
XLM-Roberta-Large-ViT-H-14__frozen_laion5b_s13b_b90k
ViT-H-14__laion2b-s32b-b79k
ViT-B-32-SigLIP2-256__webli
六、后台配置路径(避免“装好了但没识别”)
很多人部署成功后说“怎么没识别人脸”,根因是没开任务。
管理员登录 Immich Web 后台后,按顺序做:
1. Settings / Machine Learning
- 开启人脸检测/识别
- 开启 Smart Search
2. Administration / Jobs
手动触发一次全量任务:
- 人脸检测相关作业
- 人脸特征提取/聚合作业
- 智能搜索(向量)作业
3. 等待索引完成
- 照片多时会比较久
- 建议夜间执行
七、如何验证“识别已经生效”
你可以用这三条快速验收:
1. 人物聚类是否出现
- People 页面能看到自动分组
2. 场景关键词能否命中
- 搜索关键词示例:
dog / beach / sunset / car /日出 / 旅游 /汽车 /美食 /笑脸 /二维码 /电脑
3. 机器学习容器是否健康
shell 命令
docker logs -f immich_machine_learning
看有没有持续报错;首次下载模型会有下载日志,属正常。
八、性能调优(i3-10100 / 16G 实战基准)
1)并发别开太大
并发配置建议维持:
- WORKERS=1
- REQUEST_THREADS=2
先保证稳定,再加速。
2)模型缓存放 SSD
/data/immich/model-cache 放 SSD 会明显减少重复加载成本。
3)错峰跑作业
首次全量识别最重,放夜间跑,白天体验更平稳。
4)先跑 CPU,再考虑硬件加速
如果后续图量很大再评估 GPU/OpenVINO,不要先把系统复杂度拉爆。
九、常见坑位(提前避坑)
坑 1:缺少 machine-learning 服务
症状:照片能看,但人脸/场景搜索一直没有结果。
解法:确认 compose 里有 immich-machine-learning,且 server 已指向 IMMICH_MACHINE_LEARNING_URL。
坑 2:只重启没重建
你改了 .env 或 compose 关键参数后,只 restart 有时不生效。
解法:
shell命令
docker compose down
docker compose up -d
坑 3:数据库和媒体路径混乱
后续迁移时容易炸。
解法:从一开始就把库、DB、缓存分目录。
十、给家庭用户的最终建议
你如果是“先要稳定可用”的路线,照这个顺序做:
1. 按本文 compose 跑通;
2. 先用 buffalo_l + ViT-B-32__openai;
3. 夜间跑完首次全量识别;
4. 再考虑是否要提高精度档位。
别追求第一天就“最强”,长期稳定和可维护才是家庭相册方案的核心。
一句话总结:先跑通,再优化;先稳定,再提精度。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~
求教大佬:群晖docker compose安装,没开任何硬件加速,选择“XLM-Roberta-Large-Vit-B-16Plus”+“antelopev2”模型,其他正常(包括人脸识别也正常),但无法使用智能搜索(中英文搜索都不行)。 web界面报错:“错误 Failed to search smart (Immich Server Error)” immich_server日志: “Error: Machine learning request '{"clip":{"textual":{"modelName":"XLM-Roberta-Large-Vit-B-16Plus","options":{"language":"zh-CN"}}}}' failed for all URLs” immich_machine_learning日志,报错: “…… RuntimeException: [ONNXRuntimeError] : 6 : RUNTIME_EXCEPTION : Exception during initialization: filesystem error: cannot get file size: No such file or directory [/cache/clip/XLM-Roberta-Large-Vit-B-16Plus/textual /transformer.embeddings.word_embeddings.weight] ……” 不知哪里出了问题啊?
没有更多了