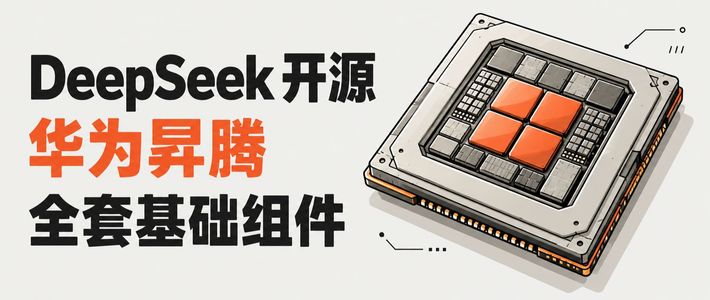
先给结论:DeepSeek与华为的联手,还没有把英伟达的CUDA"击穿",但绕开它的动作已经从口号变成了生产系统。"击穿"尚未发生,"旁路"正在进行。今年10月20日,DeepSeek开源大规模云服务推理框架DeepInfer,其支持硬件列表直接指定了NVIDIA SM100架构(英伟达最新的Blackwell系列)与华为昇腾950两个平台——昇腾第一次与英伟达旗舰GPU并列出现在原生支持名单里。官方口径显示,这套框架支撑着V4.1-Flash的生产服务,单一集群日吞吐155万亿Tokens,整体收入为每卡每小时38美金(按谷价计)。知乎DeepSeek
昇腾从"事后移植"变成"首日目标"
次序在过去半年被改写了。V4之前,行业惯例是DeepSeek先在英伟达平台上开发优化,华为工程师再把模型移植到自家芯片上。2026年4月发布的V4预览版,第一次把英伟达GPU和华为昇腾NPU放进同一个硬件框架,细粒度专家并行方案在两个平台分别完成验证。DeepTech深科技
9月30日,DeepSeek开源面向昇腾算力平台的六件基础设施组件,涵盖TileLang编译工具、计算库和分布式通信库,并特意强调所有组件与此前面向英伟达平台的开源版本逐一对应。换句话说,这次放出来的是生产级代码,不是演示Demo。数据猿知危
这些组件是一个前沿模型实验室训练主力时真正在用的东西,现在原样搬到了华为芯片上。美国研究机构SemiAnalysis在6月的评估中称,V4发布首日,只有CUDA和CANN两套软件栈提供了完整可用的支持。数据猿DeepTech深科技
CUDA的护城河,不是语言长出来的
从2006年推出算起,CUDA今年恰好二十年。黄仁勋在3月的GTC大会上用一组数字给它过了生日:全球600万开发者(英伟达自报数字)、数亿颗运行CUDA的GPU,外加数千种工具、编译器与库、开源领域数十万个公共项目。数据猿
另一组被券商研报援引的行业统计是:CUDA生态覆盖超过400个加速库、600个AI模型、3700个GPU加速应用,英伟达在服务器GPU市场的份额约97%。数据猿
真正的壁垒不在代码量,而在沉淀了二十年的工程决策:大学课程教的是CUDA,社区问答积累在CUDA,工程师数年攒下的调优经验无法随代码迁移。搬家搬走的不是行李,是整个的人才结构。
打法与"复刻一个CUDA"完全相反
两家选择的路线,是在算子编程这一层垫进一个可移植的中间语言,把"算子怎么写"和"在谁家的芯片上跑"拆开。TileLang由北京大学杨智课题组主导开发、2025年1月开源,用类Python语法写计算本身,线程绑定、内存布局、流水线调度交给编译器,同一份代码可以面向英伟达、AMD、苹果的GPU以及昇腾NPU。开发者第一次可以在不换写法的前提下,从英伟达平台迁到昇腾。知危
华为也在把自己改造成开发者熟悉的样子:2026年的开发者大会上,昇腾宣布开源800多个算子,对Triton和TileLang接口都做了兼容,对齐两千三百多个PyTorch API——不再要求开发者迁移过来。数据猿
英伟达也没有站着不动。2025年12月,黄仁勋宣布在CUDA中引入Tile架构,构建了让OpenAI的Triton直接编译到CUDA Tile IR的后端——挑战者的范式正在被收编进自家软件栈。三方争夺的其实是同一个位置:可移植算子层。数据猿
"击穿"还远,四个缺口没合上
第一个缺口在训练端。华为曾向路透社确认,V4的部分训练过程使用了昇腾芯片;但《金融时报》2025年8月报道,R1发布后DeepSeek曾尝试用昇腾训练下一代推理模型,因芯片稳定性不足,数月没能完成一次成功的训练,最终退回英伟达H20,只把昇腾用于推理。前沿模型的预训练至今没有完全跑在国产芯片上的公开实证。DeepTech深科技
第二个缺口是性能。得克萨斯大学达拉斯分校2026年7月的一项实证研究测试了22个Triton和TileLang内核,其中一个通过正确性检验的实现,比PyTorch基线慢了300倍以上。可移植语言不承诺性能,DeepSeek能把昇腾用到接近硬件上限,靠的是两家团队的深度联合调优,这个门槛普通团队够不到。数据猿
第三个缺口是全栈。TileLang只动了算子这一环,推理引擎、性能剖析、行业工具链仍是CUDA的腹地,CANN的文档与调试短板也只是缓解而非消失。连这次开源的DeepInfer,其KVCache管理与负载均衡组件也尚未完整开源。DeepSeek
第四个缺口在产能。媒体数据显示,华为计划在2026年交付约75万颗昇腾950PR,经性能折算相当于美国一周的AI芯片产量;彭博社9月报道,DeepSeek内蒙古数据中心计划部署至少16万颗昇腾950DT,知情人士称这批芯片暂无训练计划,进度取决于华为产能。V4-Pro的服务能力和降价承诺,都拴在昇腾950超节点的交付节奏上。DeepTech深科技
即便不"击穿",三件事已经变了
国产芯片最痛的问题从来不是单卡性能,而是每家自建一套生态、开发者为每颗芯片重写一版。现在TileLang同时跑在昇腾、摩尔线程MUSA、沐曦和算能TPU上,一个共享的算子层把碎片化的软件成本摊平了,DeepSeek把这份示范开源,等于给二线芯片厂商也指了一条接入路径。数据猿
芯模协同开始成为常态:智谱GLM-5.1发布当天上线华为云,据华为云披露在昇腾上实现层级MoE均衡、整体吞吐提升30%。数据猿
钱也在往同一个方向走。据证券时报报道,DeepSeek新一轮融资规模或达千亿元,投向包括基于国产算力的预训练——而此前国产算力从未真正进入前沿模型的预训练市场。数据猿
接下来该盯什么
全球市场里,CUDA的装机量、工具链和开发者积累在可预见的时间内没有等价替代物,这个判断不会因一条热榜改变。真正变化发生在门槛最低的那一侧:CUDA正从"所有道路的起点"变成"可选的后端之一",这个身份变化本身就是护城河的实质性收窄。护城河从来不是一天被填平的,生态锁定的溢价一旦松动,就很难再回去。数据猿
后续值得盯的,是三个可验证的信号:下一代前沿模型是否会为昇腾原生设计,而不是发布后再移植;昇腾950超节点能否按承诺批量交付、V4-Pro降价兑现;以及DeepSeek自研AI推理芯片的进度——这一项目已推进约一年,仍处于早期阶段。一家把成本算到每卡每小时的公司,从来不会只押注一家供应商。DeepTech深科技