把一份门店表丢给AI,让它写两千字分析、再配几张图。这是今年办公室里最常见的一次“偷懒”。
四款办公AI拿到的是同一份表、同一句提示词,交出来的东西却不像在回答同一个问题。
数据不复杂:5个现制饮品品牌,2026年1月到9月,4510条门店记录。
字段里有城市、城市线级,也有购物中心、校园、机场这些选址类型。
第一道坎是先把“记录”和“门店”分开,文笔还在其次。
同一家店会在不同月份反复出现。9月有942条记录,按品牌、门店名、地址去重后是940家;最大的品牌有353条记录,实际351家。
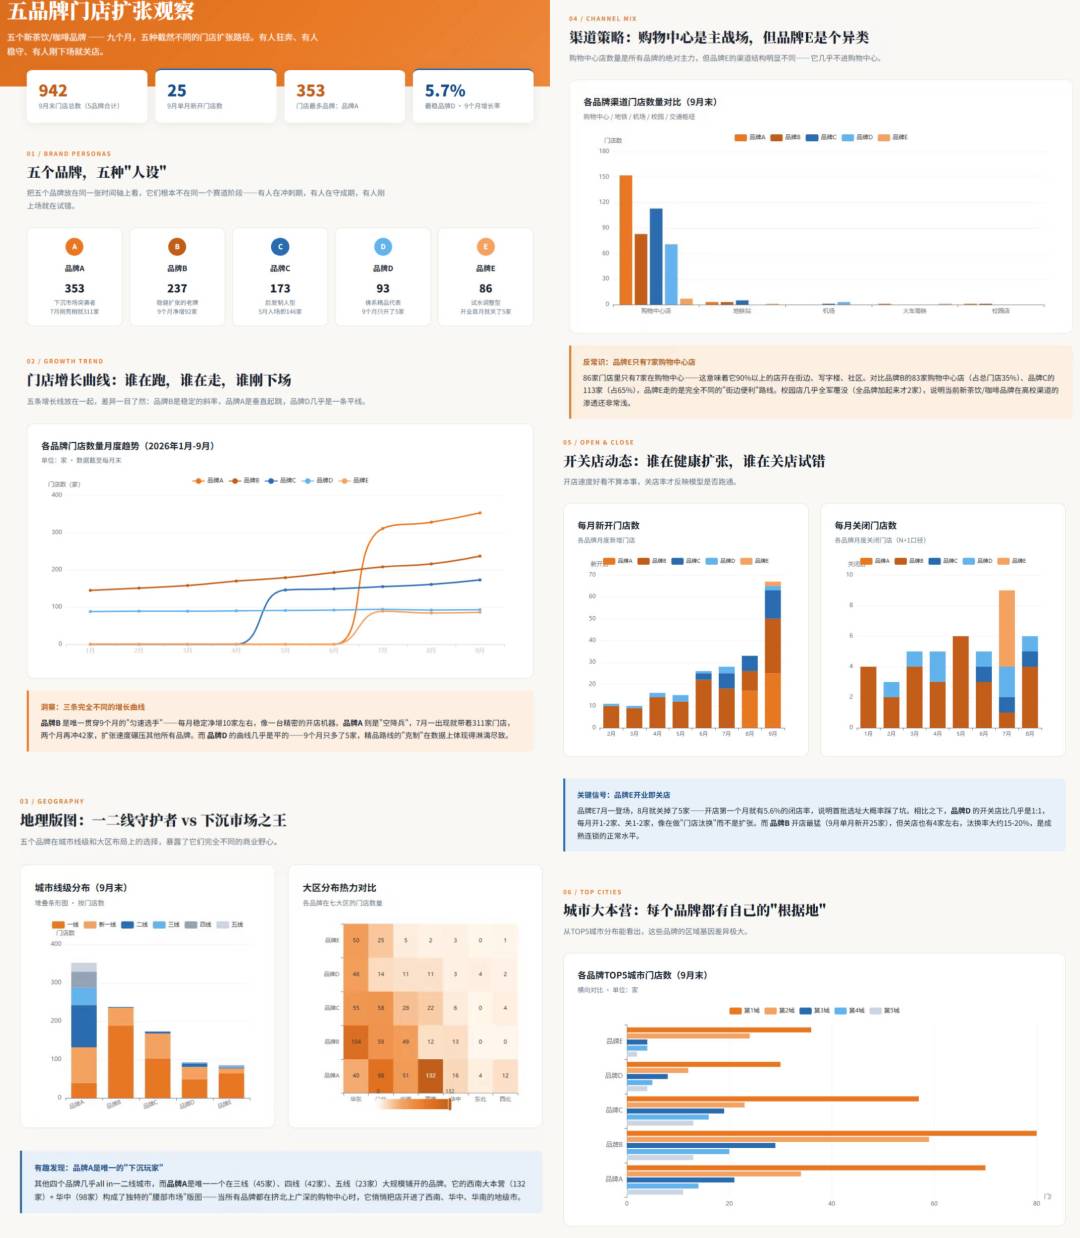
WorkBuddy是四款里唯一做了去重的。36氪
Kimi算对了月份,却把353条记录当成353家店,总数停在942;豆包也没主动去重。
千问更直接:某品牌3家机场店连续9个月产生27条记录,被写成“27家机场店”;另一个9月237家店的品牌,被写成有“700家购物中心店”。
到这一步,WorkBuddy像是赢了。可报告还要往下算占比。
某品牌351家店,152家开在购物中心,占比43.3%,WorkBuddy写成了约60%。36氪
另一个品牌173家店里113家在购物中心,实际65.3%,它写成约57%。
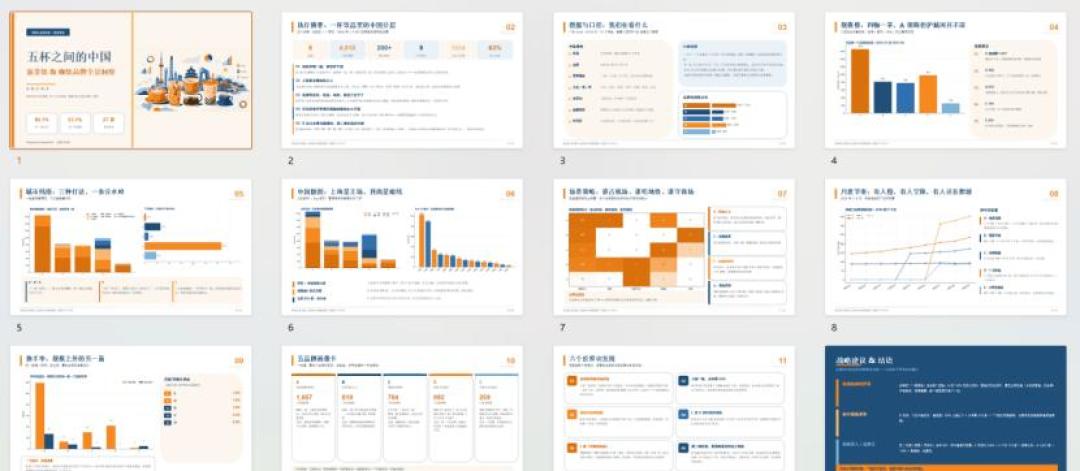
占比不是小数点的差别。43.3%和60%,会导向两个完全不同的开店结论。
审报告的人通常只看两页:总数和占比。总数对了,占比错了,前面的去重也白做。
Kimi的43.1%看着接近,分母用的却是没去重的353家;它还把两家校园店记成了零。
豆包的错在城市分级:某品牌四线城市门店多算一家,另一品牌两家二线城市门店被归进“三线及以下”。
四款产品里,唯一查出去重的那款,在下一步算占比时也没算对。生成报告和算对报告,中间隔着一整条流水线。
这只是一次任务,不能给四款产品下总评。但它暴露的顺序很典型:先去重,再算占比,最后才是排版。
再看交付形式,差别更大。
豆包交的是HTML单页,7组ECharts交互图表,趋势、城市线级、大区、渠道、开关店都覆盖,适合自己滚动着看,投屏时得不停找位置。
Kimi交9页PPT,图文比例最均衡,适合直接讲。
千问12页,模块齐,但不少该用图的地方还是文字。
WorkBuddy也交12页,单独放了“数据概览与方法说明”,还加了反常识发现页,思路清楚。
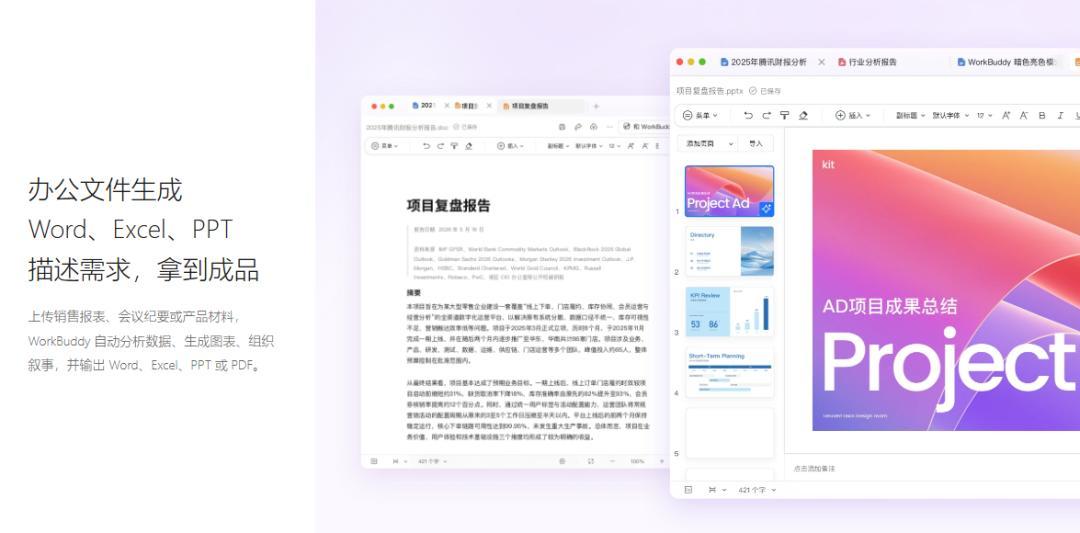
但它的图表多停在文字描述和示意,页面字很密,更像一份文档。
价格也摆在这里:Kimi 49元起,豆包68元,WorkBuddy 70元,千问78元;最高档分别到699元、500元、700元、158元。36氪
企业版里,WorkBuddy、千问、豆包都是198元/席/月,Kimi折合350元,还要年付、至少两席。
价格清楚,但一次任务到底烧多少积分,四家都没给出能直接换算的标尺。
市场数据是另一幅画面。
易观9月榜单里,WorkBuddy桌面端月访问8534万,接近第二名千问办公4655万的两倍;豆包工作3039万,TRAE 2712万,CodeBuddy 2588万,百度搭子926万排在第八。36氪
QuestMobile 7月的数据里,WorkBuddy PC端月活658.2万,月人均使用19次。36氪
它赢在下载即用、微信里能直接派活、模型可以换着选。这些都比“报告里少错一个数”更容易被感知。36氪
所以选办公AI,先别只看榜单:榜单量的是多少人打开它,不是它交出来的东西能不能直接用。
真要让它做数据报告,至少盯三处。
先让它报一行“原始记录数、去重后门店数、月份口径”;再做一次占比复算;最后按用途选交付格式——自己看选HTML,开会讲选PPT。
那场测试里,WorkBuddy唯一做对了去重,却在占比上栽了。
这个细节比8534万更有用:AI可以把最脏的活干了,但最后那一步核对,还是得留给人。