10月6日,OpenAI 在 GitHub 上一次性放出 722 篇数学手稿。按 OpenAI 的说法,模型尝试了约 4000 个问题,平均每项成果消耗的算力约相当于 ChatGPT Pro 思考三小时。发布次日,OpenAI 撤回了 3 篇预印本,修订 14 篇、更新 13 篇引用,手稿总数从 722 降到 719。更关键的缺口在验证:OpenAI 称约四成顶层结果附有 Lean 形式化,折算到论文层面是 162 篇,约占 22%;帝国理工学院数学家巴扎德抽样了自己领域的 30 篇数论论文,认为质量突出的只有 7 篇,通过 Lean 验证的只有 1 篇。钛媒体
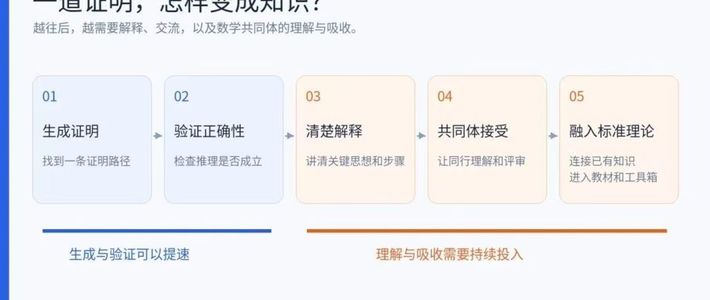
这就是这次冲击真正的位置。AI 把“生成证明”变便宜了,却没有把“确认证明”变得同样便宜;生成和确认之间,隔着一道越来越宽的沟。就在这批手稿发布前不到一个月,25位菲尔兹奖得主联合发表《人工智能在数学中的严重错位》,反对把解难题当作 AI 的能力基准。 他们担心的不是 AI 会不会做数学,而是数学共同体追求的理解,正在被“解出来”的数量挤到一边。中国新闻周刊
对数学学生来说,这意味着旧路径在松动。清华数学系教授薛金鑫把 10 月这批手稿称为“第四次数学危机”。他的判断是,崩掉的不是数学,而是数学界的信用体系:过去一篇论文要写一年,AI 可能一小时就完成;当证明的供给突然变得无限,“我解出了一道难题”就不再自动等于“我有价值”。知乎
但危机也把新的稀缺环节暴露出来。最直接的是验证。能生成 722 篇手稿的模型,只有 162 篇的主结论过了 Lean;会读、会查、会把自然语言证明翻译成机器可检验形式的人,比会多写一篇证明的人更缺。薛金鑫在清华上课时跟学生说,现在布置的任何作业题都可以让 AI 直接生成答案;但那样做,你获得不了任何理解,期末考试还是不会。把 AI 当助手、自己先想、卡住再问的人,学习效率反而更高。
更稳的用法是:先自己写,哪怕写得很丑;再让 AI 找漏洞、给反例、换一条路;最后用 Lean 之类的形式化工具检查关键步骤。这不是把 AI 当敌人,而是把它放在“生成”那一端,把“判断”留在自己这一端。
另一件被低估的事是表达。3Blue1Brown 在 10 月的视频里说,现在入坑数学正是最好时机。 他给学生的建议很具体:沟通更重要,练好口头表达;约上好友散个长步,想想自己为什么爱数学。哔哩哔哩
这个建议听起来软,但和验证缺口是同一件事:当机器能快速写出证明,人要把证明读懂、讲清、接受追问,才能让它变成共同体可以使用的知识。3Blue1Brown 甚至说,教学可能是最安全的岗位,因为人需要人来讲。微博
更根本的是选题。薛金鑫的建议不是“数学没用了”,而是把锚点挪回现实。他举陈省身的例子:从 Gauss-Bonnet 定理出发,一路走到陈类,几十年后在拓扑绝缘体里派上用场。这条路径里没有“解猜想、发四大、拿经费”的桥段,但它是活的。选方向时,别只问“这个问题够不够难、够不够有名”,也问“我能不能说清它为什么值得被回答”。
钛媒体在复盘这次事件时写了一句很准的话:发现可以外包,品味与判断力暂时不能。 这句话可以直接当作选方向的准则。钛媒体
所以,学数学的学生现在要调整什么?不是赶紧转码,也不是学会几句提示词。是把力气从“解出来”挪到验证、表达和选题:自己能画出第一张草图,再让 AI 来挑错;能把看懂的东西讲给别人听;能判断哪个问题值得被回答。中间那段——把证明写出来——AI 会做得比你快,这件事不用再争了。
薛金鑫在文章最后留给年轻学生一句话:没有任何人或者机器可以代替自己的思考。 这话放在 722 篇手稿之后,不像口号,更像一份操作说明。知乎