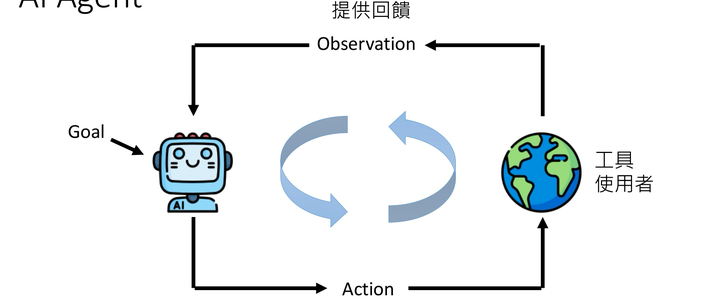
让Agent完成一次任务,早就不是难事了。真正难的是让它持续、稳定地交付结果——这是不少一线团队复盘后的共识。demo里一切顺滑,一进生产就各种翻车,很多团队的第一反应是换模型、堆提示词、加护栏。但更常见的卡点其实藏在更前面:没人说得清“成功”是什么,也没法验证一次改动到底有没有用。微博知乎
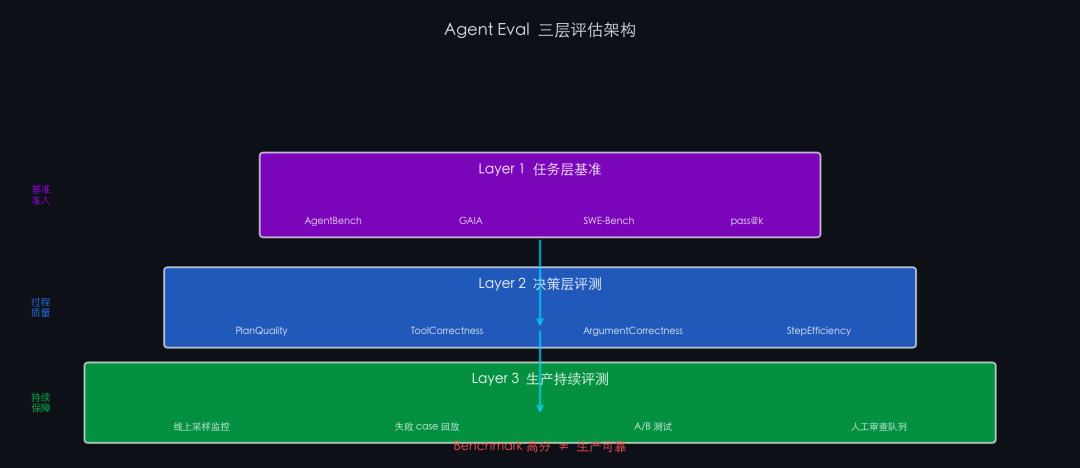
知乎上关于Agent落地效果不佳的讨论里,有一条一线评论把这一点说得很直白:大部分团队没定义清楚什么叫成功,自然不知道该怎么改进。没有评测(Evals),你连“这版提示词比上一版好”都答不出来,修不修、怎么修全靠体感。知乎
托管评测平台这条路,至少OpenAI自己没走通。OpenAI今年6月宣布弃用Evals评测平台。存量评测10月31日起转只读,11月30日平台整体关停。连OpenAI都印证了:托管评测没有成为一门持续的生意。这不是说评测不重要,恰恰相反——评测不是平台的附赠品,是你自己的工程资产。知乎
那评测该怎么起步?先泼一盆冷水:别一上来就搭评测平台。有测试工程师复盘过自己的经历:平台做出来了,实际工作中不一定有人用;反而Trace、日志、数据集、断言这些基础能力可能天天都用得上。平台应该服务于成熟的评测流程,流程成熟之前不必先建平台。知乎
起步只需要三样东西:
第一,一小撮真实case。不用一百条,从线上badcase里抽二三十条,脱敏后固定下来就行。100条人工凭空生成的Query,往往不如30条真实用户样本值钱。记住分三份:调优用的、固定回归用的、独立验证用的,混在一起会自欺欺人——对着同一批case反复改提示词,通过率涨了,泛化能力没涨。知乎
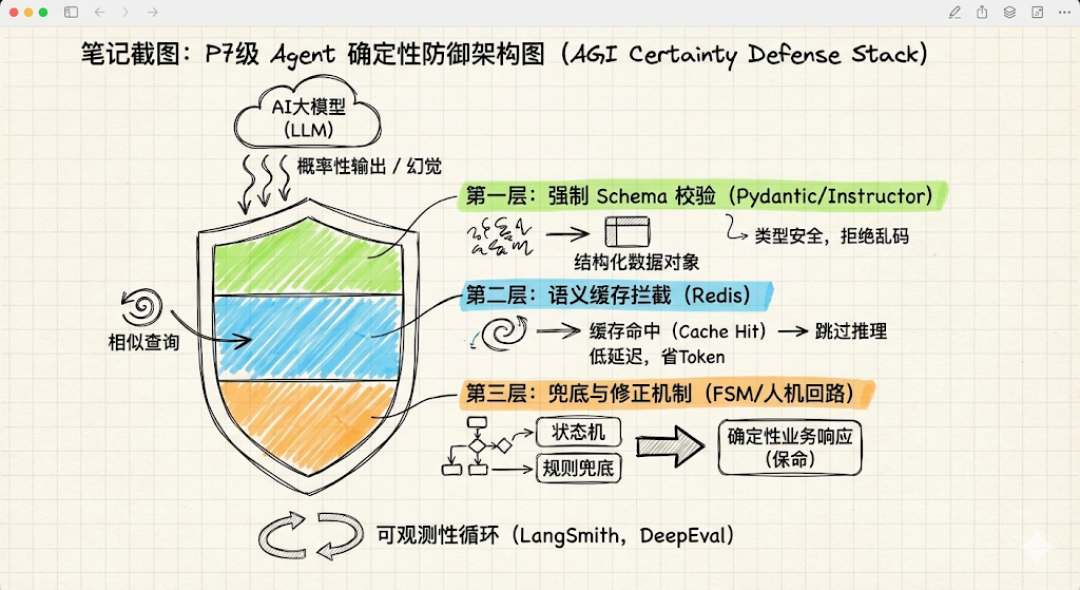
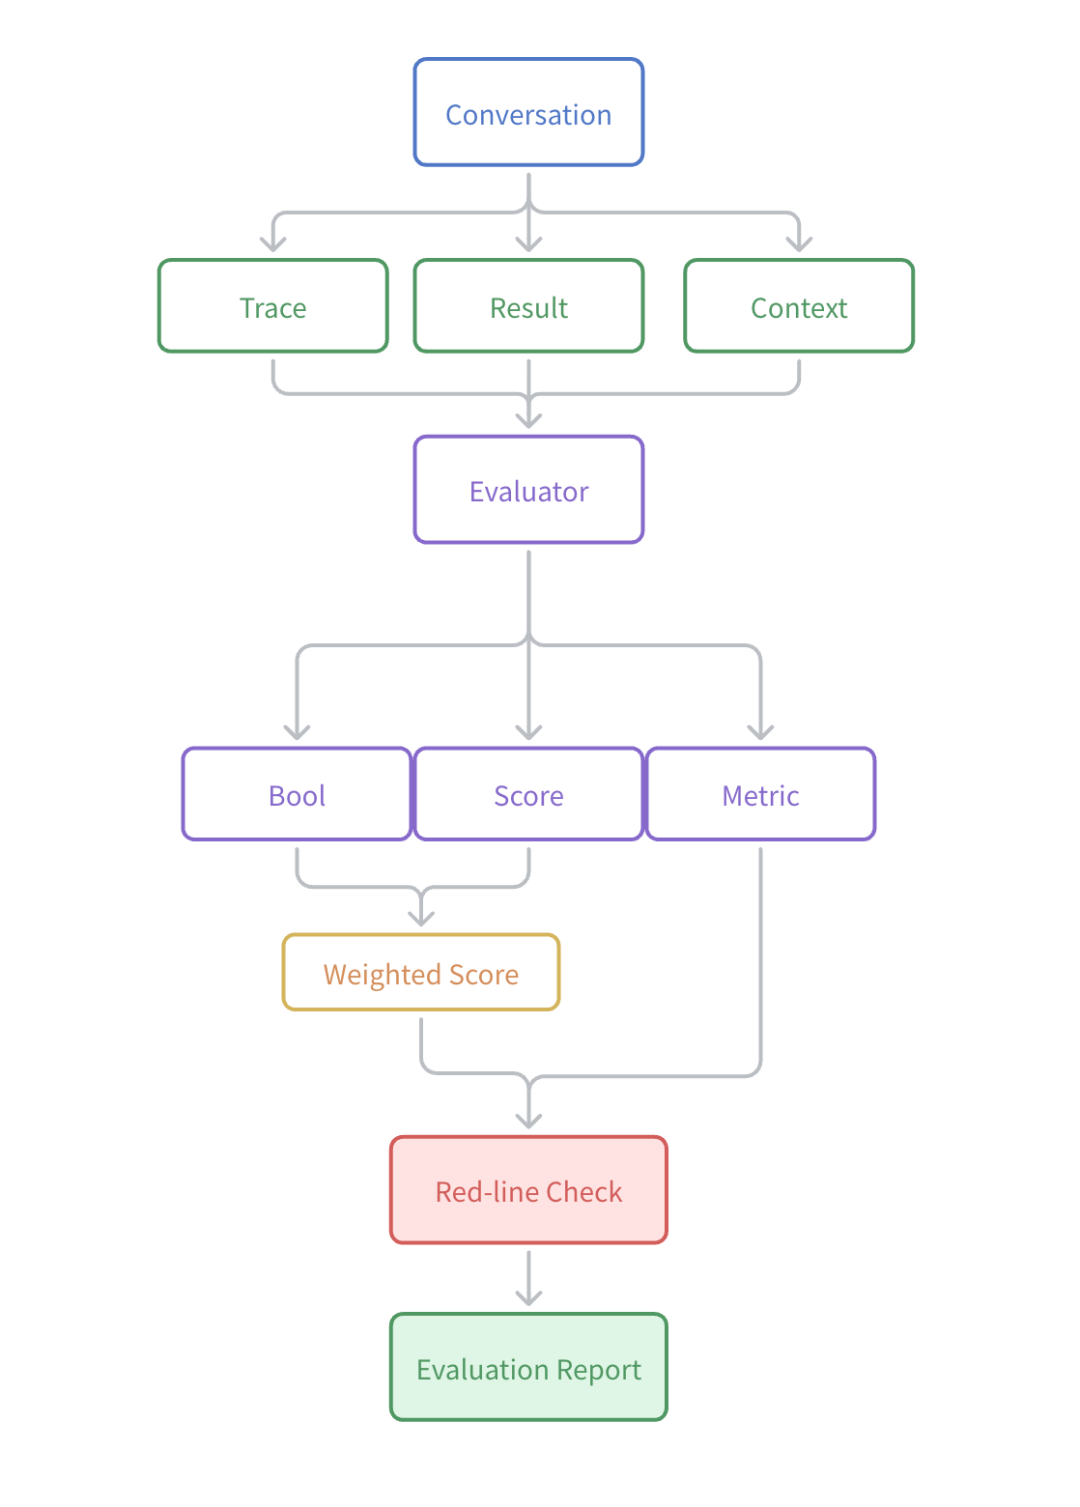
第二,分层断言。能客观判定的就别用模型judge:工具有没有调用、数据库里有没有那条记录、格式对不对,直接写死断言。语义质量(“这个回答好不好”)才交给LLM-as-judge,而且裁判本身要拿人工标注数据验证过误报漏报,不能写一段评分prompt就信它。特别警惕Agent说“任务完成”不等于真完成——它回复“已帮你创建好”,库里可能什么都没有,所以高风险动作要单独校验业务状态。知乎微博
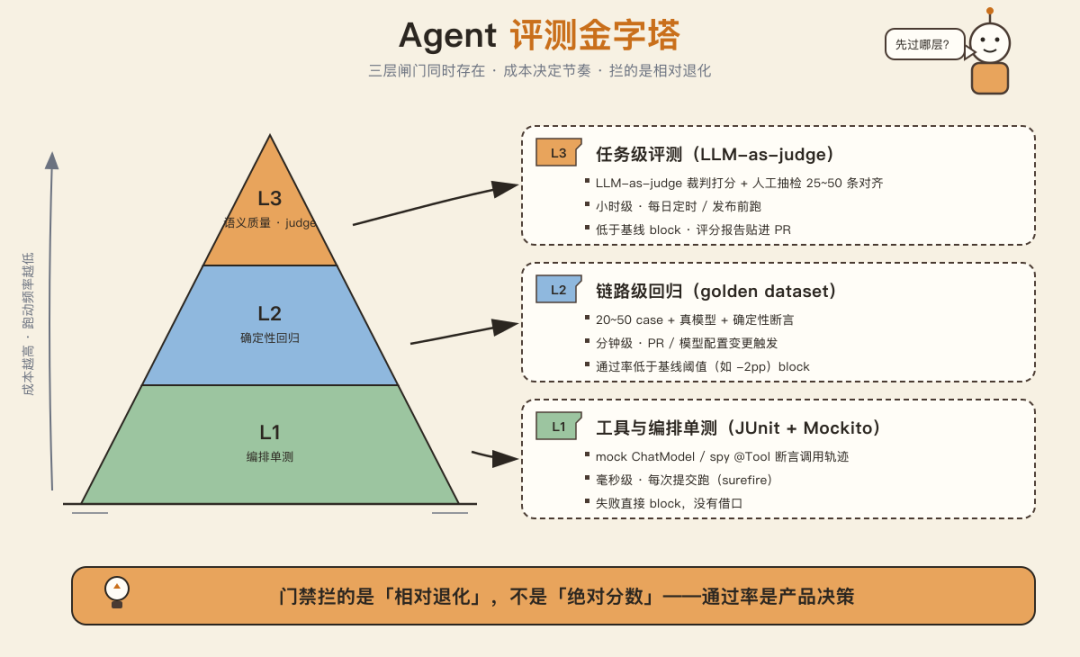
第三,门禁拦相对退化,不拦绝对分数。把评测跑进CI,分数比基线差就拦下合并。为什么不拦绝对分?模型天生有噪声,拿绝对分数当门槛,团队迟早会被逼着“为过门禁改case”。AI测试的通过率本来就是产品决策:你决定容忍哪些失败,而不是假装能消灭它们。知乎
评测的意义还在于对抗模型的“月抛”式更新。模型每更新一次,原来调好的流程就得重跑一遍,这笔成本很多人没算过。提示词会被下一版模型淘汰,但你的case集不会——它是随badcase复利的数据资产,谁也拿不走。落到行动上,两周足够起步:第一周把case和断言跑进CI,第二周上judge、锁基线。知乎知乎
最后交代边界:评测解决的是“测得出好坏”,解决不了上线时的权限和出错后的追责。有从业者把止损线定得很具体:单任务成功率低于85%的环节,别硬上Agent。即使过了这条线,能上线的Agent也往往先从只读场景切入。先给Agent装上尺子,再谈让它干活。知乎