

混元确认要扩大参数:小模型的高性价比路线没停,还在加产品
11月21日凌晨,腾讯首席AI科学家、混元大模型负责人姚顺雨率团队在Reddit开展了一场时长120分钟的AMA,回应全球开发者的各类问题。这是混元团队首次在开发者社区做公开问答,约120分钟里收到300多条留言、回答了近百个问题。被问到下一代Hy模型会不会扩到1.5万亿至2万亿参数时,团队给出了少见的明确回答:下一代Hy模型的规模肯定会进一步显著扩大。但把整场问答读完,这并不是对小模型的掉头——同一个场合,团队确认更小尺寸的Hy4-mini已经在路线图上。在混元这里,扩参数和小模型不是二选一,而是同时往前推的两端。金融界微博财经网36氪
扩参数,补的是能力上限,不是换路线
今年11月4日,腾讯混元发布最新一代大语言模型Hy4,Hy首次跻身最强开源模型之列;而从今年3月重建预训练算起,混元用了九个月走到这一步。AMA里最尖锐的问题是:字节跳动、Kimi等厂商已在推进3万亿甚至5万亿参数的超大模型,腾讯Hy系列仍停留在700B左右。团队的回答没有回避规模,也没有否定小模型——小尺寸模型成本更低,而且研发过程中还能学到更多、积累更多经验。与此同时,团队承认Hy4仍有提升空间,尤其是后训练:正在投入大规模强化学习优化Hy4,也计划训练更大规模的模型。知乎知乎财经网金融界
小模型路线,技术上和账本上都还没跑完
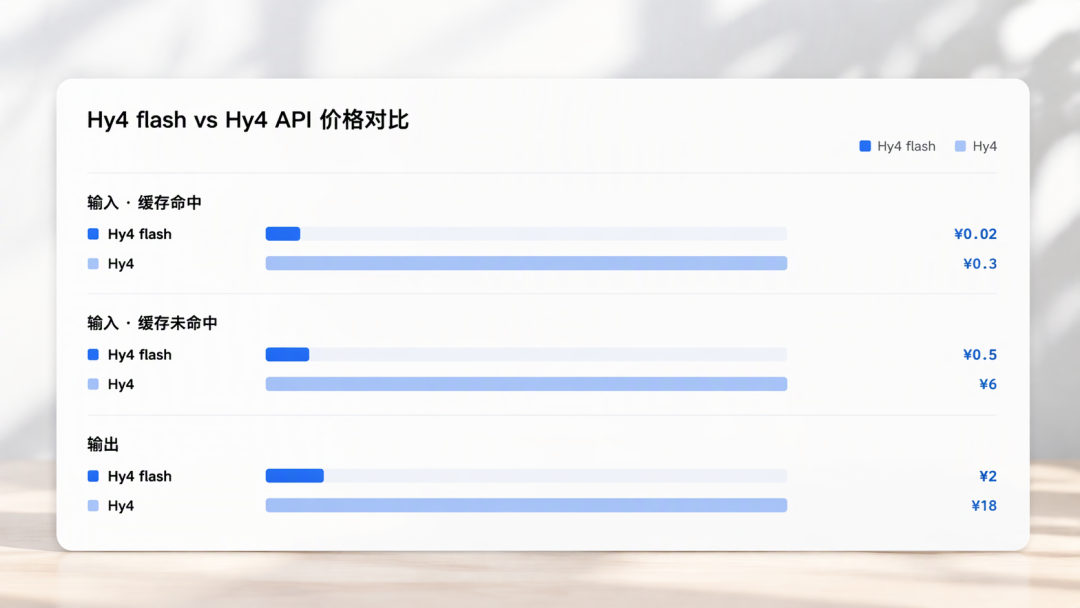
技术上,混元并不相信"MoE越稀疏越好":激活参数量本质上决定计算预算,削减激活就意味着更少的计算量,最终导致能力变弱。落到产品上,11月的节奏是更完整的证据链:11月16日发布的Hy4flash总参数224B、激活12B、支持多模态和1M上下文,API价格比旗舰大幅下调。每百万Token输入0.5元、输出2元,命中缓存只要0.02元,腾讯张军称之为迄今性价比最高的混元模型。单任务成本降到Hy4的约二十分之一。工程侧则把KV cache压到Hy4的六分之一、用自蒸馏和强化学习把端到端输出长度砍掉50%。权重开放也一路跟进:11月18日Hy4flash正式开放大模型权重。11月20日Hy4的指令版、FP8量化版和预训练基座三套权重也全部放出。市场反馈同样直接:Hy4flash一度冲上OpenRouter调用榜前列,不过这类对比多用新模型前期数据对标DeepSeek的单日快照,口径上需要留意。财经网AI前沿新闻未来图灵财经涂鸦PChome沐曦股份冰咖啡玄同科技
对用户意味着什么:两个确定信号
对开发者,这次AMA给出的最值得记的是边界和口径,而不是又一次参数竞赛。其一,团队表示仍会继续走开源路线。但Hy系列许可划了线:公司全球12个月营收超过5000万美元或产品月活超过1亿,大规模对外服务需要单独取得腾讯书面授权。也就是说,高性价比路线最先实惠到的是中小开发者和端侧场景。其二,路线图上明确有"不做"的部分:目前暂不打算发布100B以下针对编程优化的专用模型。而在移动端视觉Agent上,团队认为3B激活参数的模型已能承担超出简单OCR的截图和图表理解。财经网银龙聊AI金融界恋猫
所以"混元要训练更大模型"这个标题本身不构成转向。真正值得盯的下一步是三个可验证节点:Hy4-mini什么时候发布、24B至31B稠密模型是否落地,以及下一代旗舰参数实际扩到多大规模。只要这三个问题里任何一项有了答案,小模型高性价比路线的"继续"二字就从表态变成了事实。

当前文章无评论,是时候发表评论了