

点击上方蓝字关注我,加个🌟标不迷路。
各位小伙伴们大家好,我是 cxuan。
单弦不成音,独木不成林。
独木不成林,全是杨丞琳。
GLM 5.3 刚刚,发布了。
不过咱就是说,DeepSeek 和 GLM 这对儿着实有点意思。
之前是 GLM5.2 发完,DeepSeek 发新模型,这两天 DeepSeek 发完了,Harness 也发完了,今天 GLM 5.3 又来了。
你说这俩没点瓜葛,我着实有点不信。
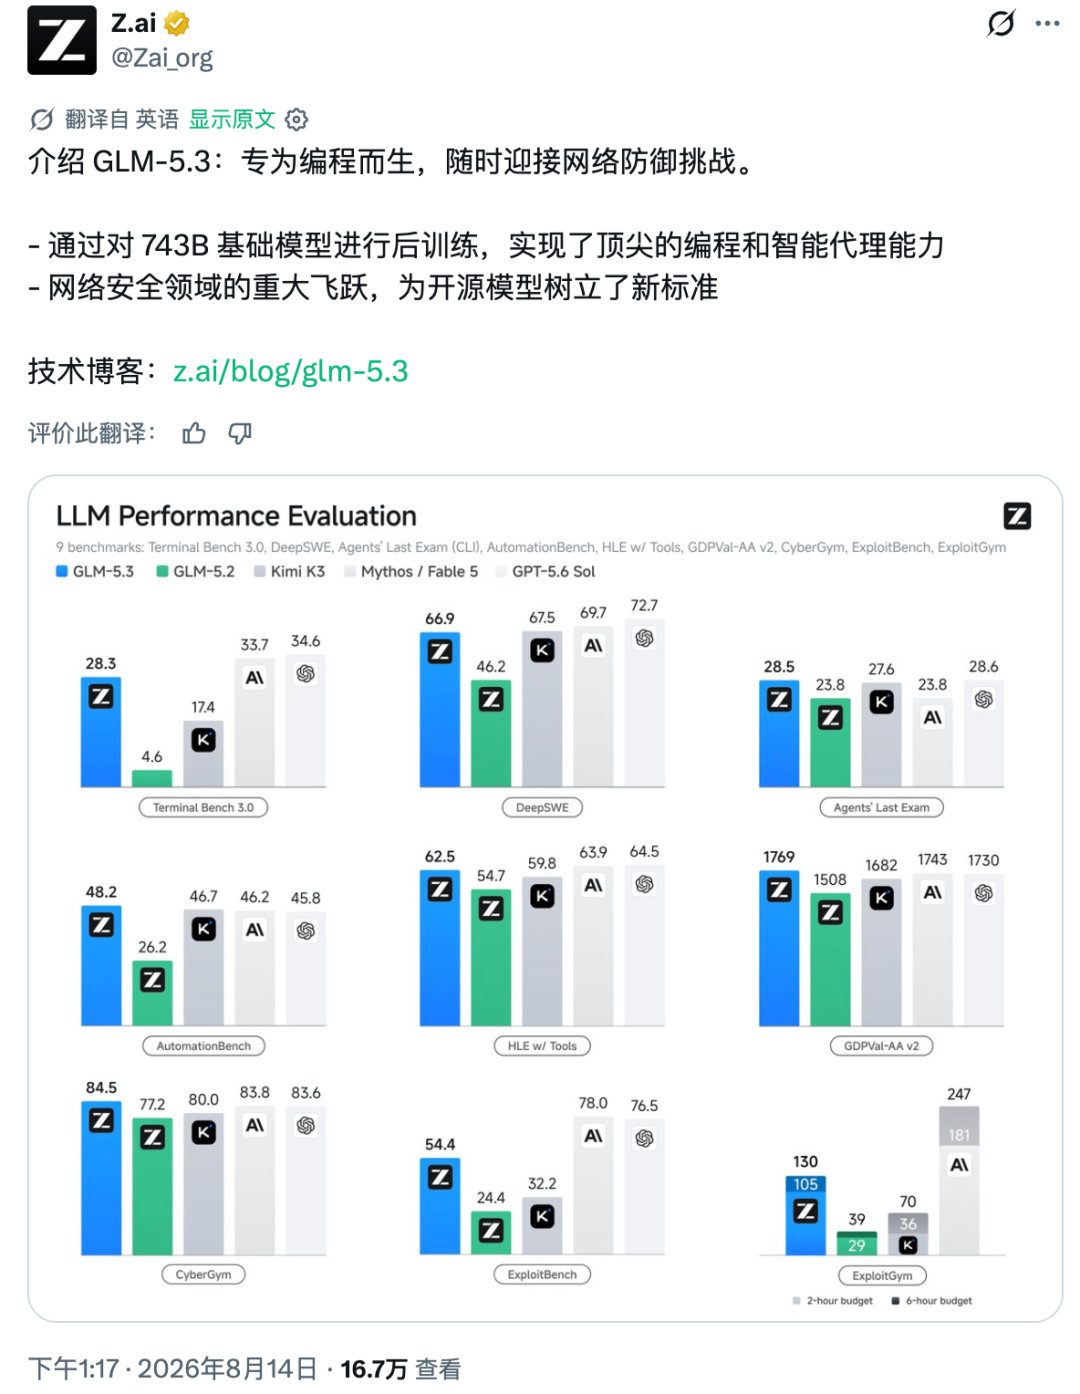 image-20260814135801794
GLM 5.3 相比于 GLM 5.2 相比,基座模型没变,但通过极致的后训练 Scaling 大大提高了模型的智能上界。
我记得 DeepSeek V4-Flash 也是做了后训练,难道后训练这么有效吗?
这次还真有效。
官方直接用了一句原话:
Scaling post-training is all we did for GLM-5.3.
GLM-5.3 用的还是 GLM-5.2 同一个基座,过去一个月主要在继续堆训练环境、任务种类和训练算力。
与 GLM 5.2 相比,GLM 5.3 在下面这些地方做了优化:
• 更强的编程能力
• 网络安全能力
• 强大的后训练 Scaling
• 开源
是的你没看错,GLM 5.3 是开源的,将在 8 月末的时候开放模型权重。
不过今天只是宣布了开放计划,权重还没放出来。官方说要先完成安全评估和加固,发布两周后再上,时间大概就是 8 月末。
现在 GLM 5.3 已经上线了 ZCode、TraeWork/TraeCode/扣子、WorkBuddy/CodeBuddy、Qoder/QwenWork、CatPaw、JoyCode、OpenCode 等编码平台开放抢先体验。
最重要的是:在 GLM 5.3 发布期间,GLM Coding Plan 全员额度重置了。
难道我们也要有国产的 Tibo 了吗?
API 参数也变了。
GLM-5.3 只保留 low、high、max 三档推理强度,默认是 max,编程任务官方也建议直接上 max。
分别来看下这几项能力的基准:
GLM 5.3 一句话非常炸裂,足以说明问题:
在多项主流基准测试中 GLM-5.3 是当前排名最高的开源模型,编程与智能体能力接近Claude Fable 5,编程体感超过其他国产模型。
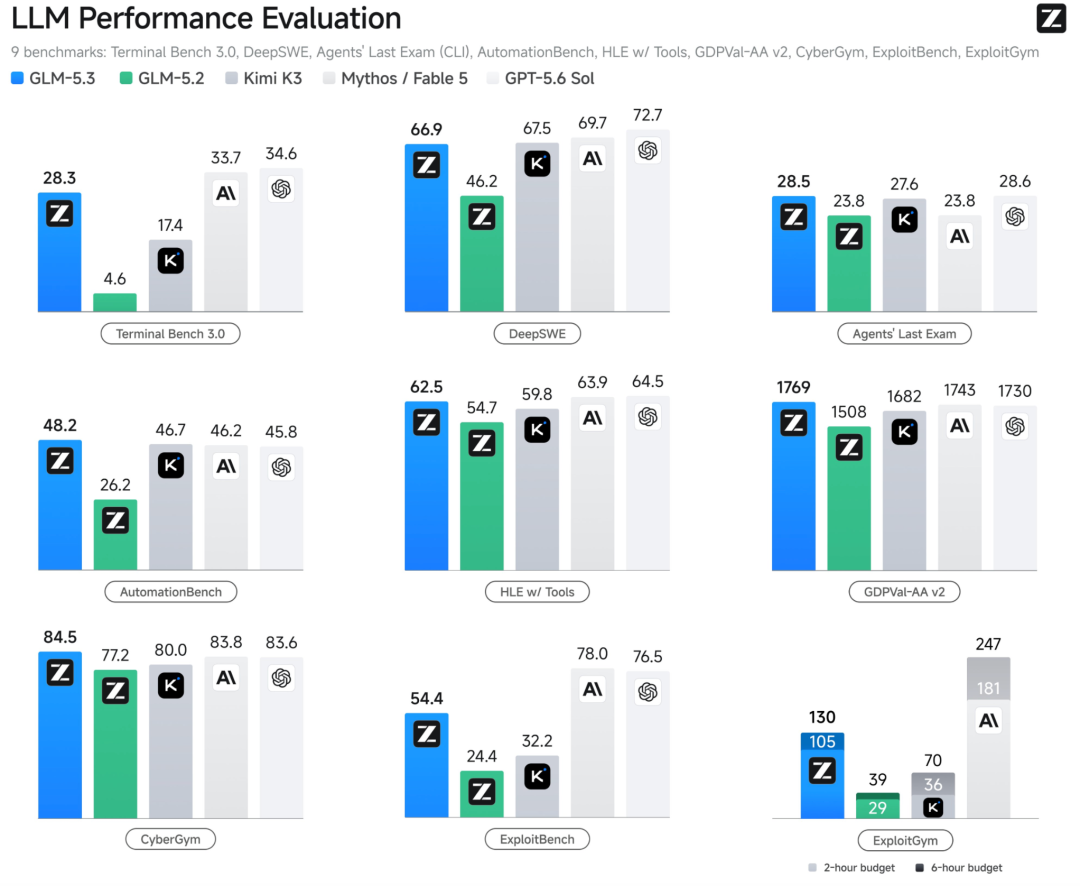
整体来看,GLM-5.3 在复杂软件工程、终端操作和更广泛的真实世界 Agent 任务上均取得非常显著的进步。
而且 GLM-5.3 搭载自家的 ZCode ,确实可以期待下了。
我感觉比 dsh + ds v4-pro 要强,因为隔壁确实这次有点拉。
不过基准这玩意儿,还是得一行一行看。
官方说“排名最高的开源模型”,指的是整体表现,不是每一项都排第一。Terminal Bench 2.1、DeepSWE、NL2Repo 和 Toolathlon 里,都有其他开源模型比它高。
完整测评如下:
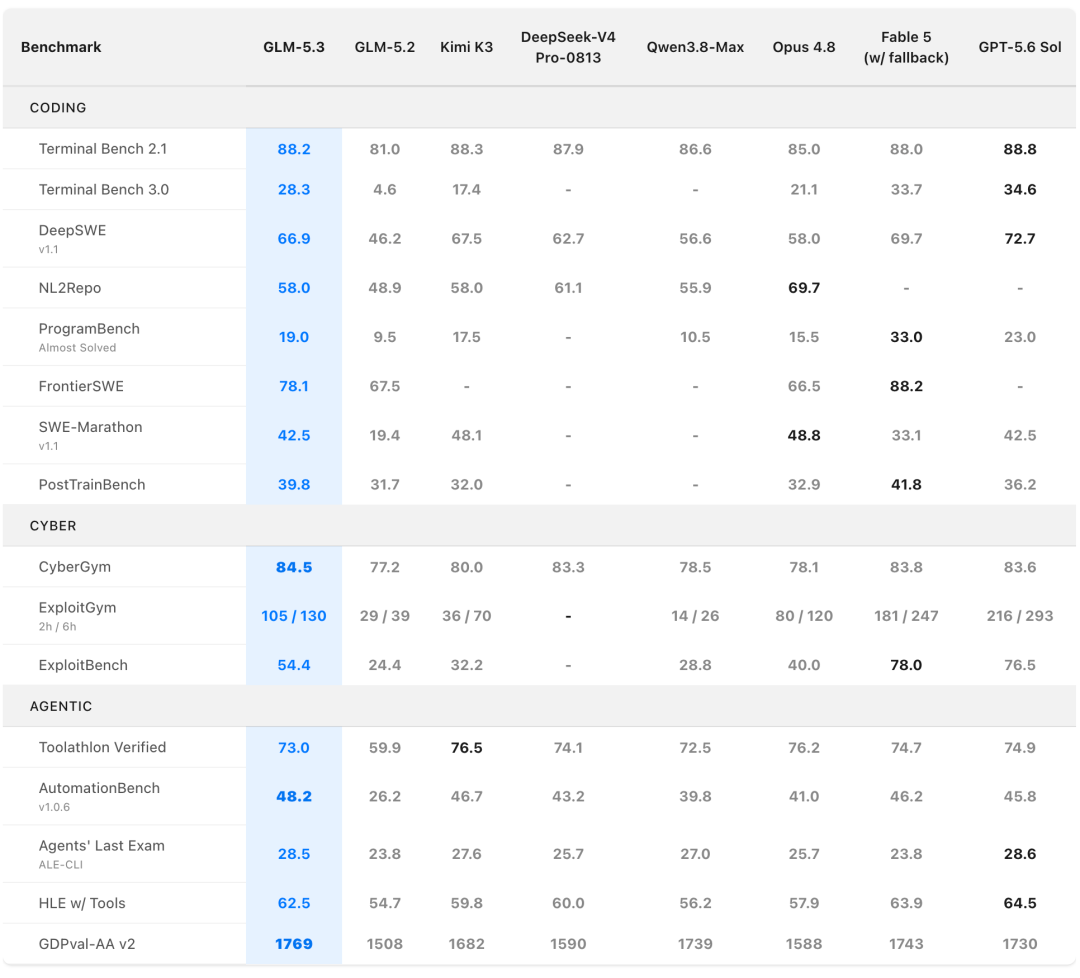 image-20260814141416723
Terminal Bench、DeepSWE、AutomationBench 可以理解成任务通过率;
ExploitGym 统计的是:拿到已知漏洞和触发样本后,模型能指定时间内,写出多少个真正可以执行攻击代码的 exploit;
GDPval-AA v2 拿到了 1769 分,而人类专家的基线是 1000 分。
Terminal Bench 测的是模型能不能在一个容器化终端里把任务做完。GLM-5.3 在 2.1 上是 88.2,和 Kimi K3 的 88.3、Fable 5 的 88.0、GPT-5.6 Sol 的 88.8 基本打平了。
到了更难的 Terminal Bench 3.0,GLM-5.3 是 28.3,GLM-5.2 只有 4.6。Kimi K3 是 17.4,Fable 5 和 GPT-5.6 Sol 分别是 33.7、34.6。
2.1 已经测不出真实水平了,然后到了 3.0 又把差距拉开了。
DeepSWE v1.1 测的是在一共 113 个原创的长周期软件工程任务下,题目不是直接从已经合并的 GitHub PR 里挖出来的,主要是为了减少训练数据污染。
GLM-5.3 是 66.9。Kimi K3 是 67.5,Fable 5 是 69.7,GPT-5.6 Sol 是 72.7。
NL2Repo 看的是从自然语言需求直接生成一个完整仓库。GLM-5.3 是 58.0,和 Kimi K3 一样,低于 DeepSeek-V4 Pro 的 61.1 和 Opus 4.8 的 69.7。
ProgramBench 这个测试更狠。它只给模型一个可执行二进制和说明文档,不给源码,也不允许反编译,让模型自己摸清程序行为,再从零写一个能通过隐藏测试的代码库。
GLM-5.3 的 Almost Solved 是 19.0,GLM-5.2 是 9.5,Fable 5 是 33.0。
另外几项也差不多。FrontierSWE 从 67.5 涨到 78.1,Fable 5 是 88.2;SWE-Marathon 从 19.4 涨到 42.5,Kimi K3 和 Opus 4.8 分别是 48.1、48.8;PostTrainBench 从 31.7 涨到 39.8,Fable 5 是 41.8。
PostTrainBench 测的甚至不是普通业务代码。它给 Agent 4 个小型基础模型、一张 H100 和 10 个小时,让 Agent 自己做后训练,再看最后训出来的模型到底咋样。
可以看出,GLM-5.3 这次主要涨的是长任务里的持续执行能力。
一次任务跑几个小时,期间要反复读仓库、改代码、跑测试、看结果,重复。
智谱这轮后训练,就是在增加这类长任务环境,让模型尽量别干到一半跑偏了。
下面这张图是智谱自建的 Z.ai Code Bench。
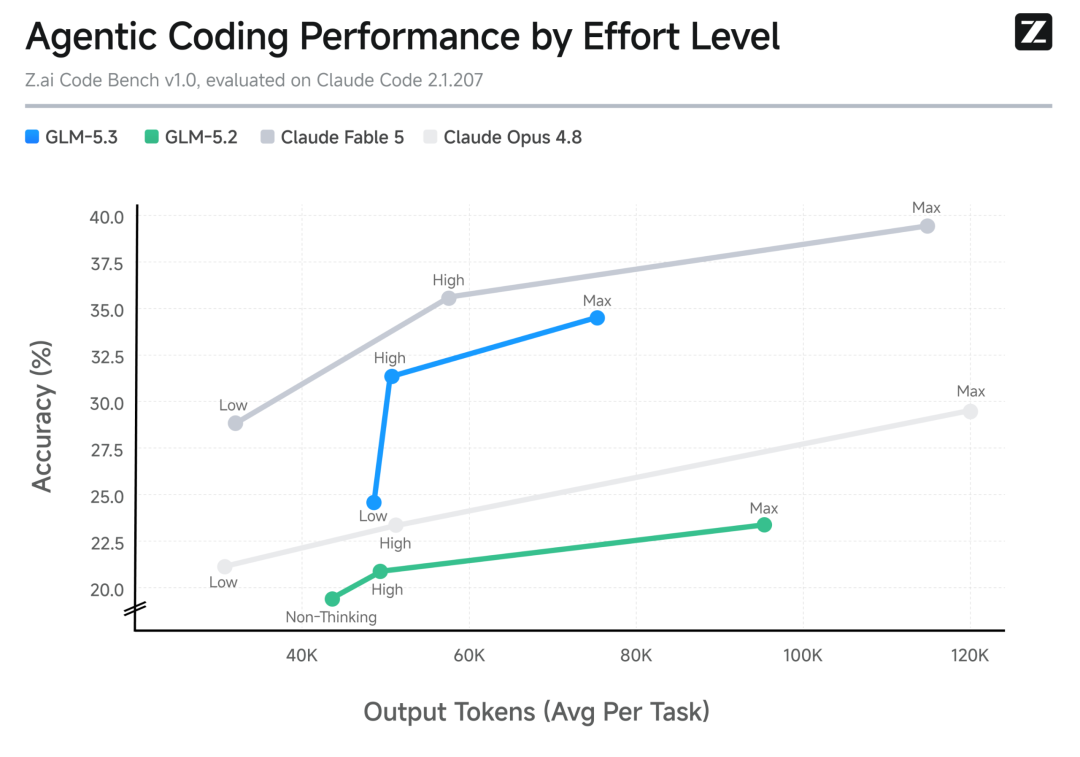 image-20260814140651194
GLM-5.3 在 max 档是 34.5%,平均每个任务输出大约 75K Token;GLM-5.2 是 23.4%,反而要输出大约 96K Token。
high 档的 GLM-5.3 是 31.4%,输出大约 50K Token;Opus 4.8 的 max 档是 29.5%,输出大约 120K。
Fable 5 还是更高,max 档是 39.5%。
所以这张图想表达的除了分数,还有 Token 效率。GLM-5.3 干同一类任务,输出比 5.2 少,完成率反而更高,token 利用率更高。
Toolathlon 会把 Agent 扔进带工具和 MCP 服务的环境里,让它连续处理**、表格、课程系统、网店这些多步任务。
GLM-5.3 是 73.0,GLM-5.2 是 59.9,Kimi K3 和 Opus 4.8 分别是 76.5、76.2。
AutomationBench 更像真实办公。它模拟 CRM、日历、**等 47 个 SaaS 工具,覆盖销售、营销、运营、客服、财务和 HR。所有状态检查都通过,一项任务才算完成。
GLM-5.3 在这里是 48.2,GLM-5.2 是 26.2,表里列出的 Kimi K3、Fable 5 和 GPT-5.6 Sol 也都在它后面。
Agents' Last Exam 测的是跨行业的真实工作任务,GLM-5.3 是 28.5,和 GPT-5.6 Sol 的 28.6 基本相同。
HLE with Tools 是那些跨数学、自然科学和人文学科的高难度题,只不过允许 Agent 使用工具。GLM-5.3 是 62.5,Fable 5 是 63.9,GPT-5.6 Sol 是 64.5。
GDPval-AA v2 测的是法律文书、工程图纸、表格、演示文稿这种职业交付物。GLM-5.3 拿到 1769,Qwen3.8-Max 是 1739,Fable 5 是 1743,GPT-5.6 Sol 是 1730。
然后就是这次的另外一个发力点就是网络安全能力。
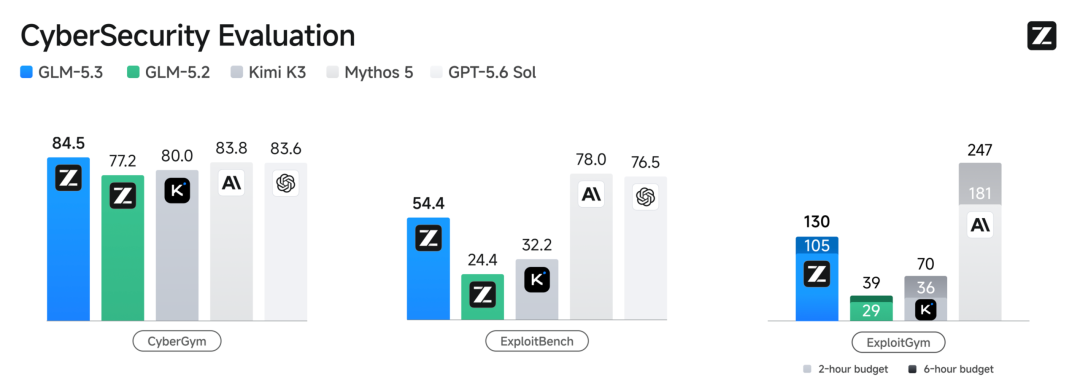 image-20260814141233611
这三项测试刚好对应三个阶段。
CyberGym 给模型白盒源码,让它找到漏洞,再通过触发故障来验证。GLM-5.3 是 84.5%,GLM-5.2 是 77.2,Fable 5 是 83.8,GPT-5.6 Sol 是 83.6。这一项 GLM-5.3 是表里最高的。
ExploitBench 检查模型能不能到达漏洞代码、触发漏洞,最后做到任意代码执行。
GLM-5.3 从 24.4 涨到 54.4,确实翻了一倍多。不过 Fable 5 是 78.0,GPT-5.6 Sol 是 76.5,差距还是比较明显。
ExploitGym 更狠,直接给漏洞、触发样本和容器环境,让 Agent 写出能拿到未授权代码执行的完整 exploit。
869 个任务里,GLM-5.3 在 2 小时预算内完成 105 个,6 小时内完成 130 个;GLM-5.2 分别是 29 和 39。
Fable 5 是 181 和 247,GPT-5.6 Sol 是 216 和 293。
所以 GLM-5.3 现在找漏洞、复现漏洞这块已经很强了,但跟 Fable 5 和 GPT-5.6 Sol 还有点差距。
智谱还把模型放进了真实代码库里跑。
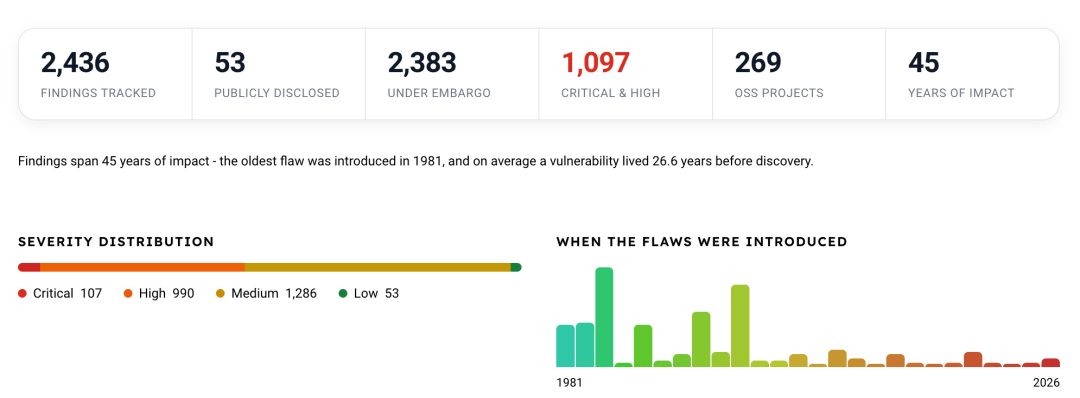 image-20260814141327476
从 GLM-5.2 开始,经过安全团队审核、筛选和去重,一共发现了 2436 个漏洞,覆盖 269 个开源项目。
里面有严重漏洞 107 个、高危 990 个、中危 1286 个、低危 53 个。
目前公开披露了 53 个,还有 2383 个处在披露流程里。最早的漏洞可以追溯到 1981 年,平均潜伏长达 26.6 年。
智谱还专门做了一个 Security Disclosure Ledger,也就是漏洞披露账本。已经公开的漏洞会列出受影响项目、严重程度、CVE 和潜伏时间,剩下的要等项目方修复之后再披露。
这次 GLM-5.3 没换基座,也没讲什么新架构故事,就是沿着 GLM-5.2 的基模做了大量后训练。
然后 Terminal Bench 3.0 从 4.6 涨到 28.3,DeepSWE 从 46.2 涨到 66.9,AutomationBench 从 26.2 涨到 48.2,ExploitBench 从 24.4 涨到 54.4。
后训练这玩意儿,还真让他们整明白了。
不过榜单归榜单,我还是想试试 GLM-5.3 在 ZCode 里用一波,再看看实际体感到底如何。
至少,应该不会比隔壁还拉吧。
如果这篇文章你觉得还不错,谢谢你的三连,也希望可以转发给同样关注 AI / 科技 / 开发效率的朋友。 我是 cxuan,我们下期再见。
相关 URL:
GLM-5.3 官方博客:https://z.ai/blog/glm-5.3
GLM-5.2 官方博客:https://z.ai/blog/glm-5.2
GLM-5.2 模型配置:https://huggingface.co/zai-org/GLM-5.2/blob/main/config.json
DeepSWE:https://deepswe.datacurve.ai/
ProgramBench:https://programbench.com/
AutomationBench:https://github.com/zapier/AutomationBench
ExploitGym:https://www.cybergym.io/exploitgym/
Z.ai Security 披露账本:https://cvd.z.ai/
当前文章无评论,是时候发表评论了